
68 KiB
Executable File
VideoX-Fun
😊 Welcome!
CogVideoX-Fun:

Wan-Fun:
目录
一、简介
VideoX-Fun是一个图片与视频生成的pipeline,可用于生成AI图片与视频、训练Diffusion Transformer的基线模型与Lora模型。我们同时支持视频与图片两类Diffusion Transformer模型:视频侧涵盖Wan2.1/Wan2.2(含Fun、VACE、Animate、S2V等变体)、CogVideoX-Fun、HunyuanVideo、MiniMax-H3、LTX-2、LongCat-Video、FantasyTalking与LingBot等,图片侧涵盖Qwen-Image(含Edit)、Z-Image(含Turbo)、Flux/Flux2与ERNIE-Image等,完整列表见已支持的模型。在此基础上,我们支持从已经训练好的基线模型直接进行预测,生成不同分辨率、不同秒数、不同FPS的视频与不同分辨率的图片,也支持用户训练自己的基线模型与Lora模型,进行一定的风格变换。
二、快速开始与使用
1. 环境准备
1.1 云使用: AliyunDSW
DSW 有免费 GPU 时间,用户可申请一次,申请后3个月内有效。
阿里云在Freetier提供免费GPU时间,获取并在阿里云PAI-DSW中使用,5分钟内即可启动VideoX-Fun。
1.2 本地依赖安装
我们已验证该库可在以下环境中执行:
Windows 的详细信息:
- 操作系统 Windows 10
- python: python3.10 & python3.11
- pytorch: torch2.2.0
- CUDA: 11.8 & 12.1
- CUDNN: 8+
- GPU: Nvidia-3060 12G & Nvidia-3090 24G
Linux 的详细信息:
- 操作系统 Ubuntu 20.04, CentOS
- python: python3.10 & python3.11
- pytorch: torch2.2.0
- CUDA: 11.8 & 12.1
- CUDNN: 8+
- GPU:Nvidia-V100 16G & Nvidia-A10 24G & Nvidia-A100 40G & Nvidia-A100 80G & Nvidia-H800 80G
方式一:使用requirements.txt
pip install -r requirements.txt
方式二:手动安装依赖
# 核心依赖,与requirements.txt保持一致
pip install Pillow einops safetensors timm tomesd albumentations librosa "torch>=2.1.2" torchdiffeq torchsde decord datasets numpy scikit-image
pip install omegaconf SentencePiece imageio[ffmpeg] imageio[pyav] tensorboard beautifulsoup4 ftfy func_timeout onnxruntime
pip install "peft>=0.17.0" "accelerate>=0.25.0" "gradio>=3.41.2" "diffusers>=0.30.1" "transformers>=4.46.2"
# 权重下载
pip install modelscope
# 多卡并行推理需要,推荐固定版本,单卡可跳过
pip install "xfuser==0.4.2"
# opencv统一使用headless版本,避免部分环境下的GUI依赖
pip uninstall opencv-python opencv-contrib-python opencv-python-headless -y
pip install opencv-python-headless
# 训练可选:DeepSpeed训练需要,固定numpy版本以避免兼容性问题
pip install deepspeed==0.17.0 numpy==1.26.4
# 加速可选:安装后注意力自动使用Flash Attention后端,未安装时回退到SDPA
pip install flash-attn --no-build-isolation
说明:
torch与flash-attn建议按照本机的CUDA版本从官方渠道安装指定版本,国内网络可追加-i https://mirrors.aliyun.com/pypi/simple/加速,具体依赖请以requirements.txt为准。
1.3 使用Docker
使用docker的情况下,请保证机器中已经正确安装显卡驱动与CUDA环境,然后以此执行以下命令:
# pull image
docker pull mybigpai-public-registry.cn-beijing.cr.aliyuncs.com/easycv/torch_cuda:cogvideox_fun

# enter image
docker run -it -p 7860:7860 --network host --gpus all --security-opt seccomp:unconfined --shm-size 200g mybigpai-public-registry.cn-beijing.cr.aliyuncs.com/easycv/torch_cuda:cogvideox_fun

# clone code
git clone https://github.com/aigc-apps/VideoX-Fun.git

# enter VideoX-Fun's dir
cd VideoX-Fun
1.4 权重放置
我们最好将权重按照指定路径进行放置:
运行自身的python文件或ui界面:
📦 models/
├── 📂 Diffusion_Transformer/
│   ├── 📂 CogVideoX-Fun-V1.1-2b-InP/
│   ├── 📂 CogVideoX-Fun-V1.1-5b-InP/
│   ├── 📂 Wan2.1-Fun-V1.1-14B-InP
│   ├── 📂 Wan2.1-Fun-V1.1-1.3B-InP/
│   ├── 📂 Z-Image/
│   └── 📂 Qwen-Image/
├── 📂 Personalized_Model/
│   └── your trained trainformer model / your trained lora model (for UI load)
视频模型与图片模型的权重均统一放在models/Diffusion_Transformer/下,文件夹名与已支持的模型中的权重名保持一致。
通过comfyui:
将模型放入Comfyui的权重文件夹ComfyUI/models/Fun_Models/:
📦 ComfyUI/
├── 📂 models/
│   └── 📂 Fun_Models/
│       ├── 📂 CogVideoX-Fun-V1.1-2b-InP/
│       ├── 📂 CogVideoX-Fun-V1.1-5b-InP/
│       ├── 📂 Wan2.1-Fun-V1.1-14B-InP
│       └── 📂 Wan2.1-Fun-V1.1-1.3B-InP/
2. 推理生成
视频模型与图片模型的推理入口完全一致,均由examples/{model_name}/下的脚本或界面提供,模型清单见已支持的模型。
2.1 入口选择
| 使用入口 | 适合场景 | 可配置粒度 |
|---|---|---|
| python文件 | 批量生成、参数写在脚本里调试 | 全量参数,含GPU_memory_mode、transformer_path、lora_path |
| webui | 交互体验、快速切换模型 | 常见参数,显存方案仅4档,见2.2 |
| ComfyUI | 已有ComfyUI工作流、节点化组合 | 节点参数,权重放置见1.5 |
2.2 显存节省方案
基线模型的参数量普遍很大,为适应消费级显卡,每个预测文件都提供了GPU_memory_mode,视频模型与图片模型通用。可选项按省显存程度从高到低排列,与代码中的判断顺序一致:
- sequential_cpu_offload:模型的每一层在使用后会进入cpu,速度较慢,节省大量显存。
- model_group_offload:以leaf层级在cpu与gpu之间搬运权重,并借助stream异步预取,兼顾速度与显存。
- model_cpu_offload_and_qfloat8:整个模型在使用后会进入cpu,并且对transformer模型进行了float8的量化,可以节省更多的显存。
- model_cpu_offload:整个模型在使用后会进入cpu,可以节省部分显存。
- model_full_load_and_qfloat8:模型常驻gpu,仅对transformer做float8量化,显存临界且对速度要求较高时可选。
- 默认(传入model_full_load或其他取值):模型全部进入gpu,速度最快,显存需求最高。
qfloat8会部分降低模型的性能,但可以节省更多的显存。如果显存足够,推荐使用model_cpu_offload。
注意:
app.py中仅提供model_full_load、model_cpu_offload、model_cpu_offload_and_qfloat8、sequential_cpu_offload四种模式,model_group_offload与model_full_load_and_qfloat8需在python预测文件中使用;另外compile类加速与sequential_cpu_offload、fsdp_dit不兼容。
2.3 通过python文件
推理脚本统一命名为predict_{任务}.py,在脚本内修改model_name、prompt等参数后直接运行,结果保存到脚本中save_path指定的目录。视频模型与图片模型的差别只在任务后缀,例如examples/cogvideox_fun/predict_t2v.py、examples/wan2.2_fun/predict_i2v.py与examples/z_image/predict_t2i.py、examples/qwenimage/predict_t2i_edit.py。具体某个模型支持哪些任务,以examples/{model_name}/下实际存在的脚本为准。
i、单卡运行:以CogVideoX-Fun为例。
- 步骤1:下载对应权重并按1.5放入models文件夹。
- 步骤2:根据不同的权重与预测目标使用不同的文件进行预测。
- 文生视频:
- 使用examples/cogvideox_fun/predict_t2v.py文件中修改prompt、neg_prompt、guidance_scale和seed。
- 而后运行examples/cogvideox_fun/predict_t2v.py文件,等待生成结果,结果保存在samples/cogvideox-fun-videos-t2v文件夹中。
- 图生视频:
- 使用examples/cogvideox_fun/predict_i2v.py文件中修改validation_image_start、validation_image_end、prompt、neg_prompt、guidance_scale和seed。
- validation_image_start是视频的开始图片,validation_image_end是视频的结尾图片。
- 而后运行examples/cogvideox_fun/predict_i2v.py文件,等待生成结果,结果保存在samples/cogvideox-fun-videos_i2v文件夹中。
- 视频生视频:
- 使用examples/cogvideox_fun/predict_v2v.py文件中修改validation_video、validation_image_end、prompt、neg_prompt、guidance_scale和seed。
- validation_video是视频生视频的参考视频。您可以使用以下视频运行演示:演示视频
- 而后运行examples/cogvideox_fun/predict_v2v.py文件,等待生成结果,结果保存在samples/cogvideox-fun-videos_v2v文件夹中。
- 普通控制生视频(Canny、Pose、Depth等):
- 使用examples/cogvideox_fun/predict_v2v_control.py文件中修改control_video、validation_image_end、prompt、neg_prompt、guidance_scale和seed。
- control_video是控制生视频的控制视频,是使用Canny、Pose、Depth等算子提取后的视频。您可以使用以下视频运行演示:演示视频
- 而后运行examples/cogvideox_fun/predict_v2v_control.py文件,等待生成结果,结果保存在samples/cogvideox-fun-videos_control文件夹中。
- 文生视频:
- 步骤3:如果想结合自己训练的其他backbone与Lora,则在对应的
examples/{model_name}/predict_*.py中设置transformer_path与lora_path(Wan2.2双 Transformer模型另有transformer_high_path与lora_high_path,分别对应high noise阶段)。
ii、多卡运行:
多卡并行推理所需的xfuser已列入1.3,推荐固定为xfuser==0.4.2。
请确保ulysses_degree和ring_degree的乘积等于使用的GPU数量。例如,如果您使用8个GPU,则可以设置ulysses_degree=2和ring_degree=4,也可以设置ulysses_degree=4和ring_degree=2。
ulysses_degree是在head进行切分后并行生成,ring_degree是在sequence上进行切分后并行生成。ring_degree相比ulysses_degree有更大的通信成本,在设置参数时需要结合序列长度和模型的head数进行设置。
以8卡并行预测为例。
- 以Wan2.1-Fun-V1.1-14B-InP为例,其head数为40,ulysses_degree需要设置为其可以整除的数如2、4、8等。因此在使用8卡并行预测时,可以设置ulysses_degree=8和ring_degree=1.
- 以Wan2.1-Fun-V1.1-1.3B-InP为例,其head数为12,ulysses_degree需要设置为其可以整除的数如2、4等。因此在使用8卡并行预测时,可以设置ulysses_degree=4和ring_degree=2.
设置完成后,使用如下指令进行并行预测:
torchrun --nproc-per-node=8 examples/wan2.1_fun/predict_t2v.py
2.4 通过ui界面
webui支持文生视频、图生视频、视频生视频和普通控制生视频(Canny、Pose、Depth等)。当前提供app.py的是CogVideoX-Fun、Wan2.1、Wan2.1-Fun、Wan2.2、Wan2.2-Fun(界面实现位于videox_fun/ui/),其余模型(包含图片模型)请使用python文件进行预测。以CogVideoX-Fun为例。
- 步骤1:下载对应权重并按1.5放入models文件夹。
- 步骤2:运行examples/cogvideox_fun/app.py文件,进入gradio页面。
- 步骤3:根据页面选择生成模型,填入prompt、neg_prompt、guidance_scale和seed等,点击生成,等待生成结果,结果保存在sample文件夹中。
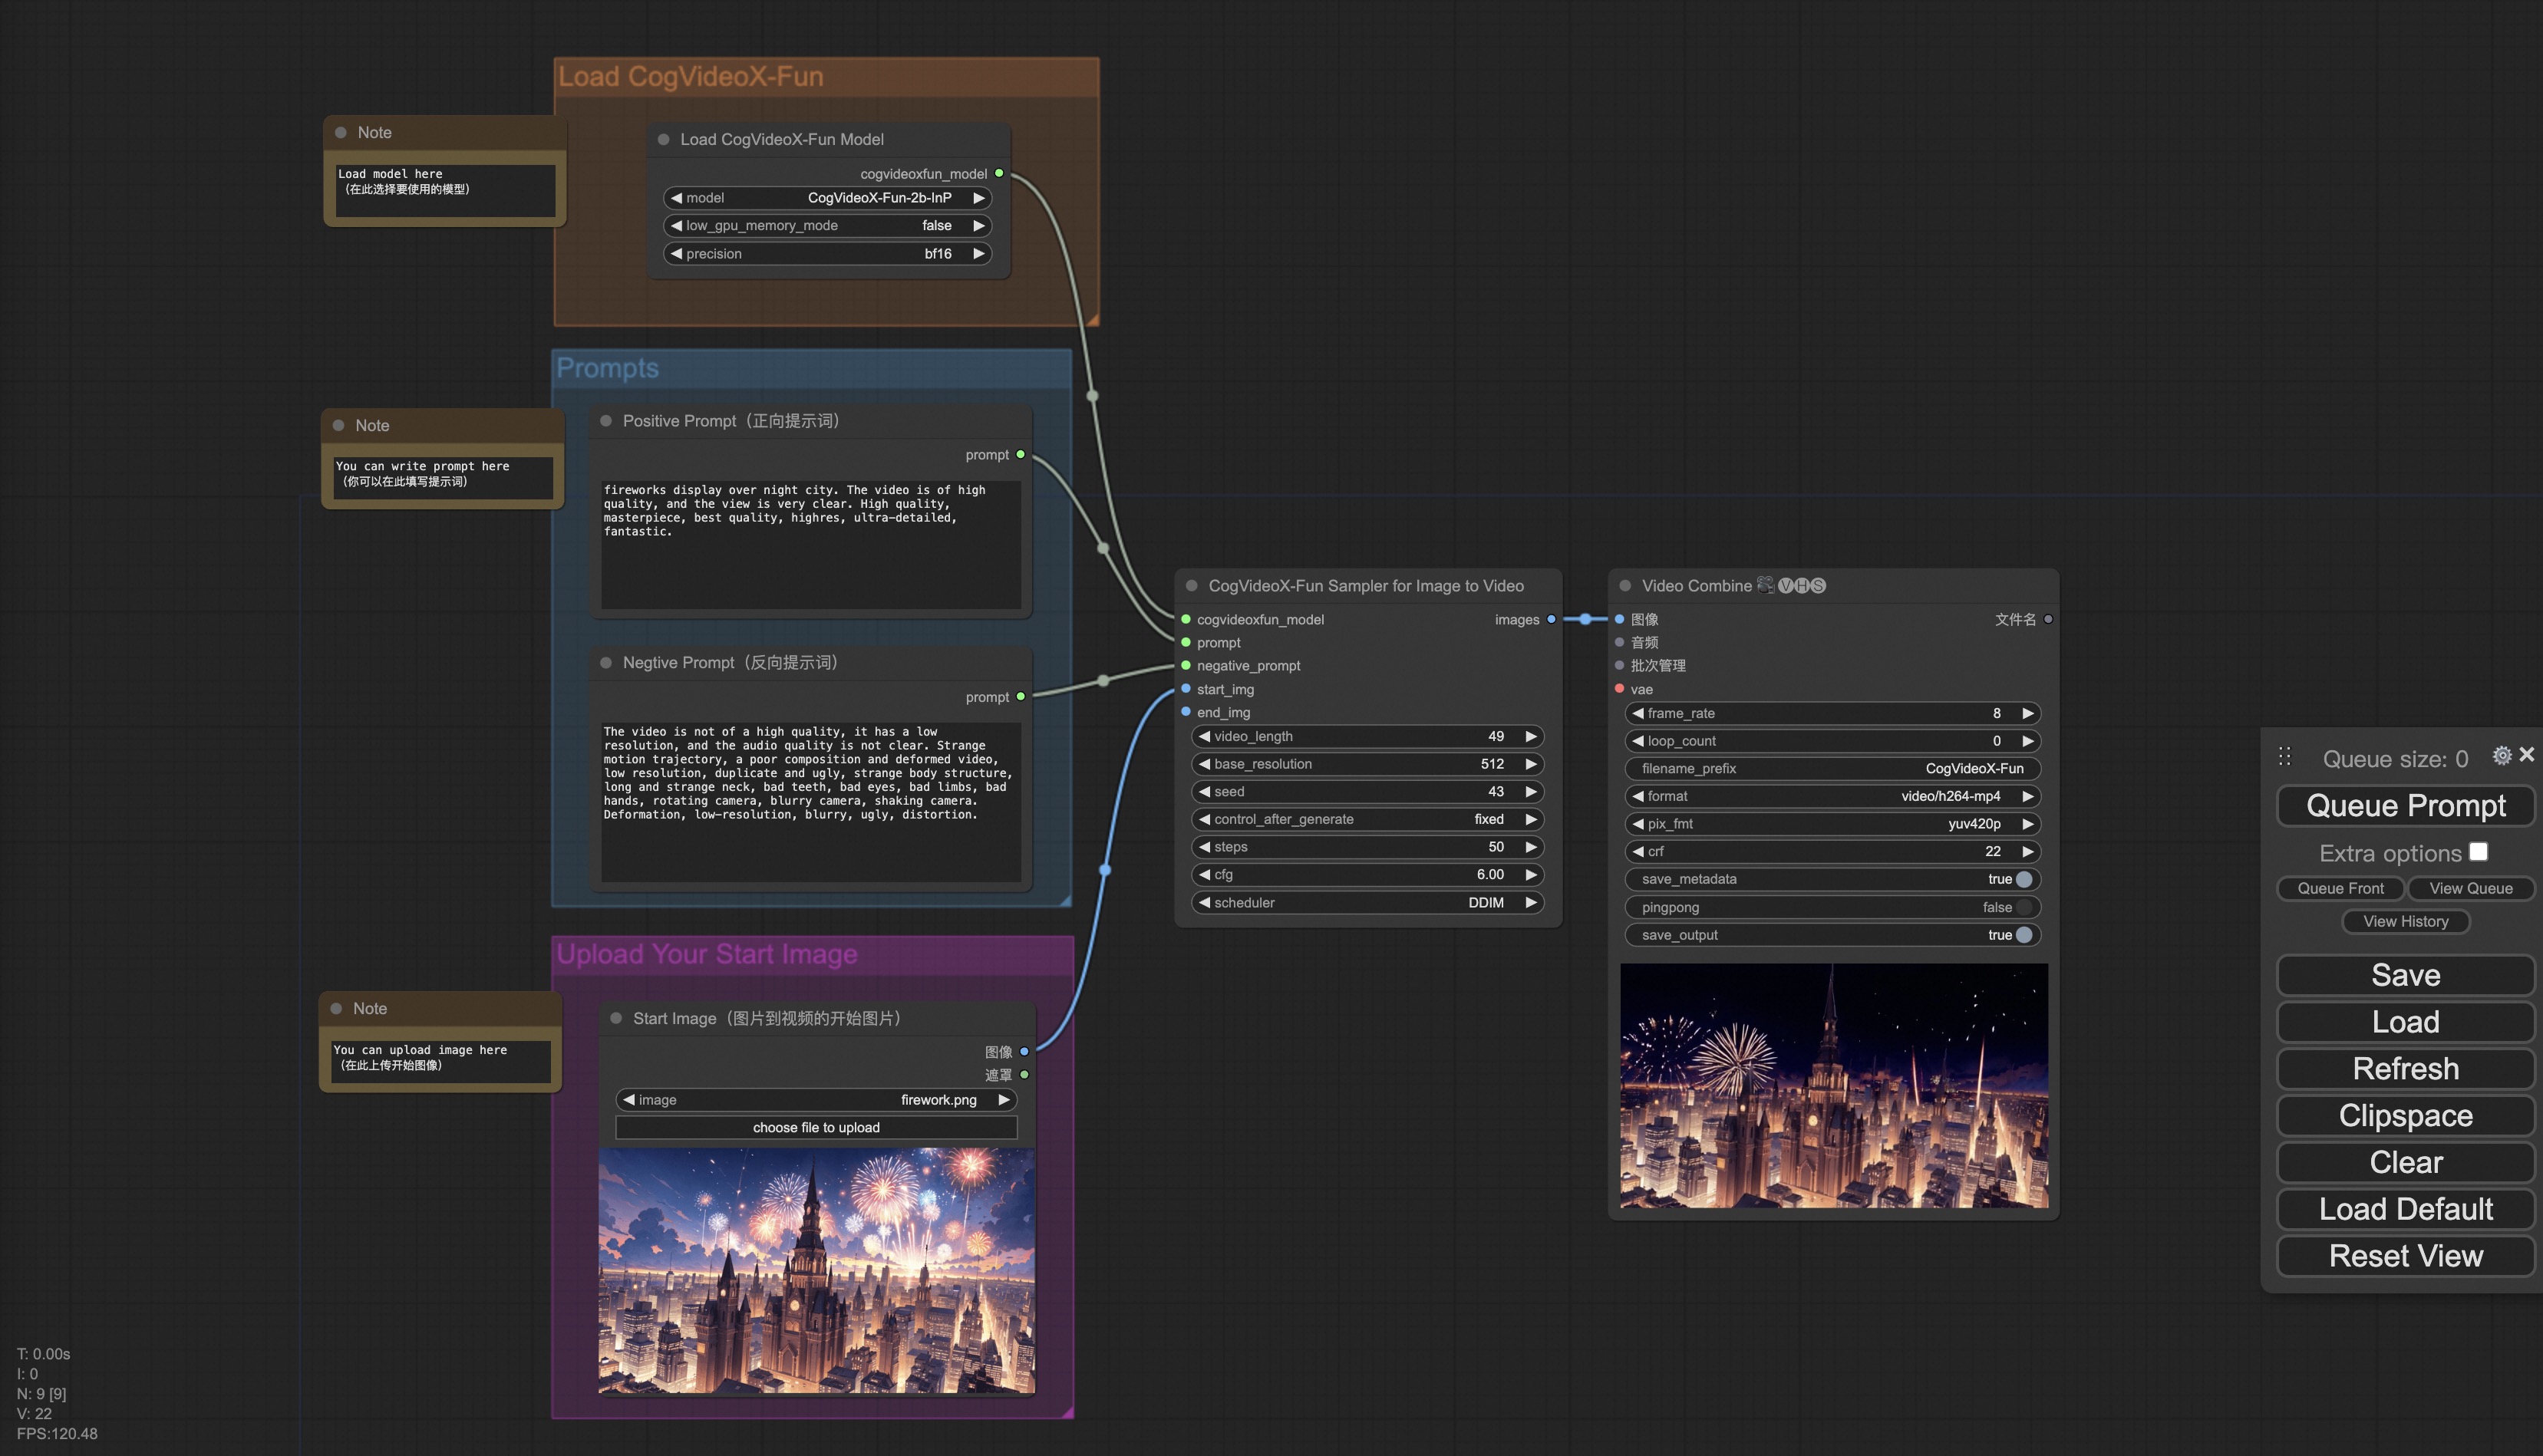
2.5 通过ComfyUI
具体查看ComfyUI README,我们的ComfyUI界面如下:
3. 模型训练
一个完整的模型训练链路应该包括数据预处理和Video DiT训练。不同模型的训练流程类似,数据格式也类似。
3.1 数据预处理
各模型的 LoRA 训练文档统一放在 scripts/{model_name}/ 下,中文版以 _zh-CN 结尾,详情见3.3 各模型训练文档。
一个完整的长视频切分、清洗、描述的数据预处理链路可以参考video caption部分的README进行。
如果期望训练一个文生图视频的生成模型,您需要以这种格式排列数据集。
📦 project/
├── 📂 datasets/
│   ├── 📂 internal_datasets/
│       ├── 📂 train/
│       │   ├── 📄 00000001.mp4
│       │   ├── 📄 00000002.jpg
│       │   └── 📄 .....
│       └── 📄 json_of_internal_datasets.json
json_of_internal_datasets.json是一个标准的json文件。json中的file_path可以被设置为相对路径,如下所示:
[
    {
      "file_path": "train/00000001.mp4",
      "text": "A group of young men in suits and sunglasses are walking down a city street.",
      "type": "video"
    },
    {
      "file_path": "train/00000002.jpg",
      "text": "A group of young men in suits and sunglasses are walking down a city street.",
      "type": "image"
    },
    .....
]
你也可以将路径设置为绝对路径:
[
    {
      "file_path": "/mnt/data/videos/00000001.mp4",
      "text": "A group of young men in suits and sunglasses are walking down a city street.",
      "type": "video"
    },
    {
      "file_path": "/mnt/data/train/00000001.jpg",
      "text": "A group of young men in suits and sunglasses are walking down a city street.",
      "type": "image"
    },
    .....
]
3.2 Video DiT训练
各模型的训练脚本与启动sh均位于scripts/{model_name}/下,sh的命名随任务而变,如train.sh、train_lora.sh、train_control.sh、train_control_distill.sh等,以目录内实际文件为准。
如果数据预处理时,数据的格式为相对路径,则进入对应的scripts/{model_name}/train.sh进行如下设置。
export DATASET_NAME="datasets/internal_datasets/"
export DATASET_META_NAME="datasets/internal_datasets/json_of_internal_datasets.json"
如果数据的格式为绝对路径,则在同一个脚本中设置如下(此时DATASET_NAME置空,不再拼接数据集目录前缀)。
export DATASET_NAME=""
export DATASET_META_NAME="/mnt/data/json_of_internal_datasets.json"
最后运行对应的脚本。
sh scripts/{model_name}/train.sh
3.3 各模型训练文档
关于参数设置细节,各模型的训练文档统一放在scripts/{model_name}/下,README_TRAIN*为基线训练,README_TRAIN_LORA*为LoRA训练,README_TRAIN_CONTROL*为控制训练,中文版以_zh-CN结尾。常用模型如下:
| 模型 | 基线训练 | LoRA训练 | 其他 |
|---|---|---|---|
| Wan2.1-Fun | 中文 / EN | 中文 / EN | Control 中文、Reward LoRA |
| Wan2.2 | 中文 / EN | 中文 / EN | 蒸馏 中文、S2V、Animate |
| Wan2.2-Fun | 中文 / EN | 中文 / EN | Control LoRA 中文 |
| CogVideoX-Fun | 中文 / EN | 中文 / EN | Control 中文、Reward LoRA |
| Qwen-Image | 中文 / EN | 中文 / EN | Edit 中文 |
| Qwen-Image-2.1 | 中文 / EN | - | Control 中文 / EN |
| Z-Image | 中文 / EN | 中文 / EN | GRPO LoRA 中文 |
其余模型(如HunyuanVideo、MiniMax-H3、Flux2-Fun、InfiniteTalk、LingBot等)同理,直接查看对应scripts/{model_name}/下的README即可。
三、已支持的模型
下表按模型系列汇总目前已支持的权重,视频模型与图片模型共用同一套推理与训练入口。每个系列一行,第四列为内嵌的四列表格,依次为权重、Hugging Face、ModelScope、对应说明;🤗 为 Hugging Face、🤖 为 ModelScope(国内网络推荐),- 表示该渠道确认无对应仓库或需登录授权。各模型训练文档见3.3 各模型训练文档。
| 模型系列 | 模态 | 支持任务 | 权重 / 下载 / 说明 | ||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Wan2.2-Fun | 视频 | 本项目在Wan2.2上训练的系列,覆盖文生视频、图生视频、首尾图、控制生成、相机控制 |
|
||||||||||||||||||||||||||||
| Wan2.2-VACE-Fun | 视频 | 本项目以VACE方案训练的系列,覆盖控制生成、主体参考 |
|
||||||||||||||||||||||||||||
| Wan2.2 | 视频 | 万象官方权重,覆盖文生视频、图生视频、音频驱动、角色动画,可作为Wan2.2-Fun系列的训练基线 |
|
||||||||||||||||||||||||||||
| Wan2.1-Fun V1.1 | 视频 | 本项目在Wan2.1上训练的V1.1版本,多分辨率(512/768/1024)、81帧16fps,覆盖文生视频、图生视频、首尾图、控制生成、相机控制 |
|
||||||||||||||||||||||||||||
| Wan2.1-Fun V1.0 | 视频 | 本项目在Wan2.1上训练的V1.0版本,能力与V1.1相同但无相机控制 |
|
||||||||||||||||||||||||||||
| Wan2.1 | 视频 | 万象官方权重,覆盖文生视频、图生视频、控制生成,可作为Wan2.1-Fun系列的训练基线 |
|
||||||||||||||||||||||||||||
| Self-Forcing / Causal-Forcing / Flex-Forcing | 视频 | 自回归蒸馏方案,覆盖流式生成、交互式生成与分块注意力 |
|
||||||||||||||||||||||||||||
| TurboWan / TurboDiffusion | 视频 | TurboDiffusion方案公开发布的少步蒸馏权重 |
|
||||||||||||||||||||||||||||
| CogVideoX-Fun V1.5 | 视频 | V1.5官方权重,多分辨率(512/768/1024)、85帧8fps,覆盖图生视频、奖励对齐 |
|
||||||||||||||||||||||||||||
| CogVideoX-Fun V1.1 | 视频 | V1.1官方权重,多分辨率(512/768/1024/1280)、49帧8fps,覆盖图生视频、姿态控制、控制生成、奖励对齐 |
|
||||||||||||||||||||||||||||
| CogVideoX-Fun V1.0 | 视频 | 旧版权重,仍以49帧8fps训练,已被V1.1/V1.5取代 |
|
||||||||||||||||||||||||||||
| HunyuanVideo | 视频 | 官方diffusers格式权重,本项目直接支持预测与LoRA训练 |
|
||||||||||||||||||||||||||||
| MiniMax-H3 | 视频 | 官方视频生成权重与本项目训练的ControlNet |
|
||||||||||||||||||||||||||||
| TaoMate-H3 | 视频+音频 | 基于MiniMax-H3的官方流式音视频生成适配器 |
|
||||||||||||||||||||||||||||
| LTX-2 | 视频+音频 | 官方DiT音视频联合生成权重 |
|
||||||||||||||||||||||||||||
| LongCat-Video | 视频 | 官方长视频生成权重,支持LoRA训练 |
|
||||||||||||||||||||||||||||
| FantasyTalking | 音频驱动视频 | 音频条件增量权重,需搭配基础视频权重与音频编码器 |
|
||||||||||||||||||||||||||||
| InfiniteTalk | 音频驱动视频 | 音频条件增量权重,需搭配基础视频权重与音频编码器 |
|
||||||||||||||||||||||||||||
| FlashHead | 音频驱动视频 | 官方头部动作数字人权重 |
|
||||||||||||||||||||||||||||
| MOVA | 视频+音频 | 官方MOVA权重 |
|
||||||||||||||||||||||||||||
| LingBot | 视频 | 相机可控世界模型,目录结构与Wan2.2-I2V-A14B一致 |
|
||||||||||||||||||||||||||||
| Phantom | 视频 | 多主体参考生视频的增量权重,基于Wan2.1-T2V |
|
||||||||||||||||||||||||||||
| Qwen-Image | 图片 | 官方文生图与图像编辑权重,支持基线与LoRA训练 |
|
||||||||||||||||||||||||||||
| Qwen-Image-2.1 | 图片 | 官方新一代文生图权重,单流block-causal结构,支持前缀KV cache |
|
||||||||||||||||||||||||||||
| Qwen-Image ControlNet | 图片 | 图片控制生成,支持Canny、Depth、Pose、MLSD、Scribble |
|
||||||||||||||||||||||||||||
| Z-Image | 图片 | 官方文生图权重 |
|
||||||||||||||||||||||||||||
| Z-Image-Fun | 图片 | 本项目在Z-Image上训练的ControlNet与蒸馏LoRA,控制条件支持Canny、Depth、Pose、MLSD、Scribble、Gray |
|
||||||||||||||||||||||||||||
| Flux | 图片 | 官方FLUX.1/FLUX.2权重与本项目训练的ControlNet |
|
||||||||||||||||||||||||||||
| ERNIE-Image | 图片 | 百度官方文生图权重 |
|
||||||||||||||||||||||||||||
| Lens | 图片 | 微软官方文生图权重 |
|
||||||||||||||||||||||||||||
| 辅助模型 | - | 非生成模型,服务于奖励对齐、数据打标与快速解码 |
|
补充说明:
- 音频驱动与参考类模型(FantasyTalking、InfiniteTalk、Phantom、TaoMate-H3)本身只是增量权重,必须同时下载表中对应的基础视频权重与音频编码器。
- TurboDiffusion方案已公开发布TurboWan系列蒸馏权重(见上表);Flex-Forcing、PDD等其余蒸馏方案没有公开发布的权重,按
scripts/{model_name}/README_TRAIN*.md训练后即可得到,可直接填入预测文件中的transformer_path。- 权重名与
models/Diffusion_Transformer/下的文件夹名一一对应;同一系列内各权重互不通用,需按预测任务选择,若某个权重未在此列出,说明它由本项目训练产出或需从上游官方仓库获取。
四、视频作品
图生视频:
通用控制视频 + 参考图像:
| 参考图像 | 控制视频 | Wan2.1-Fun-V1.1-14B-Control | Wan2.1-Fun-V1.1-1.3B-Control |
|
|
通用控制视频(Canny、Pose、Depth 等)与轨迹控制:
五、参考文献
本节列出已支持的模型中各模型系列的官方仓库,以及本项目在实现与流程中参考的代码来源,感谢这些开源工作。
- CogVideo: https://github.com/THUDM/CogVideo/
- EasyAnimate: https://github.com/aigc-apps/EasyAnimate
- Wan2.1: https://github.com/Wan-Video/Wan2.1/
- Wan2.2: https://github.com/Wan-Video/Wan2.2/
- HunyuanVideo: https://github.com/Tencent-Hunyuan/HunyuanVideo
- HunyuanVideo-I2V: https://github.com/Tencent-Hunyuan/HunyuanVideo-I2V
- MiniMax-H3: https://github.com/MiniMax-AI/MiniMax-H3
- LTX-Video: https://github.com/Lightricks/LTX-Video
- LTX-2: https://github.com/Lightricks/LTX-2
- LongCat-Video: https://github.com/meituan-longcat/LongCat-Video
- FantasyTalking: https://github.com/Fantasy-AMAP/fantasy-talking
- InfiniteTalk: https://github.com/MeiGen-AI/InfiniteTalk
- FlashHead: https://github.com/Soul-AILab/SoulX-FlashHead
- MOVA: https://github.com/OpenMOSS/MOVA
- LingBot-Video: https://github.com/Robbyant/lingbot-video
- LingBot-World: https://github.com/Robbyant/lingbot-world
- Phantom: https://github.com/Phantom-video/Phantom
- Qwen-Image: https://github.com/QwenLM/Qwen-Image
- Z-Image: https://github.com/Tongyi-MAI/Z-Image
- Flux: https://github.com/black-forest-labs/flux
- Flux2: https://github.com/black-forest-labs/flux2
- ERNIE-Image: https://github.com/baidu/ernie-image
- Lens: https://www.microsoft.com/en-us/research/publication/lens-rethinking-training-efficiency-for-foundational-text-to-image-models/
- VACE: https://github.com/ali-vilab/VACE
- CameraCtrl: https://github.com/hehao13/CameraCtrl
- ComfyUI-CameraCtrl-Wrapper: https://github.com/chaojie/ComfyUI-CameraCtrl-Wrapper
- DWPose: https://github.com/IDEA-Research/DWPose
- MiDaS: https://github.com/isl-org/MiDaS
- Self-Forcing: https://github.com/guandeh17/Self-Forcing
- Causal-Forcing: https://github.com/thu-ml/Causal-Forcing
- TurboDiffusion: https://github.com/thu-ml/TurboDiffusion
- TAEHV: https://github.com/madebyollin/taehv
- HPS v2: https://github.com/tgxs002/HPSv2
- HPSv3: https://github.com/MizzenAI/HPSv3
- MPS: https://github.com/Kwai-Kolors/MPS
- Qwen2-VL: https://github.com/QwenLM/Qwen2-VL
- AnimateDiff: https://github.com/guoyww/AnimateDiff
- ComfyUI-KJNodes: https://github.com/kijai/ComfyUI-KJNodes
- ComfyUI-EasyAnimateWrapper: https://github.com/kijai/ComfyUI-EasyAnimateWrapper
- Diffusers: https://github.com/huggingface/diffusers
六、引用
如果您在研究或项目中使用了 VideoX-Fun,请按以下格式引用:
@misc{aigc_apps_VideoX_Fun_2026,
  author = {aigc-apps},
  title = {VideoX-Fun: A Video Generation Pipeline for Diffusion Transformer},
  year = {2026},
  publisher = {GitHub},
  url = {https://github.com/aigc-apps/VideoX-Fun}
}
七、限制与风险
- 生成的视频可能存在伪影或质量问题,尤其在复杂场景中。
- 模型在处理精细细节、文字渲染或特定艺术风格时可能有困难。
- 性能因输入提示词质量、分辨率等参数而异。
- 该技术可能被滥用于创建误导性内容(如深度伪造)。用户需对道德使用负责。
- 模型可能反映训练数据中存在的偏见。
- 用户在使用真人图片或视频时应尊重隐私和版权。
我们鼓励负责任地使用该技术,并建议在生产环境中实施安全措施。
八、许可证
本项目采用 Apache License (Version 2.0).
CogVideoX-2B 模型 (包括其对应的Transformers模块,VAE模块) 根据 Apache 2.0 协议 许可证发布。
CogVideoX-5B 模型(Transformer 模块)在CogVideoX许可证下发布.