
37 KiB
Executable File
VideoX-Fun
😊 Welcome!
CogVideoX-Fun:

Wan-Fun:
目录
简介
VideoX-Fun是一个视频生成的pipeline,可用于生成AI图片与视频、训练Diffusion Transformer的基线模型与Lora模型,我们支持从已经训练好的基线模型直接进行预测,生成不同分辨率,不同秒数、不同FPS的视频,也支持用户训练自己的基线模型与Lora模型,进行一定的风格变换。
我们会逐渐支持从不同平台快速启动,请参阅 快速启动。
新特性:
- 更新Wan2.1-Fun-V1.1版本:支持14B与1.3B模型Control+参考图模型,支持镜头控制,另外Inpaint模型重新训练,性能更佳。[2025.04.25]
- 更新Wan2.1-Fun-V1.0版本:支持14B与1.3B模型的I2V和Control模型,支持首尾图预测。[2025.03.26]
- 更新CogVideoX-Fun-V1.5版本:上传I2V模型与相关训练预测代码。[2024.12.16]
- 奖励Lora支持:通过奖励反向传播技术训练Lora,以优化生成的视频,使其更好地与人类偏好保持一致,更多信息。新版本的控制模型,支持不同的控制条件,如Canny、Depth、Pose、MLSD等。[2024.11.21]
- diffusers支持:CogVideoX-Fun Control现在在diffusers中得到了支持。感谢 a-r-r-o-w在这个 PR中贡献了支持。查看文档以了解更多信息。[2024.10.16]
- 更新CogVideoX-Fun-V1.1版本:重新训练i2v模型,添加Noise,使得视频的运动幅度更大。上传控制模型训练代码与Control模型。[2024.09.29]
- 更新CogVideoX-Fun-V1.0版本:创建代码!现在支持 Windows 和 Linux。支持2b与5b最大256x256x49到1024x1024x49的任意分辨率的视频生成。[2024.09.18]
功能概览:
我们的ui界面如下:
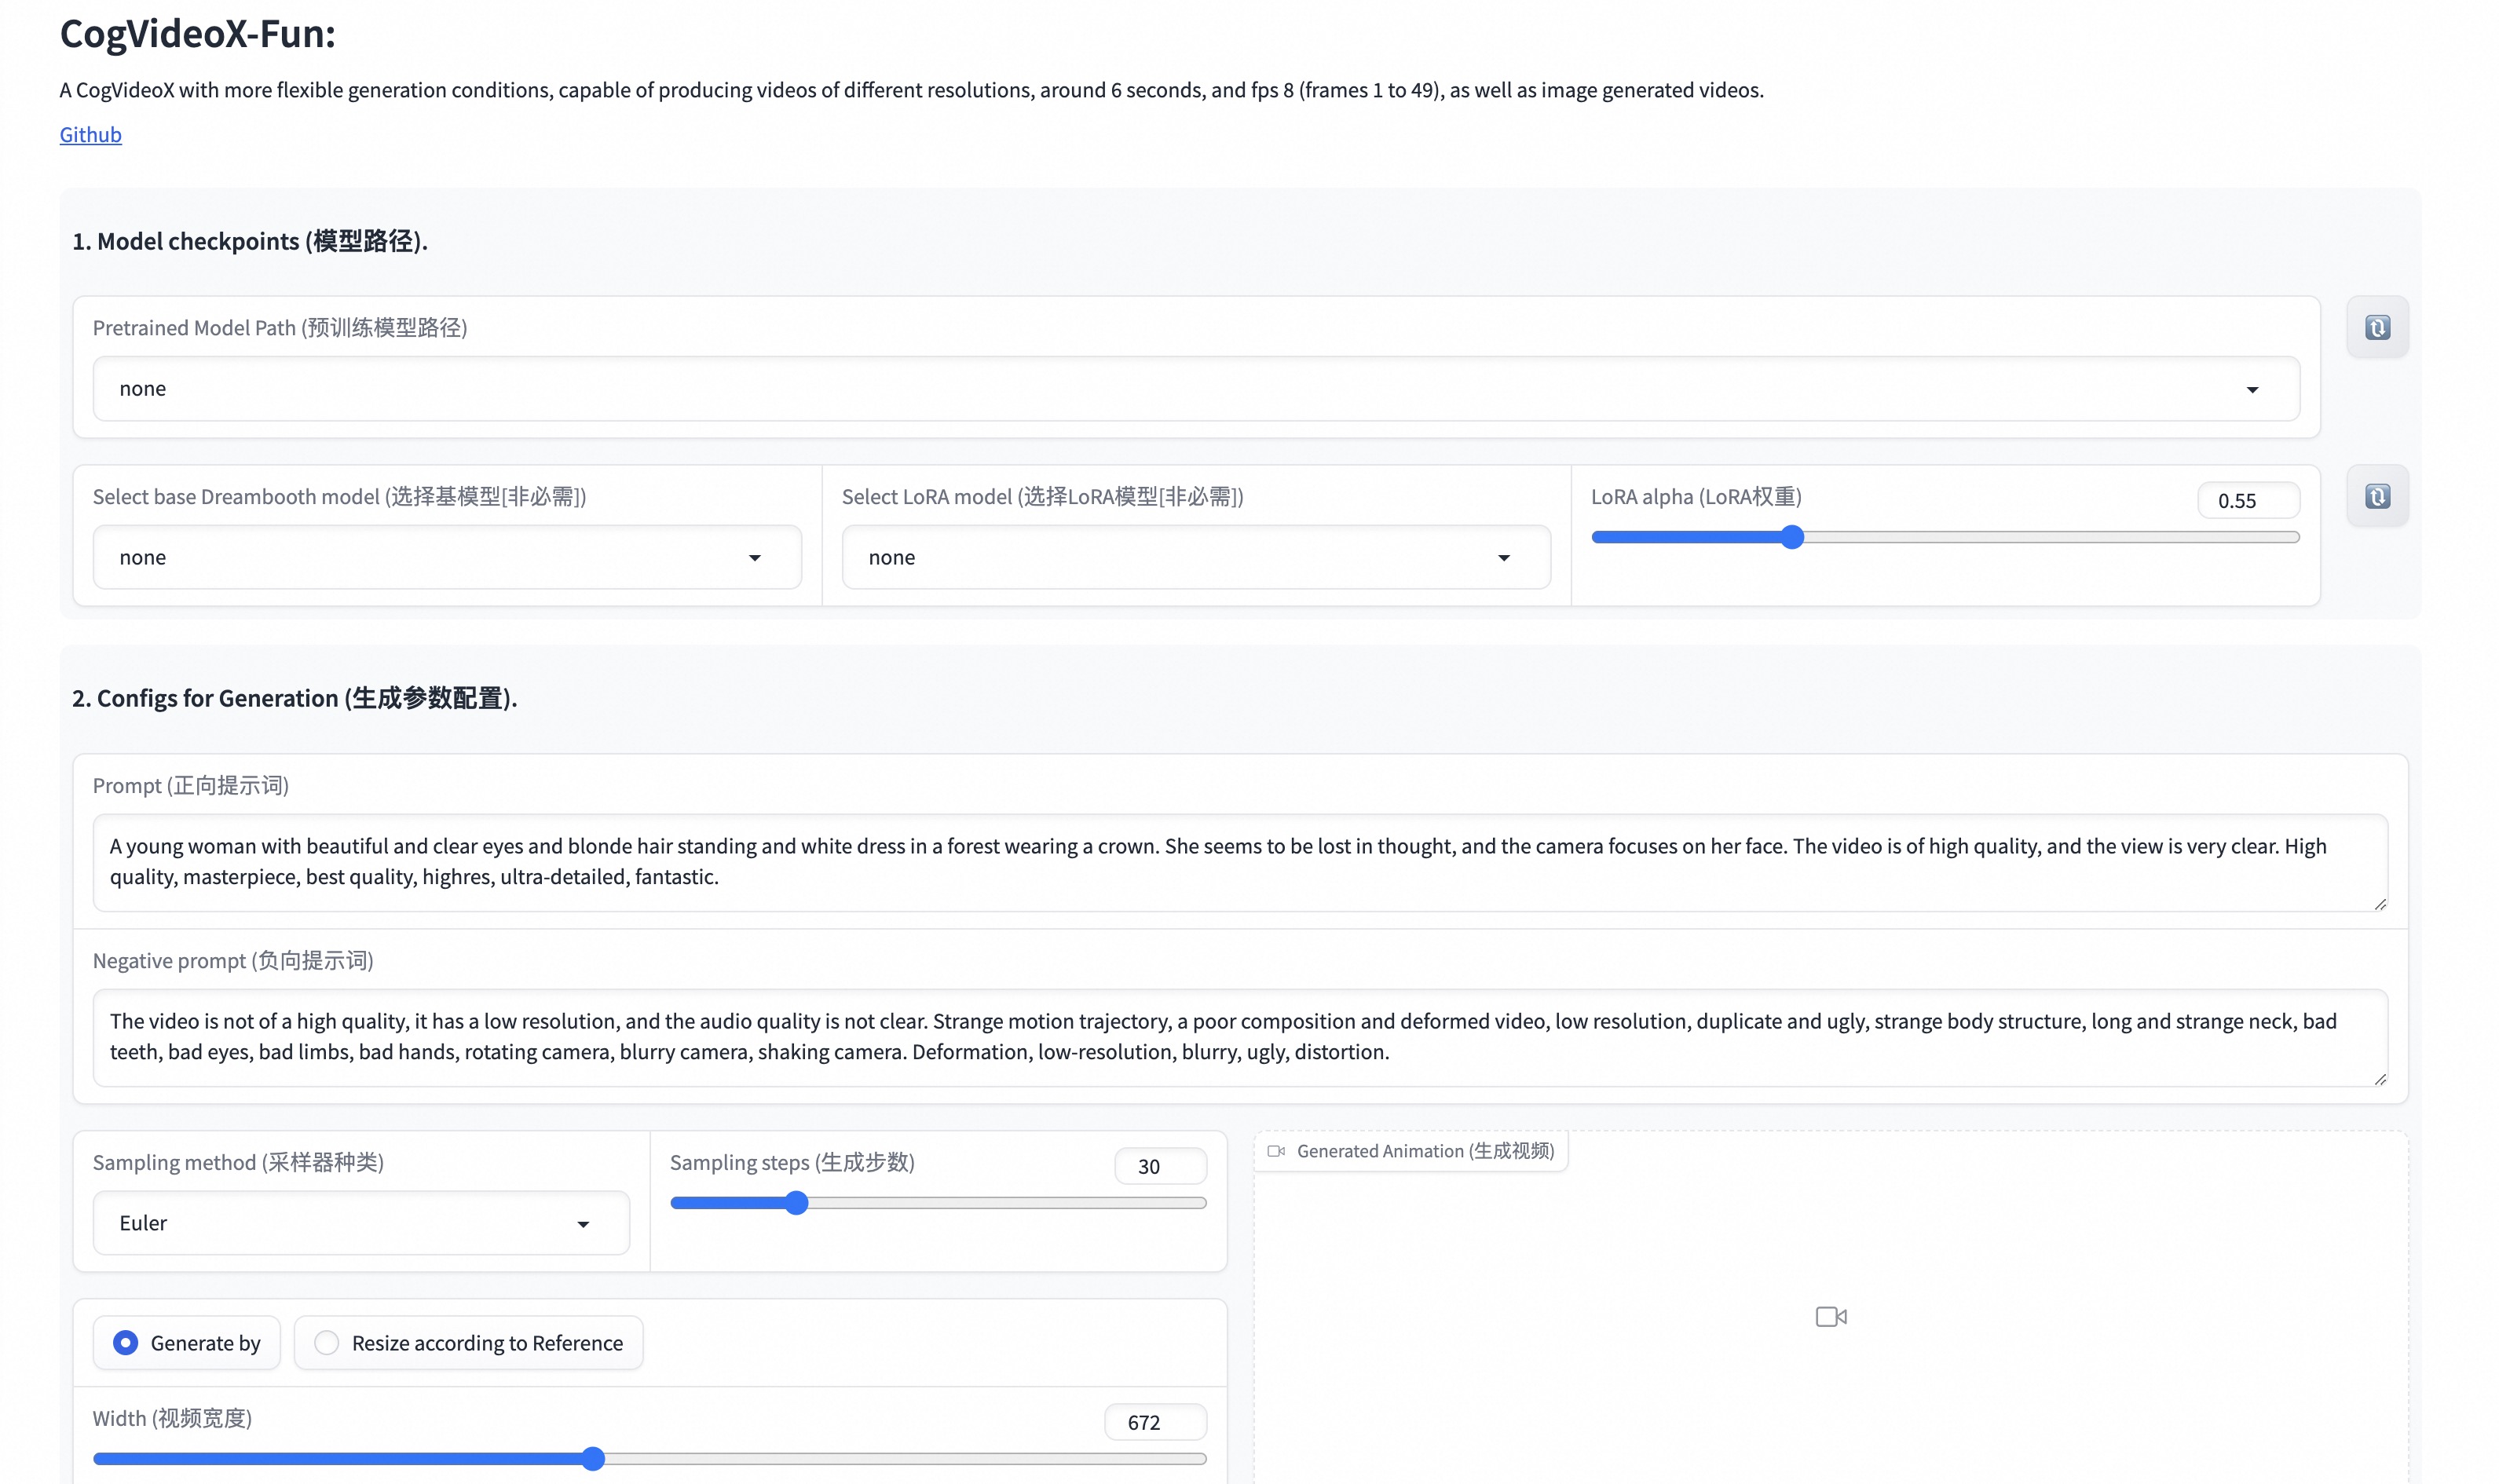
快速启动
1. 云使用: AliyunDSW/Docker
a. 通过阿里云 DSW
DSW 有免费 GPU 时间,用户可申请一次,申请后3个月内有效。
阿里云在Freetier提供免费GPU时间,获取并在阿里云PAI-DSW中使用,5分钟内即可启动CogVideoX-Fun。
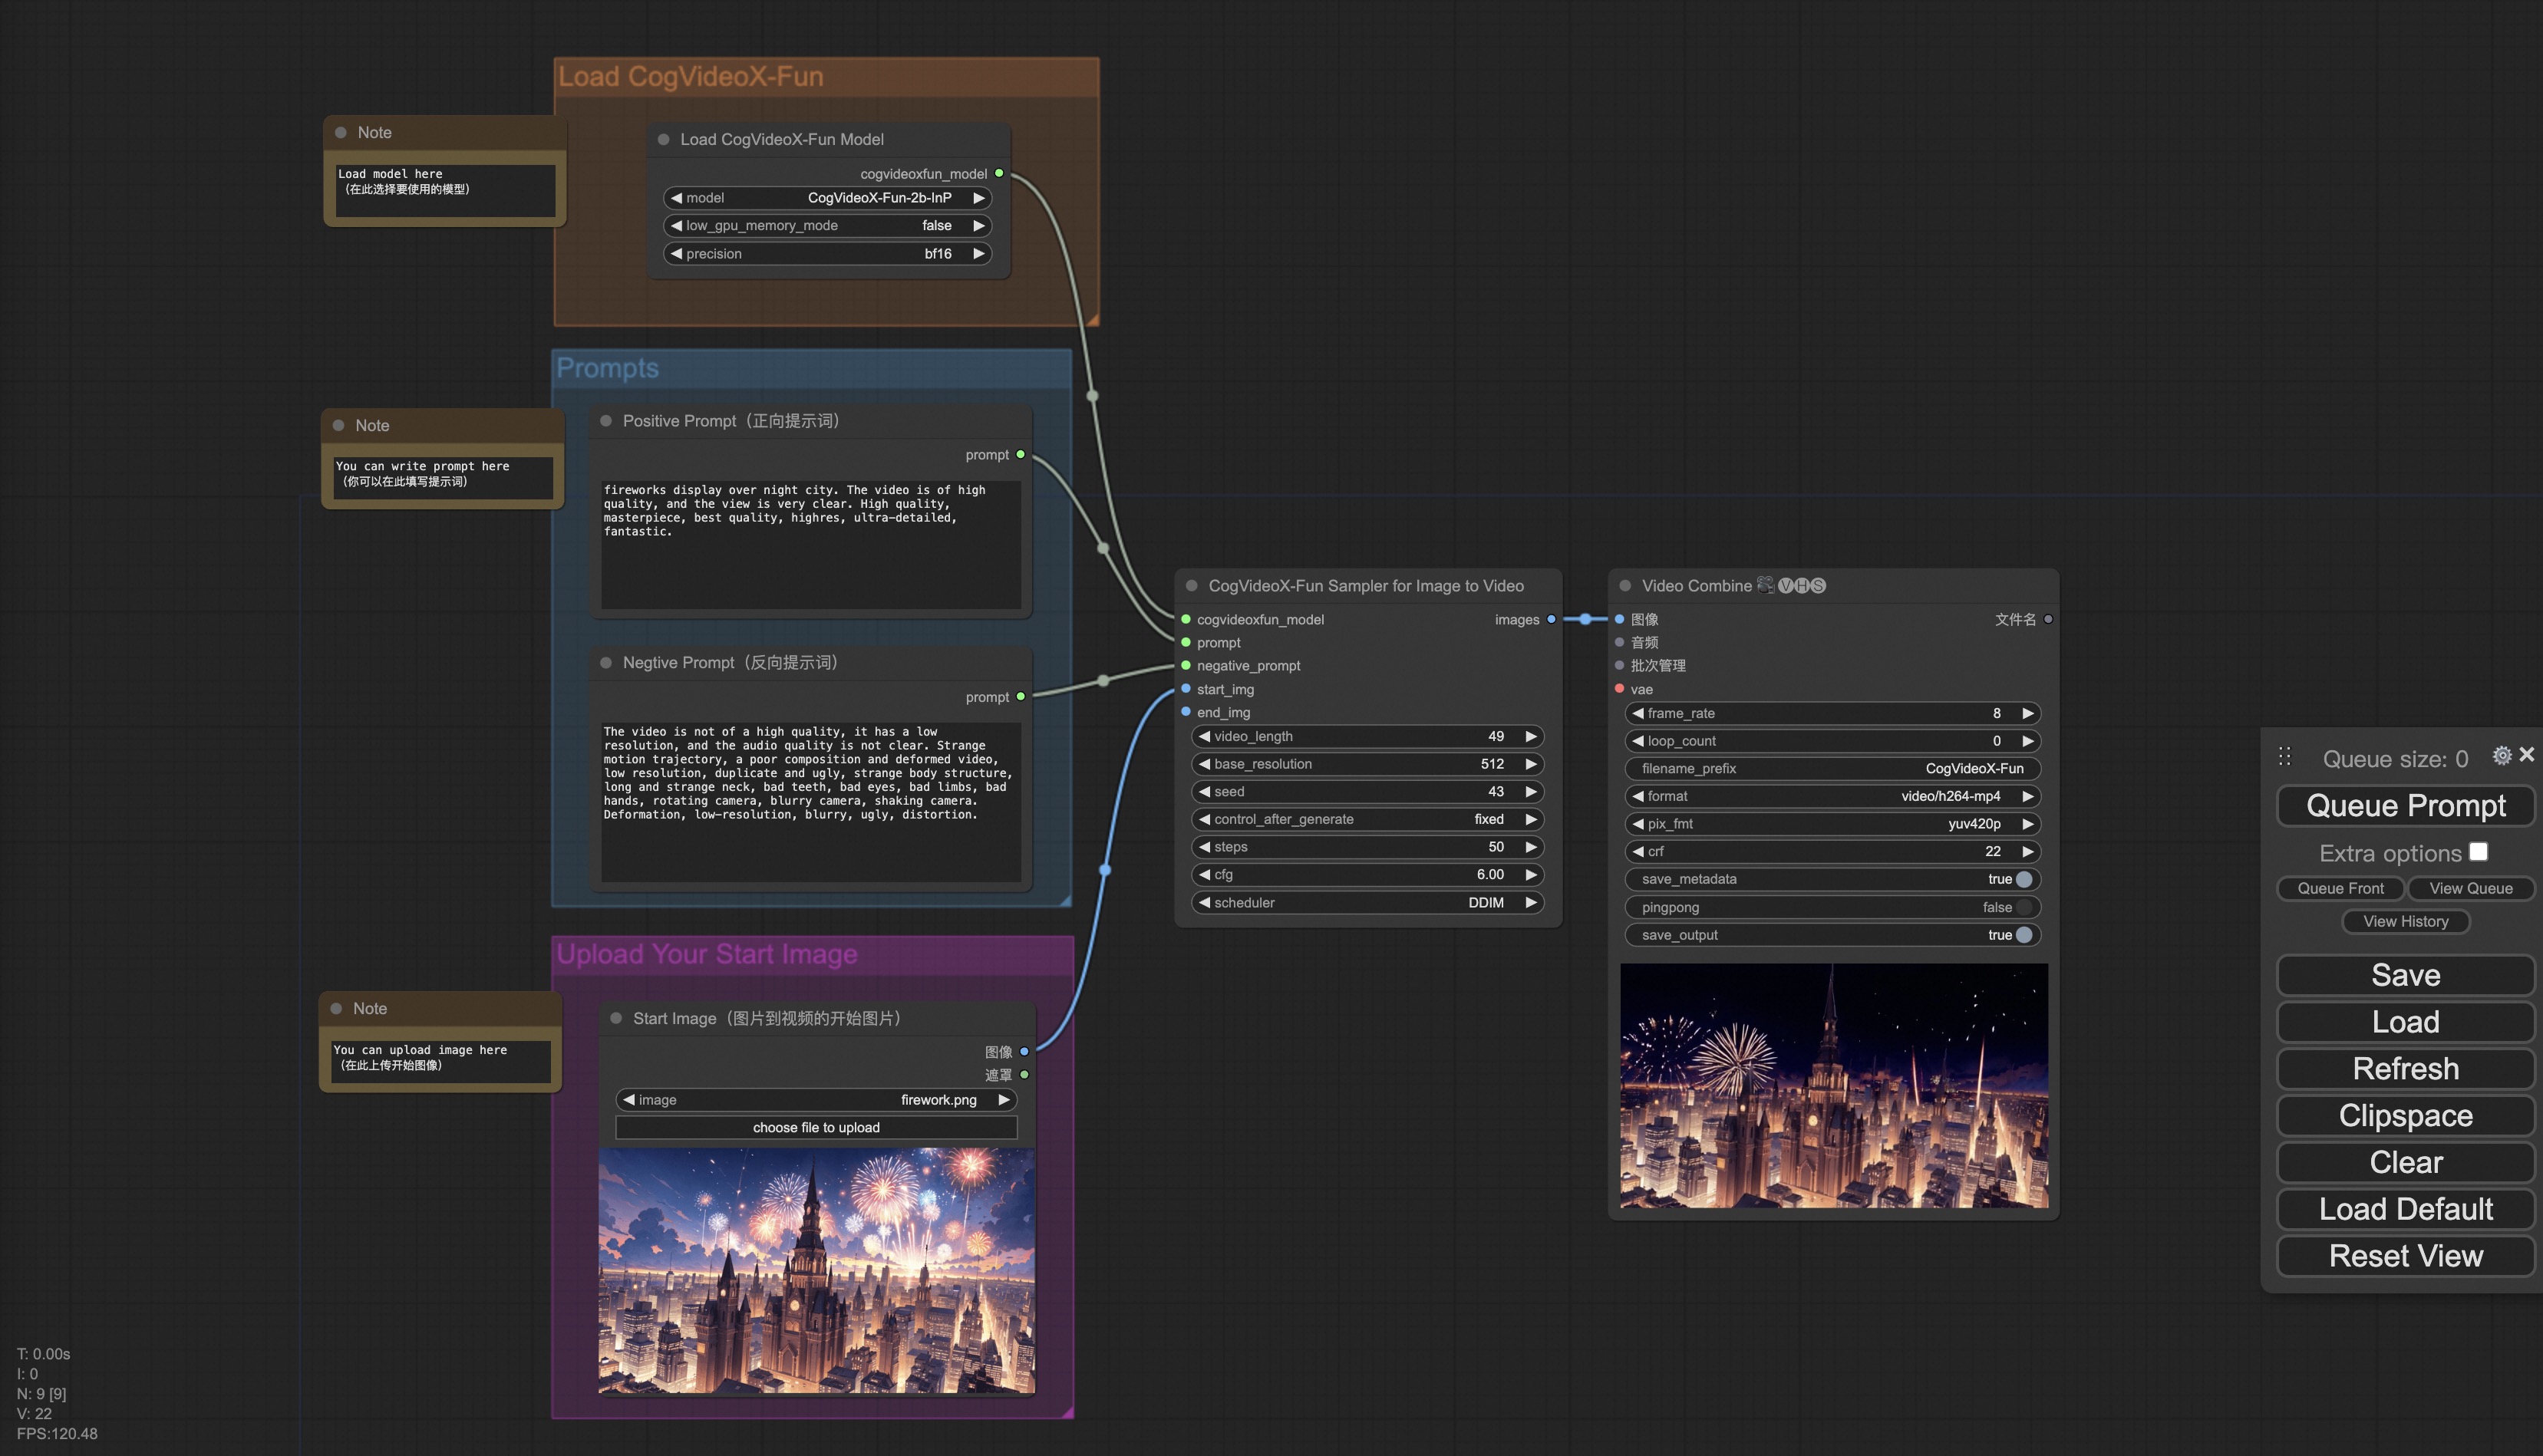
b. 通过ComfyUI
我们的ComfyUI界面如下,具体查看ComfyUI README。
c. 通过docker
使用docker的情况下,请保证机器中已经正确安装显卡驱动与CUDA环境,然后以此执行以下命令:
# pull image
docker pull mybigpai-public-registry.cn-beijing.cr.aliyuncs.com/easycv/torch_cuda:cogvideox_fun

# enter image
docker run -it -p 7860:7860 --network host --gpus all --security-opt seccomp:unconfined --shm-size 200g mybigpai-public-registry.cn-beijing.cr.aliyuncs.com/easycv/torch_cuda:cogvideox_fun

# clone code
git clone https://github.com/aigc-apps/VideoX-Fun.git

# enter VideoX-Fun's dir
cd VideoX-Fun

# download weights
mkdir models/Diffusion_Transformer
mkdir models/Personalized_Model

# Please use the hugginface link or modelscope link to download the model.
# CogVideoX-Fun
# https://huggingface.co/alibaba-pai/CogVideoX-Fun-V1.1-5b-InP
# https://modelscope.cn/models/PAI/CogVideoX-Fun-V1.1-5b-InP

# Wan
# https://huggingface.co/alibaba-pai/Wan2.1-Fun-V1.1-14B-InP
# https://modelscope.cn/models/PAI/Wan2.1-Fun-V1.1-14B-InP
2. 本地安装: 环境检查/下载/安装
a. 环境检查
我们已验证该库可在以下环境中执行:
Windows 的详细信息:
- 操作系统 Windows 10
- python: python3.10 & python3.11
- pytorch: torch2.2.0
- CUDA: 11.8 & 12.1
- CUDNN: 8+
- GPU: Nvidia-3060 12G & Nvidia-3090 24G
Linux 的详细信息:
- 操作系统 Ubuntu 20.04, CentOS
- python: python3.10 & python3.11
- pytorch: torch2.2.0
- CUDA: 11.8 & 12.1
- CUDNN: 8+
- GPU:Nvidia-V100 16G & Nvidia-A10 24G & Nvidia-A100 40G & Nvidia-A100 80G
我们需要大约 60GB 的可用磁盘空间,请检查!
b. 权重放置
我们最好将权重按照指定路径进行放置:
通过comfyui:
将模型放入Comfyui的权重文件夹ComfyUI/models/Fun_Models/:
📦 ComfyUI/
├── 📂 models/
│   └── 📂 Fun_Models/
│       ├── 📂 CogVideoX-Fun-V1.1-2b-InP/
│       ├── 📂 CogVideoX-Fun-V1.1-5b-InP/
│       ├── 📂 Wan2.1-Fun-V1.1-14B-InP
│       └── 📂 Wan2.1-Fun-V1.1-1.3B-InP/
运行自身的python文件或ui界面:
📦 models/
├── 📂 Diffusion_Transformer/
│   ├── 📂 CogVideoX-Fun-V1.1-2b-InP/
│   ├── 📂 CogVideoX-Fun-V1.1-5b-InP/
│   ├── 📂 Wan2.1-Fun-V1.1-14B-InP
│   └── 📂 Wan2.1-Fun-V1.1-1.3B-InP/
├── 📂 Personalized_Model/
│   └── your trained trainformer model / your trained lora model (for UI load)
视频作品
Wan2.1-Fun-V1.1-14B-InP && Wan2.1-Fun-V1.1-1.3B-InP
Wan2.1-Fun-V1.1-14B-Control && Wan2.1-Fun-V1.1-1.3B-Control
Generic Control Video + Reference Image:
| Reference Image | Control Video | Wan2.1-Fun-V1.1-14B-Control | Wan2.1-Fun-V1.1-1.3B-Control |
|
|
|||
Generic Control Video (Canny, Pose, Depth, etc.) and Trajectory Control:
Wan2.1-Fun-V1.1-14B-Control-Camera && Wan2.1-Fun-V1.1-1.3B-Control-Camera
| Pan Up | Pan Left | Pan Right |
| Pan Down | Pan Up + Pan Left | Pan Up + Pan Right |
CogVideoX-Fun-V1.1-5B
Resolution-1024
Resolution-768
Resolution-512
CogVideoX-Fun-V1.1-5B-Control
| A young woman with beautiful clear eyes and blonde hair, wearing white clothes and twisting her body, with the camera focused on her face. High quality, masterpiece, best quality, high resolution, ultra-fine, dreamlike. | A young woman with beautiful clear eyes and blonde hair, wearing white clothes and twisting her body, with the camera focused on her face. High quality, masterpiece, best quality, high resolution, ultra-fine, dreamlike. | A young bear. |
如何使用
1. 生成
a、显存节省方案
由于Wan2.1的参数非常大,我们需要考虑显存节省方案,以节省显存适应消费级显卡。我们给每个预测文件都提供了GPU_memory_mode,可以在model_cpu_offload,model_cpu_offload_and_qfloat8,sequential_cpu_offload中进行选择。该方案同样适用于CogVideoX-Fun的生成。
- model_cpu_offload代表整个模型在使用后会进入cpu,可以节省部分显存。
- model_cpu_offload_and_qfloat8代表整个模型在使用后会进入cpu,并且对transformer模型进行了float8的量化,可以节省更多的显存。
- sequential_cpu_offload代表模型的每一层在使用后会进入cpu,速度较慢,节省大量显存。
qfloat8会部分降低模型的性能,但可以节省更多的显存。如果显存足够,推荐使用model_cpu_offload。
b、通过comfyui
具体查看ComfyUI README。
c、运行python文件
i、单卡运行:
- 步骤1:下载对应权重放入models文件夹。
- 步骤2:根据不同的权重与预测目标使用不同的文件进行预测。当前该库支持CogVideoX-Fun、Wan2.1和Wan2.1-Fun,在examples文件夹下用文件夹名以区分,不同模型支持的功能不同,请视具体情况予以区分。以CogVideoX-Fun为例。
- 文生视频:
- 使用examples/cogvideox_fun/predict_t2v.py文件中修改prompt、neg_prompt、guidance_scale和seed。
- 而后运行examples/cogvideox_fun/predict_t2v.py文件,等待生成结果,结果保存在samples/cogvideox-fun-videos文件夹中。
- 图生视频:
- 使用examples/cogvideox_fun/predict_i2v.py文件中修改validation_image_start、validation_image_end、prompt、neg_prompt、guidance_scale和seed。
- validation_image_start是视频的开始图片,validation_image_end是视频的结尾图片。
- 而后运行examples/cogvideox_fun/predict_i2v.py文件,等待生成结果,结果保存在samples/cogvideox-fun-videos_i2v文件夹中。
- 视频生视频:
- 使用examples/cogvideox_fun/predict_v2v.py文件中修改validation_video、validation_image_end、prompt、neg_prompt、guidance_scale和seed。
- validation_video是视频生视频的参考视频。您可以使用以下视频运行演示:演示视频
- 而后运行examples/cogvideox_fun/predict_v2v.py文件,等待生成结果,结果保存在samples/cogvideox-fun-videos_v2v文件夹中。
- 普通控制生视频(Canny、Pose、Depth等):
- 使用examples/cogvideox_fun/predict_v2v_control.py文件中修改control_video、validation_image_end、prompt、neg_prompt、guidance_scale和seed。
- control_video是控制生视频的控制视频,是使用Canny、Pose、Depth等算子提取后的视频。您可以使用以下视频运行演示:演示视频
- 而后运行examples/cogvideox_fun/predict_v2v_control.py文件,等待生成结果,结果保存在samples/cogvideox-fun-videos_v2v_control文件夹中。
- 文生视频:
- 步骤3:如果想结合自己训练的其他backbone与Lora,则看情况修改examples/{model_name}/predict_t2v.py中的examples/{model_name}/predict_i2v.py和lora_path。
ii、多卡运行:
在使用多卡预测时请注意安装xfuser仓库,推荐安装xfuser==0.4.2和yunchang==0.6.2。
pip install xfuser==0.4.2 --progress-bar off -i https://mirrors.aliyun.com/pypi/simple/
pip install yunchang==0.6.2 --progress-bar off -i https://mirrors.aliyun.com/pypi/simple/
请确保ulysses_degree和ring_degree的乘积等于使用的GPU数量。例如,如果您使用8个GPU,则可以设置ulysses_degree=2和ring_degree=4,也可以设置ulysses_degree=4和ring_degree=2。
ulysses_degree是在head进行切分后并行生成,ring_degree是在sequence上进行切分后并行生成。ring_degree相比ulysses_degree有更大的通信成本,在设置参数时需要结合序列长度和模型的head数进行设置。
以8卡并行预测为例。
- 以Wan2.1-Fun-V1.1-14B-InP为例,其head数为40,ulysses_degree需要设置为其可以整除的数如2、4、8等。因此在使用8卡并行预测时,可以设置ulysses_degree=8和ring_degree=1.
- 以Wan2.1-Fun-V1.1-1.3B-InP为例,其head数为12,ulysses_degree需要设置为其可以整除的数如2、4等。因此在使用8卡并行预测时,可以设置ulysses_degree=4和ring_degree=2.
设置完成后,使用如下指令进行并行预测:
torchrun --nproc-per-node=8 examples/wan2.1_fun/predict_t2v.py
d、通过ui界面
webui支持文生视频、图生视频、视频生视频和普通控制生视频(Canny、Pose、Depth等)。当前该库支持CogVideoX-Fun、Wan2.1和Wan2.1-Fun,在examples文件夹下用文件夹名以区分,不同模型支持的功能不同,请视具体情况予以区分。以CogVideoX-Fun为例。
- 步骤1:下载对应权重放入models文件夹。
- 步骤2:运行examples/cogvideox_fun/app.py文件,进入gradio页面。
- 步骤3:根据页面选择生成模型,填入prompt、neg_prompt、guidance_scale和seed等,点击生成,等待生成结果,结果保存在sample文件夹中。
2. 模型训练
一个完整的模型训练链路应该包括数据预处理和Video DiT训练。不同模型的训练流程类似,数据格式也类似:
a.数据预处理
我们给出了一个简单的demo通过图片数据训练lora模型,详情可以查看[wiki](https://github.com/aigc-apps/CogVideoX-Fun/wiki/Training-Lora)。一个完整的长视频切分、清洗、描述的数据预处理链路可以参考video caption部分的README进行。
如果期望训练一个文生图视频的生成模型,您需要以这种格式排列数据集。
📦 project/
├── 📂 datasets/
│   ├── 📂 internal_datasets/
│       ├── 📂 train/
│       │   ├── 📄 00000001.mp4
│       │   ├── 📄 00000002.jpg
│       │   └── 📄 .....
│       └── 📄 json_of_internal_datasets.json
json_of_internal_datasets.json是一个标准的json文件。json中的file_path可以被设置为相对路径,如下所示:
[
    {
      "file_path": "train/00000001.mp4",
      "text": "A group of young men in suits and sunglasses are walking down a city street.",
      "type": "video"
    },
    {
      "file_path": "train/00000002.jpg",
      "text": "A group of young men in suits and sunglasses are walking down a city street.",
      "type": "image"
    },
    .....
]
你也可以将路径设置为绝对路径:
[
    {
      "file_path": "/mnt/data/videos/00000001.mp4",
      "text": "A group of young men in suits and sunglasses are walking down a city street.",
      "type": "video"
    },
    {
      "file_path": "/mnt/data/train/00000001.jpg",
      "text": "A group of young men in suits and sunglasses are walking down a city street.",
      "type": "image"
    },
    .....
]
b. Video DiT训练
如果数据预处理时,数据的格式为相对路径,则进入scripts/{model_name}/train.sh进行如下设置。
export DATASET_NAME="datasets/internal_datasets/"
export DATASET_META_NAME="datasets/internal_datasets/json_of_internal_datasets.json"
如果数据的格式为绝对路径,则进入scripts/train.sh进行如下设置。
export DATASET_NAME=""
export DATASET_META_NAME="/mnt/data/json_of_internal_datasets.json"
最后运行scripts/train.sh。
sh scripts/train.sh
关于一些参数的设置细节: Wan2.1-Fun可以查看Readme Train与Readme Lora。 Wan2.1可以查看Readme Train与Readme Lora。 CogVideoX-Fun可以查看Readme Train与Readme Lora。
模型地址
1.Wan2.2-Fun
| 名称 | 存储空间 | Hugging Face | Model Scope | 描述 |
|---|---|---|---|---|
| Wan2.2-Fun-A14B-InP | 64.0 GB | 🤗Link | 😄Link | Wan2.2-Fun-14B文图生视频权重,以多分辨率训练,支持首尾图预测。 |
| Wan2.2-Fun-A14B-Control | 64.0 GB | 🤗Link | 😄Link | Wan2.2-Fun-14B视频控制权重,支持不同的控制条件,如Canny、Depth、Pose、MLSD等,同时支持使用轨迹控制。支持多分辨率(512,768,1024)的视频预测,,以81帧、每秒16帧进行训练,支持多语言预测 |
| Wan2.2-Fun-A14B-Control-Camera | 64.0 GB | 🤗Link | 😄Link | Wan2.2-Fun-14B相机镜头控制权重。支持多分辨率(512,768,1024)的视频预测,,以81帧、每秒16帧进行训练,支持多语言预测 |
| Wan2.2-VACE-Fun-A14B | 64.0 GB | 🤗Link | 😄Link | 以VACE方案训练的Wan2.2控制权重,基础模型为Wan2.2-T2V-A14B,支持不同的控制条件,如Canny、Depth、Pose、MLSD、轨迹控制等。支持通过主体指定生视频。支持多分辨率(512,768,1024)的视频预测,支持多分辨率(512,768,1024)的视频预测,以81帧、每秒16帧进行训练,支持多语言预测 |
| Wan2.2-Fun-5B-InP | 23.0 GB | 🤗Link | 😄Link | Wan2.2-Fun-5B文图生视频权重,以121帧、每秒24帧进行训练支持首尾图预测。 |
| Wan2.2-Fun-5B-Control | 23.0 GB | 🤗Link | 😄Link | Wan2.2-Fun-5B视频控制权重,支持不同的控制条件,如Canny、Depth、Pose、MLSD等,同时支持使用轨迹控制。以121帧、每秒24帧进行训练,支持多语言预测 |
| Wan2.2-Fun-5B-Control-Camera | 23.0 GB | 🤗Link | 😄Link | Wan2.2-Fun-5B相机镜头控制权重。以121帧、每秒24帧进行训练,支持多语言预测 |
2. Wan2.2
| 名称 | Hugging Face | Model Scope | 描述 |
|---|---|---|---|
| Wan2.2-TI2V-5B | 🤗Link | 😄Link | 万象2.2-5B文生视频权重 |
| Wan2.2-T2V-A14B | 🤗Link | 😄Link | 万象2.2-14B文生视频权重 |
| Wan2.2-I2V-A14B | 🤗Link | 😄Link | 万象2.2-14B图生视频权重 |
3. Wan2.1-Fun
V1.1:
| 名称 | 存储空间 | Hugging Face | Model Scope | 描述 |
|---|---|---|---|---|
| Wan2.1-Fun-V1.1-1.3B-InP | 19.0 GB | 🤗Link | 😄Link | Wan2.1-Fun-V1.1-1.3B文图生视频权重,以多分辨率训练,支持首尾图预测。 |
| Wan2.1-Fun-V1.1-14B-InP | 47.0 GB | 🤗Link | 😄Link | Wan2.1-Fun-V1.1-14B文图生视频权重,以多分辨率训练,支持首尾图预测。 |
| Wan2.1-Fun-V1.1-1.3B-Control | 19.0 GB | 🤗Link | 😄Link | Wan2.1-Fun-V1.1-1.3B视频控制权重支持不同的控制条件,如Canny、Depth、Pose、MLSD等,支持参考图 + 控制条件进行控制,支持使用轨迹控制。支持多分辨率(512,768,1024)的视频预测,,以81帧、每秒16帧进行训练,支持多语言预测 |
| Wan2.1-Fun-V1.1-14B-Control | 47.0 GB | 🤗Link | 😄Link | Wan2.1-Fun-V1.1-14B视视频控制权重支持不同的控制条件,如Canny、Depth、Pose、MLSD等,支持参考图 + 控制条件进行控制,支持使用轨迹控制。支持多分辨率(512,768,1024)的视频预测,,以81帧、每秒16帧进行训练,支持多语言预测 |
| Wan2.1-Fun-V1.1-1.3B-Control-Camera | 19.0 GB | 🤗Link | 😄Link | Wan2.1-Fun-V1.1-1.3B相机镜头控制权重。支持多分辨率(512,768,1024)的视频预测,,以81帧、每秒16帧进行训练,支持多语言预测 |
| Wan2.1-Fun-V1.1-14B-Control-Camera | 47.0 GB | 🤗Link | 😄Link | Wan2.1-Fun-V1.1-14B相机镜头控制权重。支持多分辨率(512,768,1024)的视频预测,,以81帧、每秒16帧进行训练,支持多语言预测 |
V1.0:
| 名称 | 存储空间 | Hugging Face | Model Scope | 描述 |
|---|---|---|---|---|
| Wan2.1-Fun-1.3B-InP | 19.0 GB | 🤗Link | 😄Link | Wan2.1-Fun-1.3B文图生视频权重,以多分辨率训练,支持首尾图预测。 |
| Wan2.1-Fun-14B-InP | 47.0 GB | 🤗Link | 😄Link | Wan2.1-Fun-14B文图生视频权重,以多分辨率训练,支持首尾图预测。 |
| Wan2.1-Fun-1.3B-Control | 19.0 GB | 🤗Link | 😄Link | Wan2.1-Fun-1.3B视频控制权重,支持不同的控制条件,如Canny、Depth、Pose、MLSD等,同时支持使用轨迹控制。支持多分辨率(512,768,1024)的视频预测,,以81帧、每秒16帧进行训练,支持多语言预测 |
| Wan2.1-Fun-14B-Control | 47.0 GB | 🤗Link | 😄Link | Wan2.1-Fun-14B视频控制权重,支持不同的控制条件,如Canny、Depth、Pose、MLSD等,同时支持使用轨迹控制。支持多分辨率(512,768,1024)的视频预测,,以81帧、每秒16帧进行训练,支持多语言预测 |
4. Wan2.1
| 名称 | Hugging Face | Model Scope | 描述 |
|---|---|---|---|
| Wan2.1-T2V-1.3B | 🤗Link | 😄Link | 万象2.1-1.3B文生视频权重 |
| Wan2.1-T2V-14B | 🤗Link | 😄Link | 万象2.1-14B文生视频权重 |
| Wan2.1-I2V-14B-480P | 🤗Link | 😄Link | 万象2.1-14B-480P图生视频权重 |
| Wan2.1-I2V-14B-720P | 🤗Link | 😄Link | 万象2.1-14B-720P图生视频权重 |
5. CogVideoX-Fun
V1.5:
| 名称 | 存储空间 | Hugging Face | Model Scope | 描述 |
|---|---|---|---|---|
| CogVideoX-Fun-V1.5-5b-InP | 20.0 GB | 🤗Link | 😄Link | 官方的图生视频权重。支持多分辨率(512,768,1024)的视频预测,以85帧、每秒8帧进行训练 |
| CogVideoX-Fun-V1.5-Reward-LoRAs | - | 🤗Link | 😄Link | 官方的奖励反向传播技术模型,优化CogVideoX-Fun-V1.5生成的视频,使其更好地符合人类偏好。 |
V1.1:
| 名称 | 存储空间 | Hugging Face | Model Scope | 描述 |
|---|---|---|---|---|
| CogVideoX-Fun-V1.1-2b-InP | 13.0 GB | 🤗Link | 😄Link | 官方的图生视频权重。支持多分辨率(512,768,1024,1280)的视频预测,以49帧、每秒8帧进行训练 |
| CogVideoX-Fun-V1.1-5b-InP | 20.0 GB | 🤗Link | 😄Link | 官方的图生视频权重。添加了Noise,运动幅度相比于V1.0更大。支持多分辨率(512,768,1024,1280)的视频预测,以49帧、每秒8帧进行训练 |
| CogVideoX-Fun-V1.1-2b-Pose | 13.0 GB | 🤗Link | 😄Link | 官方的姿态控制生视频权重。支持多分辨率(512,768,1024,1280)的视频预测,以49帧、每秒8帧进行训练 |
| CogVideoX-Fun-V1.1-2b-Control | 13.0 GB | 🤗Link | 😄Link | 官方的控制生视频权重。支持多分辨率(512,768,1024,1280)的视频预测,以49帧、每秒8帧进行训练。支持不同的控制条件,如Canny、Depth、Pose、MLSD等 |
| CogVideoX-Fun-V1.1-5b-Pose | 20.0 GB | 🤗Link | 😄Link | 官方的姿态控制生视频权重。支持多分辨率(512,768,1024,1280)的视频预测,以49帧、每秒8帧进行训练 |
| CogVideoX-Fun-V1.1-5b-Control | 20.0 GB | 🤗Link | 😄Link | 官方的控制生视频权重。支持多分辨率(512,768,1024,1280)的视频预测,以49帧、每秒8帧进行训练。支持不同的控制条件,如Canny、Depth、Pose、MLSD等 |
| CogVideoX-Fun-V1.1-Reward-LoRAs | - | 🤗Link | 😄Link | 官方的奖励反向传播技术模型,优化CogVideoX-Fun-V1.1生成的视频,使其更好地符合人类偏好。 |
(Obsolete) V1.0:
| 名称 | 存储空间 | Hugging Face | Model Scope | 描述 |
|---|---|---|---|---|
| CogVideoX-Fun-2b-InP | 13.0 GB | 🤗Link | 😄Link | 官方的图生视频权重。支持多分辨率(512,768,1024,1280)的视频预测,以49帧、每秒8帧进行训练 |
| CogVideoX-Fun-5b-InP | 20.0 GB | 🤗Link | 😄Link | 官方的图生视频权重。支持多分辨率(512,768,1024,1280)的视频预测,以49帧、每秒8帧进行训练 |
参考文献
- CogVideo: https://github.com/THUDM/CogVideo/
- EasyAnimate: https://github.com/aigc-apps/EasyAnimate
- Wan2.1: https://github.com/Wan-Video/Wan2.1/
- Wan2.2: https://github.com/Wan-Video/Wan2.2/
- ComfyUI-KJNodes: https://github.com/kijai/ComfyUI-KJNodes
- ComfyUI-EasyAnimateWrapper: https://github.com/kijai/ComfyUI-EasyAnimateWrapper
- ComfyUI-CameraCtrl-Wrapper: https://github.com/chaojie/ComfyUI-CameraCtrl-Wrapper
- CameraCtrl: https://github.com/hehao13/CameraCtrl
许可证
本项目采用 Apache License (Version 2.0).
CogVideoX-2B 模型 (包括其对应的Transformers模块,VAE模块) 根据 Apache 2.0 协议 许可证发布。
CogVideoX-5B 模型(Transformer 模块)在CogVideoX许可证下发布.