Compare commits
| Author | SHA1 | Date | |
|---|---|---|---|
 皓童 |
af5cf1ccc0 | ||
|
皓童
|
0ed54e05e4 | ||
|
皓童
|
27a2b7833f | ||
|
皓童
|
6c8ce55888 | ||
|
皓童
|
448cdba522 | ||
|
皓童
|
2a29446d45 | ||
|
maochaojie
|
cd33b4ab15 | ||
|
maochaojie
|
7d7943fed3 | ||
|
jiangzeyinzi
|
d48b2f110f | ||
|
Great
|
82486adf38 | ||
|
maochaojie
|
a683061c6f | ||
|
mcj
|
4ec0492897 | ||
|
LouieStark
|
aac85fa94f | ||
|
LouieStark
|
3f267aaea2 | ||
|
LouieStark
|
53357f95d6 | ||
|
mcj
|
02c0ba9757 | ||
|
LouieStark
|
cef93bdbfe | ||
|
jiangzeyinzi
|
82132ff3a1 | ||
|
LouieStark
|
b886400e06 | ||
|
mcj
|
73984c4f9e | ||
|
LouieStark
|
f98adabeb3 | ||
|
jiangzeyinzi
|
edb46a615c | ||
|
LouieStark
|
fe3e11b49e | ||
|
LouieStark
|
e6b43f19f6 | ||
|
jiangzeyinzi
|
d9b207cf5b | ||
|
LouieStark
|
986349deac | ||
|
LouieStark
|
3f047be43c | ||
|
LouieStark
|
e8d8e63cba | ||
|
jiangzeyinzi
|
eac03e9856 | ||
|
jiangzeyinzi
|
379b94ab4f | ||
|
jiangzeyinzi
|
342c6b8a15 | ||
|
jiangzeyinzi
|
4ddcb08c7b | ||
|
jiangzeyinzi
|
b2169a1597 | ||
|
jiangzeyinzi
|
cffd54a02a | ||
|
zeyinzi.jzyz
|
0bba2c319d | ||
|
LouieStark
|
7d6451efad | ||
|
LouieStark
|
a5decd17aa | ||
|
jiangzeyinzi
|
8a14866562 | ||
|
jiangzeyinzi
|
5a94f6c4a2 | ||
|
Great
|
4ad0f6038c | ||
|
Great
|
4f56623627 | ||
|
jiangzeyinzi
|
30afc0a1de | ||
|
Great
|
aeabef75b4 | ||
|
jiangzeyinzi
|
9376149415 | ||
|
zeyinzi.jzyz
|
01fd8335af | ||
|
Zhen Han
|
7a9f90efb2 | ||
|
Zhen Han
|
cbbef4a2da | ||
|
hanzhen.hz
|
b242449b25 | ||
|
jiangzeyinzi
|
2fb8fd1872 | ||
|
jiangzeyinzi
|
ef82a32944 | ||
|
hanzhn
|
aa7e959330 | ||
|
hanzhn
|
edff6352d5 | ||
|
hanzhn
|
aa8250e5d2 | ||
|
hanzhn
|
e7255aac25 | ||
|
Zhen Han
|
b752ff1cbc | ||
|
Zhen Han
|
8b08629bd0 | ||
|
hanzhn
|
c70ef0fc47 | ||
|
Zhen Han
|
8076aae7da |
@@ -9,12 +9,12 @@
|
||||
*.bin
|
||||
*.idea
|
||||
*.csv
|
||||
cache
|
||||
build
|
||||
dist
|
||||
dev
|
||||
scepter.egg-info
|
||||
.readthedocs.yml
|
||||
1.9
|
||||
MANIFEST.in
|
||||
*resources
|
||||
*.ipynb_checkpoints*
|
||||
*.vscode
|
||||
|
||||

|
After Width: | Height: | Size: 90 KiB |

|
After Width: | Height: | Size: 72 KiB |

|
After Width: | Height: | Size: 62 KiB |

|
After Width: | Height: | Size: 66 KiB |

|
After Width: | Height: | Size: 66 KiB |

|
After Width: | Height: | Size: 27 KiB |

|
After Width: | Height: | Size: 87 KiB |

|
After Width: | Height: | Size: 91 KiB |

|
After Width: | Height: | Size: 27 KiB |

|
After Width: | Height: | Size: 72 KiB |

|
After Width: | Height: | Size: 64 KiB |

|
After Width: | Height: | Size: 74 KiB |

|
After Width: | Height: | Size: 36 KiB |

|
After Width: | Height: | Size: 44 KiB |

|
After Width: | Height: | Size: 140 KiB |

|
After Width: | Height: | Size: 99 KiB |

|
After Width: | Height: | Size: 97 KiB |

|
After Width: | Height: | Size: 48 KiB |

|
After Width: | Height: | Size: 56 KiB |

|
After Width: | Height: | Size: 88 KiB |

|
After Width: | Height: | Size: 97 KiB |

|
After Width: | Height: | Size: 62 KiB |

|
After Width: | Height: | Size: 53 KiB |

|
After Width: | Height: | Size: 378 KiB |
@@ -0,0 +1,163 @@
|
||||
{
|
||||
"last_node_id": 4,
|
||||
"last_link_id": 3,
|
||||
"nodes": [
|
||||
{
|
||||
"id": 2,
|
||||
"type": "PreviewImage",
|
||||
"pos": {
|
||||
"0": 937,
|
||||
"1": 243
|
||||
},
|
||||
"size": {
|
||||
"0": 284.03680419921875,
|
||||
"1": 246
|
||||
},
|
||||
"flags": {
|
||||
"collapsed": false
|
||||
},
|
||||
"order": 2,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "images",
|
||||
"type": "IMAGE",
|
||||
"link": 1
|
||||
}
|
||||
],
|
||||
"outputs": [],
|
||||
"properties": {
|
||||
"Node name for S&R": "PreviewImage"
|
||||
},
|
||||
"widgets_values": []
|
||||
},
|
||||
{
|
||||
"id": 4,
|
||||
"type": "ParameterNode",
|
||||
"pos": {
|
||||
"0": 0,
|
||||
"1": 244
|
||||
},
|
||||
"size": {
|
||||
"0": 311.9849853515625,
|
||||
"1": 236.4765625
|
||||
},
|
||||
"flags": {},
|
||||
"order": 0,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
3
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ParameterNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"ddim",
|
||||
50,
|
||||
5,
|
||||
0.5,
|
||||
"trailing",
|
||||
1024,
|
||||
1024,
|
||||
2024
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 1,
|
||||
"type": "ModelNode",
|
||||
"pos": {
|
||||
"0": 430,
|
||||
"1": 243
|
||||
},
|
||||
"size": {
|
||||
"0": 400,
|
||||
"1": 234
|
||||
},
|
||||
"flags": {},
|
||||
"order": 1,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "parameters",
|
||||
"type": "CONDITIONING",
|
||||
"link": 3,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "mantras",
|
||||
"type": "CONDITIONING",
|
||||
"link": null,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "tuners",
|
||||
"type": "CONDITIONING",
|
||||
"link": null,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "controls",
|
||||
"type": "CONDITIONING",
|
||||
"link": null,
|
||||
"shape": 7
|
||||
}
|
||||
],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "IMAGE",
|
||||
"type": "IMAGE",
|
||||
"links": [
|
||||
1
|
||||
],
|
||||
"slot_index": 0
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ModelNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"SD_XL1.0",
|
||||
"ModelScope",
|
||||
"a cat",
|
||||
""
|
||||
]
|
||||
}
|
||||
],
|
||||
"links": [
|
||||
[
|
||||
1,
|
||||
1,
|
||||
0,
|
||||
2,
|
||||
0,
|
||||
"IMAGE"
|
||||
],
|
||||
[
|
||||
3,
|
||||
4,
|
||||
0,
|
||||
1,
|
||||
0,
|
||||
"CONDITIONING"
|
||||
]
|
||||
],
|
||||
"groups": [],
|
||||
"config": {},
|
||||
"extra": {
|
||||
"ds": {
|
||||
"scale": 0.9229599817706423,
|
||||
"offset": [
|
||||
128.91466506592707,
|
||||
43.07074577975898
|
||||
]
|
||||
}
|
||||
},
|
||||
"version": 0.4
|
||||
}
|
||||

|
After Width: | Height: | Size: 291 KiB |
@@ -0,0 +1,202 @@
|
||||
{
|
||||
"last_node_id": 5,
|
||||
"last_link_id": 4,
|
||||
"nodes": [
|
||||
{
|
||||
"id": 2,
|
||||
"type": "PreviewImage",
|
||||
"pos": {
|
||||
"0": 937,
|
||||
"1": 243
|
||||
},
|
||||
"size": {
|
||||
"0": 284.03680419921875,
|
||||
"1": 246
|
||||
},
|
||||
"flags": {
|
||||
"collapsed": false
|
||||
},
|
||||
"order": 3,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "images",
|
||||
"type": "IMAGE",
|
||||
"link": 1
|
||||
}
|
||||
],
|
||||
"outputs": [],
|
||||
"properties": {
|
||||
"Node name for S&R": "PreviewImage"
|
||||
},
|
||||
"widgets_values": []
|
||||
},
|
||||
{
|
||||
"id": 4,
|
||||
"type": "ParameterNode",
|
||||
"pos": {
|
||||
"0": 0,
|
||||
"1": 244
|
||||
},
|
||||
"size": {
|
||||
"0": 311.9849853515625,
|
||||
"1": 236.4765625
|
||||
},
|
||||
"flags": {},
|
||||
"order": 0,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
3
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ParameterNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"ddim",
|
||||
50,
|
||||
5,
|
||||
0.5,
|
||||
"trailing",
|
||||
1024,
|
||||
1024,
|
||||
2024
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 1,
|
||||
"type": "ModelNode",
|
||||
"pos": {
|
||||
"0": 430,
|
||||
"1": 243
|
||||
},
|
||||
"size": {
|
||||
"0": 400,
|
||||
"1": 234
|
||||
},
|
||||
"flags": {},
|
||||
"order": 2,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "parameters",
|
||||
"type": "CONDITIONING",
|
||||
"link": 3,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "mantras",
|
||||
"type": "CONDITIONING",
|
||||
"link": 4,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "tuners",
|
||||
"type": "CONDITIONING",
|
||||
"link": null,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "controls",
|
||||
"type": "CONDITIONING",
|
||||
"link": null,
|
||||
"shape": 7
|
||||
}
|
||||
],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "IMAGE",
|
||||
"type": "IMAGE",
|
||||
"links": [
|
||||
1
|
||||
],
|
||||
"slot_index": 0
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ModelNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"SD_XL1.0",
|
||||
"ModelScope",
|
||||
"a cat",
|
||||
""
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 5,
|
||||
"type": "MantrasNode",
|
||||
"pos": {
|
||||
"0": 3,
|
||||
"1": 547
|
||||
},
|
||||
"size": {
|
||||
"0": 315,
|
||||
"1": 58
|
||||
},
|
||||
"flags": {},
|
||||
"order": 1,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
4
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "MantrasNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"Flat 2D Art"
|
||||
]
|
||||
}
|
||||
],
|
||||
"links": [
|
||||
[
|
||||
1,
|
||||
1,
|
||||
0,
|
||||
2,
|
||||
0,
|
||||
"IMAGE"
|
||||
],
|
||||
[
|
||||
3,
|
||||
4,
|
||||
0,
|
||||
1,
|
||||
0,
|
||||
"CONDITIONING"
|
||||
],
|
||||
[
|
||||
4,
|
||||
5,
|
||||
0,
|
||||
1,
|
||||
1,
|
||||
"CONDITIONING"
|
||||
]
|
||||
],
|
||||
"groups": [],
|
||||
"config": {},
|
||||
"extra": {
|
||||
"ds": {
|
||||
"scale": 1.0152559799477068,
|
||||
"offset": [
|
||||
58.35814123566077,
|
||||
-65.12749162217047
|
||||
]
|
||||
}
|
||||
},
|
||||
"version": 0.4
|
||||
}
|
||||

|
After Width: | Height: | Size: 230 KiB |
@@ -0,0 +1,242 @@
|
||||
{
|
||||
"last_node_id": 6,
|
||||
"last_link_id": 5,
|
||||
"nodes": [
|
||||
{
|
||||
"id": 2,
|
||||
"type": "PreviewImage",
|
||||
"pos": {
|
||||
"0": 937,
|
||||
"1": 243
|
||||
},
|
||||
"size": {
|
||||
"0": 284.03680419921875,
|
||||
"1": 246
|
||||
},
|
||||
"flags": {
|
||||
"collapsed": false
|
||||
},
|
||||
"order": 4,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "images",
|
||||
"type": "IMAGE",
|
||||
"link": 1
|
||||
}
|
||||
],
|
||||
"outputs": [],
|
||||
"properties": {
|
||||
"Node name for S&R": "PreviewImage"
|
||||
},
|
||||
"widgets_values": []
|
||||
},
|
||||
{
|
||||
"id": 4,
|
||||
"type": "ParameterNode",
|
||||
"pos": {
|
||||
"0": 0,
|
||||
"1": 244
|
||||
},
|
||||
"size": {
|
||||
"0": 311.9849853515625,
|
||||
"1": 236.4765625
|
||||
},
|
||||
"flags": {},
|
||||
"order": 0,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
3
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ParameterNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"ddim",
|
||||
50,
|
||||
5,
|
||||
0.5,
|
||||
"trailing",
|
||||
1024,
|
||||
1024,
|
||||
2024
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 5,
|
||||
"type": "MantrasNode",
|
||||
"pos": {
|
||||
"0": 3,
|
||||
"1": 547
|
||||
},
|
||||
"size": {
|
||||
"0": 315,
|
||||
"1": 58
|
||||
},
|
||||
"flags": {},
|
||||
"order": 1,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
4
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "MantrasNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"Flat 2D Art"
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 1,
|
||||
"type": "ModelNode",
|
||||
"pos": {
|
||||
"0": 430,
|
||||
"1": 243
|
||||
},
|
||||
"size": {
|
||||
"0": 400,
|
||||
"1": 234
|
||||
},
|
||||
"flags": {},
|
||||
"order": 3,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "parameters",
|
||||
"type": "CONDITIONING",
|
||||
"link": 3,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "mantras",
|
||||
"type": "CONDITIONING",
|
||||
"link": 4,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "tuners",
|
||||
"type": "CONDITIONING",
|
||||
"link": 5,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "controls",
|
||||
"type": "CONDITIONING",
|
||||
"link": null,
|
||||
"shape": 7
|
||||
}
|
||||
],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "IMAGE",
|
||||
"type": "IMAGE",
|
||||
"links": [
|
||||
1
|
||||
],
|
||||
"slot_index": 0
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ModelNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"SD_XL1.0",
|
||||
"ModelScope",
|
||||
"a cat",
|
||||
""
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 6,
|
||||
"type": "TunerNode",
|
||||
"pos": {
|
||||
"0": 8,
|
||||
"1": 680
|
||||
},
|
||||
"size": {
|
||||
"0": 315,
|
||||
"1": 82
|
||||
},
|
||||
"flags": {},
|
||||
"order": 2,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
5
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "TunerNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"SD_XL1.0_Pencil Sketch Drawing",
|
||||
1
|
||||
]
|
||||
}
|
||||
],
|
||||
"links": [
|
||||
[
|
||||
1,
|
||||
1,
|
||||
0,
|
||||
2,
|
||||
0,
|
||||
"IMAGE"
|
||||
],
|
||||
[
|
||||
3,
|
||||
4,
|
||||
0,
|
||||
1,
|
||||
0,
|
||||
"CONDITIONING"
|
||||
],
|
||||
[
|
||||
4,
|
||||
5,
|
||||
0,
|
||||
1,
|
||||
1,
|
||||
"CONDITIONING"
|
||||
],
|
||||
[
|
||||
5,
|
||||
6,
|
||||
0,
|
||||
1,
|
||||
2,
|
||||
"CONDITIONING"
|
||||
]
|
||||
],
|
||||
"groups": [],
|
||||
"config": {},
|
||||
"extra": {
|
||||
"ds": {
|
||||
"scale": 0.6934334949441366,
|
||||
"offset": [
|
||||
450.0923948318967,
|
||||
30.783653239467935
|
||||
]
|
||||
}
|
||||
},
|
||||
"version": 0.4
|
||||
}
|
||||

|
After Width: | Height: | Size: 355 KiB |
@@ -0,0 +1,366 @@
|
||||
{
|
||||
"last_node_id": 11,
|
||||
"last_link_id": 9,
|
||||
"nodes": [
|
||||
{
|
||||
"id": 1,
|
||||
"type": "ModelNode",
|
||||
"pos": {
|
||||
"0": 439,
|
||||
"1": 123
|
||||
},
|
||||
"size": {
|
||||
"0": 400,
|
||||
"1": 234
|
||||
},
|
||||
"flags": {},
|
||||
"order": 6,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "parameters",
|
||||
"type": "CONDITIONING",
|
||||
"link": 3,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "mantras",
|
||||
"type": "CONDITIONING",
|
||||
"link": 4,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "tuners",
|
||||
"type": "CONDITIONING",
|
||||
"link": 5,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "controls",
|
||||
"type": "CONDITIONING",
|
||||
"link": 6,
|
||||
"shape": 7
|
||||
}
|
||||
],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "IMAGE",
|
||||
"type": "IMAGE",
|
||||
"links": [
|
||||
1
|
||||
],
|
||||
"slot_index": 0
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ModelNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"SD_XL1.0",
|
||||
"ModelScope",
|
||||
"a cat",
|
||||
""
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 5,
|
||||
"type": "MantrasNode",
|
||||
"pos": {
|
||||
"0": 13,
|
||||
"1": 336
|
||||
},
|
||||
"size": {
|
||||
"0": 315,
|
||||
"1": 58
|
||||
},
|
||||
"flags": {},
|
||||
"order": 0,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
4
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "MantrasNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"Flat 2D Art"
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 6,
|
||||
"type": "TunerNode",
|
||||
"pos": {
|
||||
"0": 12,
|
||||
"1": 455
|
||||
},
|
||||
"size": {
|
||||
"0": 315,
|
||||
"1": 82
|
||||
},
|
||||
"flags": {},
|
||||
"order": 1,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
5
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "TunerNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"SD_XL1.0_Pencil Sketch Drawing",
|
||||
1
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 11,
|
||||
"type": "NoteNode",
|
||||
"pos": {
|
||||
"0": 845,
|
||||
"1": 506
|
||||
},
|
||||
"size": {
|
||||
"0": 398.3059387207031,
|
||||
"1": 210.83267211914062
|
||||
},
|
||||
"flags": {},
|
||||
"order": 2,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [],
|
||||
"properties": {
|
||||
"Node name for S&R": "NoteNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"This is a sample for quickly setting up ComfyUI using the Scepter open-source library:\n\n1) The first run involves downloading the models. By default, we will automatically pull models from ModelScope. The initial download may take some time, and you can also adjust the model source to change the model address.\n\n2) Currently, it supports various base models, basic settings for some inference hyperparameters, mantra settings, tuning model settings, and conditional generation node.\n\n3) In the future, we will gradually integrate interesting features to enrich the use cases.\n\n"
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 8,
|
||||
"type": "LoadImage",
|
||||
"pos": {
|
||||
"0": 471,
|
||||
"1": 451
|
||||
},
|
||||
"size": {
|
||||
"0": 315,
|
||||
"1": 314
|
||||
},
|
||||
"flags": {},
|
||||
"order": 3,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "IMAGE",
|
||||
"type": "IMAGE",
|
||||
"links": [
|
||||
7
|
||||
]
|
||||
},
|
||||
{
|
||||
"name": "MASK",
|
||||
"type": "MASK",
|
||||
"links": null
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "LoadImage"
|
||||
},
|
||||
"widgets_values": [
|
||||
"cat.jpg",
|
||||
"image"
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 7,
|
||||
"type": "ControlNode",
|
||||
"pos": {
|
||||
"0": 15,
|
||||
"1": 600
|
||||
},
|
||||
"size": {
|
||||
"0": 330,
|
||||
"1": 198
|
||||
},
|
||||
"flags": {},
|
||||
"order": 5,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "source_image",
|
||||
"type": "IMAGE",
|
||||
"link": 7
|
||||
}
|
||||
],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
6
|
||||
]
|
||||
},
|
||||
{
|
||||
"name": "Control Image",
|
||||
"type": "IMAGE",
|
||||
"links": [],
|
||||
"slot_index": 1
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ControlNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"SD_XL1.0_color",
|
||||
"Color",
|
||||
"CenterCrop",
|
||||
1,
|
||||
1024,
|
||||
1024
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 2,
|
||||
"type": "PreviewImage",
|
||||
"pos": {
|
||||
"0": 959,
|
||||
"1": 121
|
||||
},
|
||||
"size": {
|
||||
"0": 284.03680419921875,
|
||||
"1": 246
|
||||
},
|
||||
"flags": {
|
||||
"collapsed": false
|
||||
},
|
||||
"order": 7,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "images",
|
||||
"type": "IMAGE",
|
||||
"link": 1
|
||||
}
|
||||
],
|
||||
"outputs": [],
|
||||
"properties": {
|
||||
"Node name for S&R": "PreviewImage"
|
||||
},
|
||||
"widgets_values": []
|
||||
},
|
||||
{
|
||||
"id": 4,
|
||||
"type": "ParameterNode",
|
||||
"pos": {
|
||||
"0": 13,
|
||||
"1": 43
|
||||
},
|
||||
"size": {
|
||||
"0": 311.9849853515625,
|
||||
"1": 236.4765625
|
||||
},
|
||||
"flags": {},
|
||||
"order": 4,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
3
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ParameterNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"ddim",
|
||||
50,
|
||||
5,
|
||||
0.5,
|
||||
"trailing",
|
||||
1024,
|
||||
1024,
|
||||
2024
|
||||
]
|
||||
}
|
||||
],
|
||||
"links": [
|
||||
[
|
||||
1,
|
||||
1,
|
||||
0,
|
||||
2,
|
||||
0,
|
||||
"IMAGE"
|
||||
],
|
||||
[
|
||||
3,
|
||||
4,
|
||||
0,
|
||||
1,
|
||||
0,
|
||||
"CONDITIONING"
|
||||
],
|
||||
[
|
||||
4,
|
||||
5,
|
||||
0,
|
||||
1,
|
||||
1,
|
||||
"CONDITIONING"
|
||||
],
|
||||
[
|
||||
5,
|
||||
6,
|
||||
0,
|
||||
1,
|
||||
2,
|
||||
"CONDITIONING"
|
||||
],
|
||||
[
|
||||
6,
|
||||
7,
|
||||
0,
|
||||
1,
|
||||
3,
|
||||
"CONDITIONING"
|
||||
],
|
||||
[
|
||||
7,
|
||||
8,
|
||||
0,
|
||||
7,
|
||||
0,
|
||||
"IMAGE"
|
||||
]
|
||||
],
|
||||
"groups": [],
|
||||
"config": {},
|
||||
"extra": {
|
||||
"ds": {
|
||||
"scale": 0.7627768444385667,
|
||||
"offset": [
|
||||
254.62860058494985,
|
||||
87.05734194144193
|
||||
]
|
||||
}
|
||||
},
|
||||
"version": 0.4
|
||||
}
|
||||

|
After Width: | Height: | Size: 634 KiB |
@@ -1,4 +1,5 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
# Configuration file for the Sphinx documentation builder.
|
||||
#
|
||||
# This file only contains a selection of the most common options. For a full
|
||||
|
||||
@@ -29,8 +29,21 @@ Given an original image, image editing aims to generate an image that align with
|
||||
<td><img src="../../../asset/images/stylebooth/retrogame.jpeg" width="240"></td>
|
||||
<td><img src="../../../asset/images/stylebooth/vangogh.jpeg" width="240"></td>
|
||||
</tr>
|
||||
<tr>
|
||||
<td><strong>Origin Image</strong></td>
|
||||
<td><strong>Lowpoly</strong></td>
|
||||
<td><strong>Colored Pencil Art</strong></td>
|
||||
<td><strong>Watercolor</strong></td>
|
||||
<td><strong>misc-disco</strong></td>
|
||||
</tr>
|
||||
<tr>
|
||||
<td><img src="../../../asset/images/stylebooth/mountain.jpg" width="240"></td>
|
||||
<td><img src="../../../asset/images/stylebooth/lowpoly.jpg" width="240"></td>
|
||||
<td><img src="../../../asset/images/stylebooth/colorpencil.jpeg" width="240"></td>
|
||||
<td><img src="../../../asset/images/stylebooth/watercolor.jpeg" width="240"></td>
|
||||
<td><img src="../../../asset/images/stylebooth/disco.jpeg" width="240"></td>
|
||||
</tr>
|
||||
</table>
|
||||
|
||||
## Features
|
||||
|
||||
| **Text-Based** | **Exemplar-Based** |
|
||||
@@ -43,7 +56,7 @@ Given an original image, image editing aims to generate an image that align with
|
||||
- More models will be released in the future.
|
||||
|
||||
## Run StyleBooth
|
||||
- Code implementation: See model configuration and code based on [🪄SCEPTER](https://github.com/modelscope/scepter).
|
||||
- Code implementation: See model configuration and code based on [🪄SCEPTER](https://github.com/modelscope/scepter/blob/main/docs/en/tasks/stylebooth.md).
|
||||
|
||||
- Demo: Try [🖥️SCEPTER Studio](https://github.com/modelscope/scepter/tree/main?tab=readme-ov-file#%EF%B8%8F-scepter-studio).
|
||||
|
||||
@@ -92,7 +105,7 @@ class DiffusionInferenceTest(unittest.TestCase):
|
||||
output = diff_infer({'prompt': 'Let this image be in the style of sai-lowpoly'},
|
||||
style_edit_image=Image.open('asset/images/inpainting_text_ref/ex4_scene_im.jpg'),
|
||||
style_guide_scale_text=7.5,
|
||||
style_guide_scale_image=0.5)
|
||||
style_guide_scale_image=1.5)
|
||||
save_path = os.path.join(self.tmp_dir,
|
||||
'stylebooth_test_lowpoly_cute_dog.png')
|
||||
save_image(output['images'], save_path)
|
||||
@@ -101,3 +114,17 @@ class DiffusionInferenceTest(unittest.TestCase):
|
||||
if __name__ == '__main__':
|
||||
unittest.main()
|
||||
```
|
||||
|
||||
## StyleTuner and De-StyleTuner.
|
||||
|
||||
### Base I2I Model.
|
||||
|
||||
For style and de-style tuning, we use a private high-resolution I2I model trained with [InstructPix2Pix dataset](https://instruct-pix2pix.eecs.berkeley.edu/) as base model. However, one can try the same tunning process using this [yaml](https://github.com/modelscope/scepter/blob/main/scepter/methods/edit/edit_512_lora.yaml) based on any other I2I model, such as StyleBooth (shown in this yaml), [InstructPix2Pix](https://github.com/timothybrooks/instruct-pix2pix) or [MagicBrush](https://github.com/OSU-NLP-Group/MagicBrush).
|
||||
|
||||
### Training Data.
|
||||
|
||||
Please check the zips for correct format: [De-Text](https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=datasets%2Fdetext.zip), [Image2Hed](https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=datasets%2Fhed_pair.zip), [Image2Depth](https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=datasets%2Fimage2depth.zip), [Depth2Image](https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=datasets%2Fdepth2image.zip).
|
||||
|
||||
### Launch.
|
||||
|
||||
See [code](https://github.com/modelscope/scepter/blob/cbbef4a2da5b66fc33b9f8ece7f2fb4aac9d6e3c/tests/tools/test_train.py#L220) for more information.
|
||||
|
||||
@@ -5,7 +5,7 @@ Below are examples for each format, illustrating their details and basic usage.
|
||||
|
||||
## Modelscope Format
|
||||
|
||||
We use a [custom-stylized dataset](https://modelscope.cn/datasets/damo/style_custom_dataset/summary), which included classes 3D, anime, flat illustration, oil painting, sketch, and watercolor, each with 30 image-text pairs.
|
||||
We use a [custom-stylized dataset](https://modelscope.cn/datasets/iic/style_custom_dataset/summary), which included classes 3D, anime, flat illustration, oil painting, sketch, and watercolor, each with 30 image-text pairs.
|
||||
|
||||
```python
|
||||
# pip install modelscope
|
||||
@@ -16,7 +16,11 @@ print(next(iter(ms_train_dataset)))
|
||||
|
||||
## CSV Format
|
||||
|
||||
For the data format used by SCEPTER Studio, please refer to [3D_example_csv.zip](https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=datasets/3D_example_csv.zip).
|
||||
For the data format used by SCEPTER Studio, please refer to [3D_example_csv.zip](https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=datasets/3D_example_csv.zip) and [hed_pair.zip](https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=datasets%2Fhed_pair.zip).
|
||||
```shell
|
||||
mkdir -p cache/datasets/ && wget 'https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=datasets/3D_example_csv.zip' -O cache/datasets/3D_example_csv.zip && unzip cache/datasets/3D_example_csv.zip -d cache/datasets/ && rm cache/datasets/3D_example_csv.zip
|
||||
mkdir -p cache/datasets/ && wget 'https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=datasets/hed_pair.zip' -O cache/datasets/hed_pair.zip && unzip cache/datasets/hed_pair.zip -d cache/datasets/ && rm cache/datasets/hed_pair.zip
|
||||
```
|
||||
|
||||
## TXT Format
|
||||
|
||||
@@ -24,3 +28,4 @@ To facilitate starting training in command-line mode, you can use a dataset in t
|
||||
|
||||
```shell
|
||||
mkdir -p cache/datasets/ && wget 'https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=datasets/3D_example_txt.zip' -O cache/datasets/3D_example_txt.zip && unzip cache/datasets/3D_example_txt.zip -d cache/datasets/ && rm cache/datasets/3D_example_txt.zip
|
||||
```
|
||||
|
||||
@@ -40,6 +40,6 @@ python scepter/tools/run_inference.py --cfg scepter/methods/scedit/t2i/sd15_512_
|
||||
|
||||
- SCEdit
|
||||
```shell
|
||||
python scepter/tools/run_inference.py --cfg scepter/methods/scedit/ctr/sd21_768_sce_ctr_canny.yaml --num_samples 1 --prompt 'a single flower is shown in front of a tree' --save_folder 'test_flower_canny' --image_size 768 --task control --image 'asset/images/flower.jpg' --control_mode canny --pretrained_model ms://damo/scepter_scedit@controllable_model/SD2.1/canny_control/0_SwiftSCETuning/pytorch_model.bin # canny
|
||||
python scepter/tools/run_inference.py --cfg scepter/methods/scedit/ctr/sd21_768_sce_ctr_pose.yaml --num_samples 1 --prompt 'super mario' --save_folder 'test_mario_pose' --image_size 768 --task control --image 'asset/images/pose_source.png' --control_mode source --pretrained_model ms://damo/scepter_scedit@controllable_model/SD2.1/pose_control/0_SwiftSCETuning/pytorch_model.bin # pose
|
||||
python scepter/tools/run_inference.py --cfg scepter/methods/scedit/ctr/sd21_768_sce_ctr_canny.yaml --num_samples 1 --prompt 'a single flower is shown in front of a tree' --save_folder 'test_flower_canny' --image_size 768 --task control --image 'asset/images/flower.jpg' --control_mode canny --pretrained_model ms://iic/scepter_scedit@controllable_model/SD2.1/canny_control/0_SwiftSCETuning/pytorch_model.bin # canny
|
||||
python scepter/tools/run_inference.py --cfg scepter/methods/scedit/ctr/sd21_768_sce_ctr_pose.yaml --num_samples 1 --prompt 'super mario' --save_folder 'test_mario_pose' --image_size 768 --task control --image 'asset/images/pose_source.png' --control_mode source --pretrained_model ms://iic/scepter_scedit@controllable_model/SD2.1/pose_control/0_SwiftSCETuning/pytorch_model.bin # pose
|
||||
```
|
||||
|
||||
@@ -1,4 +1,5 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
# Configuration file for the Sphinx documentation builder.
|
||||
#
|
||||
# This file only contains a selection of the most common options. For a full
|
||||
|
||||
@@ -6,4 +6,5 @@ dependencies:
|
||||
- pip>=20.3
|
||||
- numpy>=1.23.1
|
||||
- pip:
|
||||
- -r requirements/recommended.txt
|
||||
- -r requirements.txt
|
||||
|
||||
@@ -2,7 +2,6 @@
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
import numpy as np
|
||||
import torchvision
|
||||
|
||||
from scepter.modules.data.dataset.base_dataset import BaseDataset
|
||||
from scepter.modules.data.dataset.registry import DATASETS
|
||||
from scepter.modules.utils.config import dict_to_yaml
|
||||
|
||||
@@ -0,0 +1,22 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
import os
|
||||
import shutil
|
||||
import subprocess
|
||||
import sys
|
||||
|
||||
if sys.argv[0] == 'install.py':
|
||||
sys.path.append('.') # for portable version
|
||||
|
||||
source_folder = os.path.join(os.path.dirname(__file__), "scepter/workflow")
|
||||
current_dir = os.path.dirname(__file__)
|
||||
destination_folder = os.path.join(os.path.dirname(current_dir), "ComfyUI-Scepter")
|
||||
|
||||
if not os.path.exists(destination_folder):
|
||||
shutil.copytree(source_folder, destination_folder)
|
||||
print(f"{os.path.abspath(source_folder)} copy to {os.path.abspath(destination_folder)} success!")
|
||||
else:
|
||||
print(f"{os.path.abspath(destination_folder)} exist.")
|
||||
|
||||
# pip install scepter
|
||||
subprocess.check_call([sys.executable, '-m', 'pip', 'install', 'scepter'])
|
||||
@@ -14,10 +14,19 @@ SCEPTER integrates popular community-driven implementations as well as proprieta
|
||||
SCEPTER offers 3 core components:
|
||||
- [Generative training and inference framework](#tutorials)
|
||||
- [Easy implementation of popular approaches](#currently-supported-approaches)
|
||||
- [Interactive user interface: SCEPTER Studio](#launch)
|
||||
- [Interactive user interface: SCEPTER Studio & Comfy UI](#launch)
|
||||
|
||||
|
||||
## 🎉 News
|
||||
- [🔥🔥🔥2024.11]: We're excited to announce the upcoming release of the [ACE-0.6b-1024px](https://huggingface.co/scepter-studio/ACE-0.6B-1024px) model,
|
||||
which significantly enhances image generation quality compared with [ACE-0.6b-512px](https://huggingface.co/scepter-studio/ACE-0.6B-512px). The detailed documents can be found at [ACE repo](https://github.com/ali-vilab/ACE.git).
|
||||
At the same time, based on the editing results of ACE, combined with the powerful text-to-image capabilities of the [FLUX-dev](https://huggingface.co/black-forest-labs/FLUX.1-dev) model through SDEdit as an image quality refiner, the quality of image editing can be further enhanced.
|
||||
- [🔥2024.11]: Supports video files, video annotation, caption translation in data management, and inference & training of the [CogVideoX](https://arxiv.org/abs/2408.06072).
|
||||
- [2024.10]: We are pleased to announce the release of the code for [ACE](https://arxiv.org/abs/2410.00086), supporting Customized Training / Comfy UI Workflow / gradio-based ChatBot Interface.
|
||||
- [2024.10]: Support for inference and tuning with [FLUX](https://huggingface.co/black-forest-labs/FLUX.1-dev), as well as for building [ComfyUI](https://github.com/comfyanonymous/ComfyUI) workflows using this framework.
|
||||
- [2024.09]: We introduce **ACE**, an **A**ll-round **C**reator and **E**ditor adept at executing a diverse array of image editing tasks tailored to your specifications. Built upon the cutting-edge Diffusion Transformer architecture, ACE has been extensively trained on a comprehensive dataset to seamlessly interpret and execute any natural language instruction. For further information, please consult the [project page](https://ali-vilab.github.io/ace-page/).
|
||||
- [2024.07]: Support the inference and training of open-source generative models based on the [DiT](https://arxiv.org/abs/2212.09748) architecture, such as [SD3](https://arxiv.org/pdf/2403.03206) and [PixArt](https://arxiv.org/abs/2310.00426).
|
||||
- [2024.05]: Introducing SCEPTER v1, supporting customized image edit tasks! Simply provide 10 image pairs, SCEPTER will tune an edit tuner for your own Image-to-Image tasks, like `Clay Style`, `De-Text`, `Segmentation`, etc.
|
||||
- [2024.04]: New [StyleBooth](https://ali-vilab.github.io/stylebooth-page/) demo on SCEPTER Studio for`Text-Based Style Editing`.
|
||||
- [2024.03]: We optimize the training UI and checkpoint management. New [LAR-Gen](https://arxiv.org/abs/2403.19534) model has been added on SCEPTER Studio, supporting `zoom-out`, `virtual try on`, `inpainting`.
|
||||
- [2024.02]: We release new SCEdit controllable image synthesis models for SD v2.1 and SD XL. Multiple strategies applied to accelerate inference time for SCEPTER Studio.
|
||||
@@ -27,61 +36,177 @@ SCEPTER offers 3 core components:
|
||||
- [2023.12]: We release [🪄SCEPTER](https://github.com/modelscope/scepter/) library.
|
||||
|
||||
|
||||
## 🖼 Gallery for Recent Works
|
||||
|
||||
### StyleBooth
|
||||
<table>
|
||||
|
||||
## 🪄ACE
|
||||
|
||||
ACE is a unified foundational model framework that supports a wide range of visual generation tasks. By defining CU for unifying multi-modal inputs across different tasks and incorporating long-context CU, we introduce historical contextual information into visual generation tasks, paving the way for ChatGPT-like dialog systems in visual generation.
|
||||
|
||||
[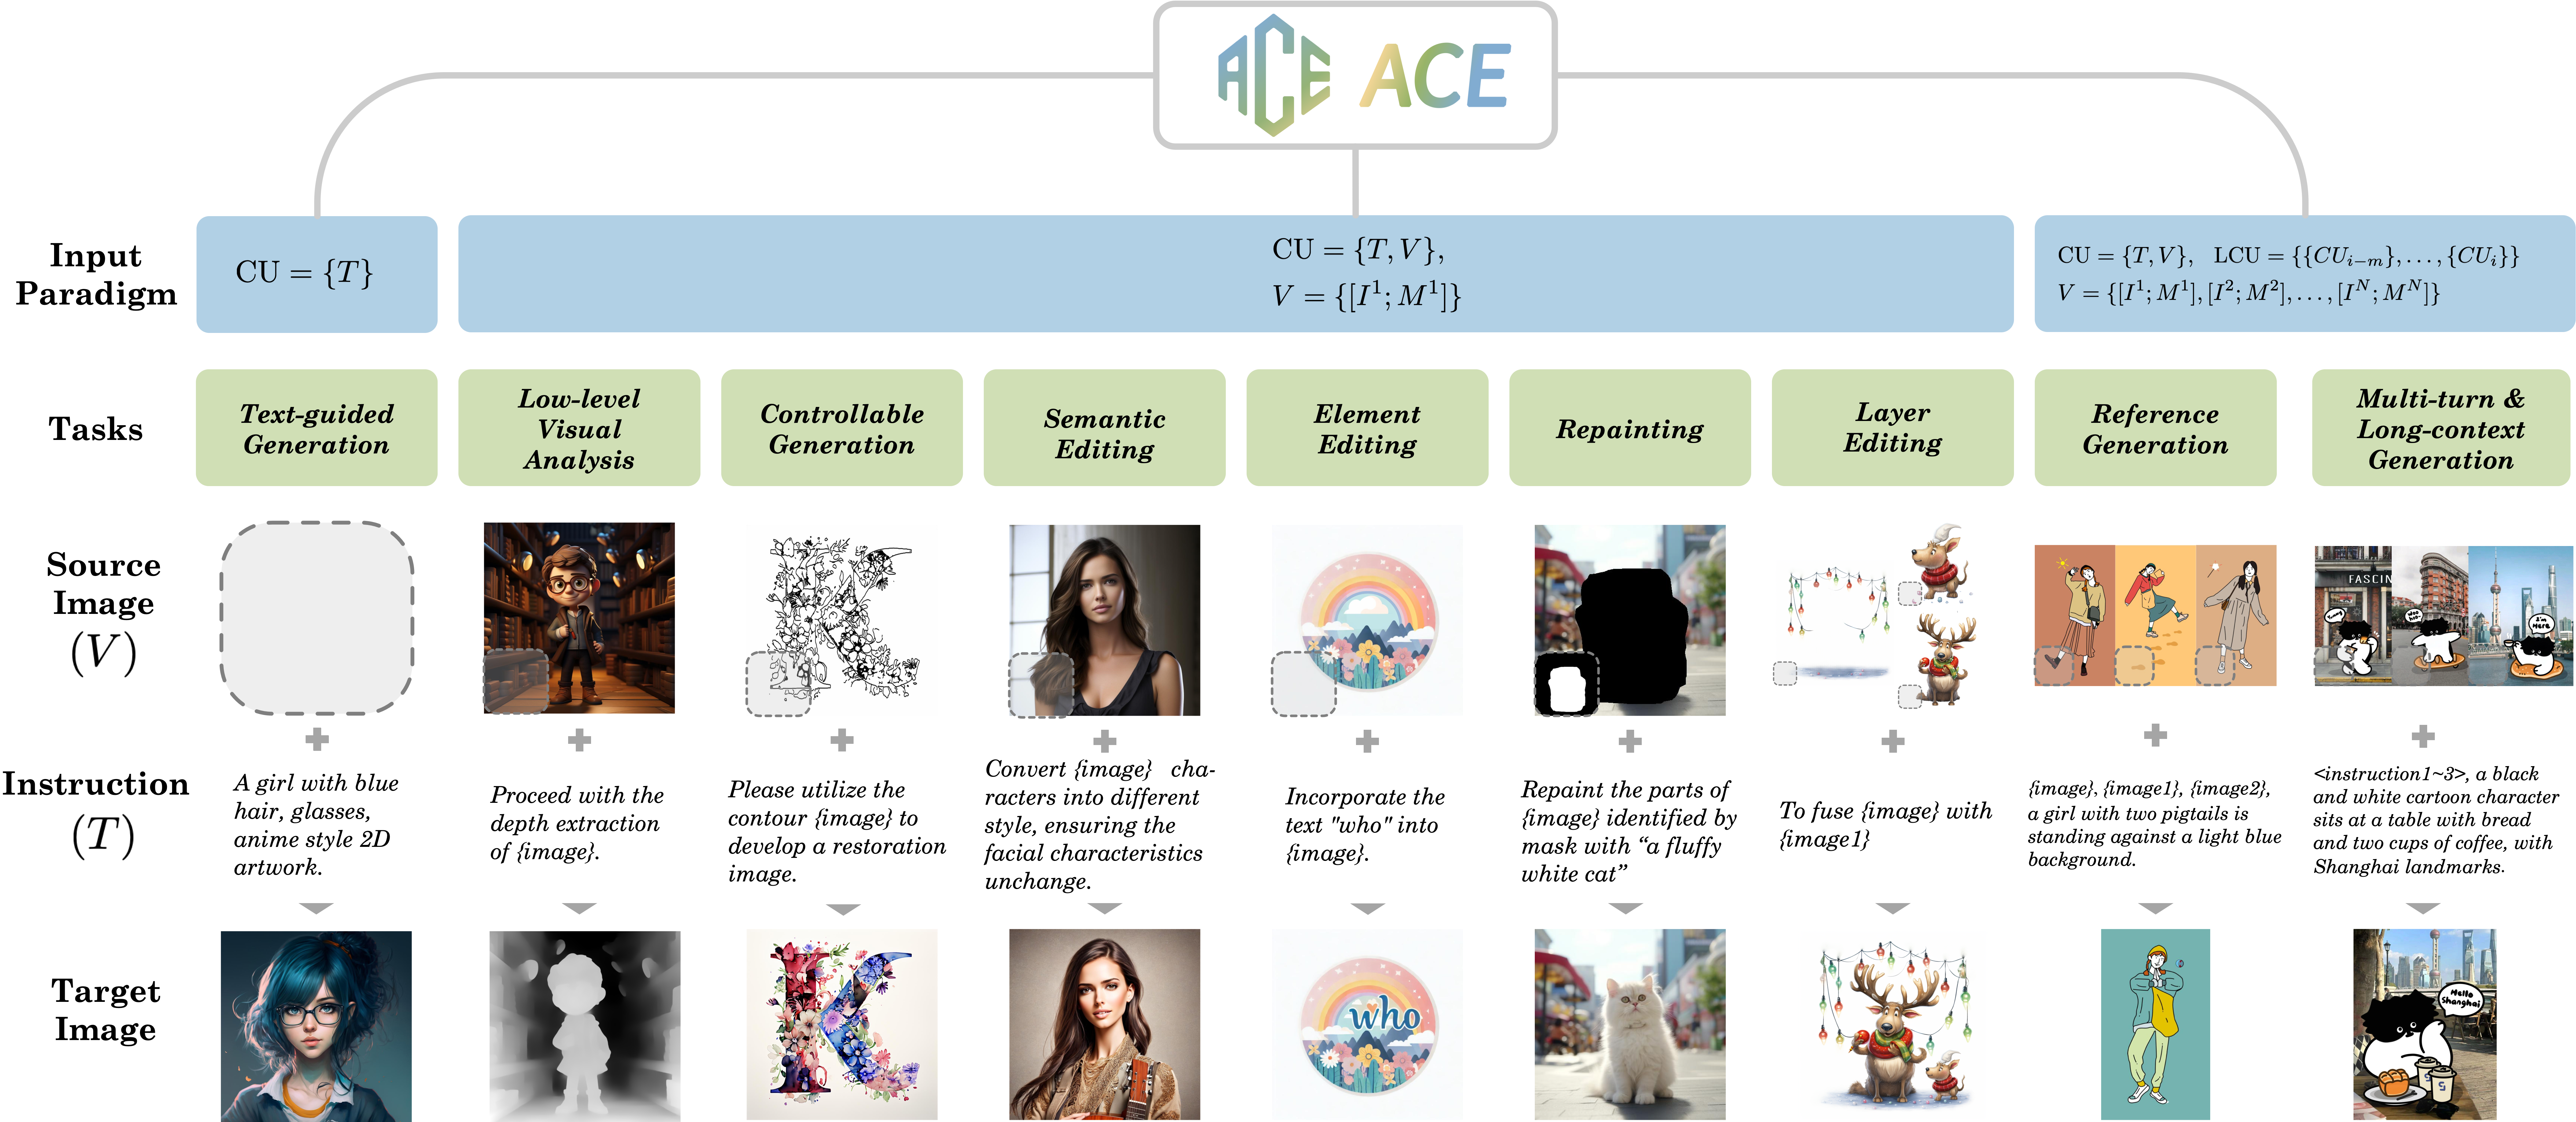](https://ali-vilab.github.io/ace-page/)
|
||||
|
||||
### ACE Models
|
||||
| **Model** | **Status** |
|
||||
|:----------------:|:---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------:|
|
||||
| ACE-0.6B-512px | [](https://huggingface.co/spaces/scepter-studio/ACE-Chat)<br>[](https://www.modelscope.cn/models/iic/ACE-0.6B-512px) [](https://huggingface.co/scepter-studio/ACE-0.6B-512px) |
|
||||
| ACE-0.6B-1024px | [](https://huggingface.co/spaces/scepter-studio/ACE-Refiner-Chat)<br>[](https://www.modelscope.cn/models/iic/ACE-0.6B-1024px) [](https://huggingface.co/scepter-studio/ACE-0.6B-1024px) | |
|
||||
| ACE-12B-FLUX-dev | Coming Soon |
|
||||
### ACE Training
|
||||
|
||||
We offer a demonstration training YAML that enables the end-to-end training of ACE using a toy dataset. For a comprehensive overview of the hyperparameter configurations, please consult `scepter/methods/edit/dit_ace_0.6b_512.yaml`.
|
||||
|
||||
#### Prepare datasets
|
||||
|
||||
Please find the dataset class located in `scepter/modules/data/dataset/ms_dataset.py`,
|
||||
designed to facilitate end-to-end training using an open-source toy dataset.
|
||||
Download a dataset zip file from [modelscope](https://www.modelscope.cn/models/iic/scepter/resolve/master/datasets/hed_pair.zip), and then extract its contents into the `cache/datasets/` directory.
|
||||
|
||||
Should you wish to prepare your own datasets, we recommend consulting `scepter/modules/data/dataset/ms_dataset.py` for detailed guidance on the required data format.
|
||||
|
||||
#### Prepare initial weight
|
||||
The ACE checkpoint has been uploaded to both ModelScope and HuggingFace platforms:
|
||||
* [ModelScope](https://www.modelscope.cn/models/iic/ACE-0.6B-512px)
|
||||
* [HuggingFace](https://huggingface.co/scepter-studio/ACE-0.6B-512px)
|
||||
|
||||
In the provided training YAML configuration, we have designated the Modelscope URL as the default checkpoint URL. Should you wish to transition to Hugging Face, you can effortlessly achieve this by modifying the PRETRAINED_MODEL value within the YAML file (replace the prefix "ms://iic" to "hf://scepter-studio").
|
||||
|
||||
|
||||
#### Start training
|
||||
|
||||
You can easily start training procedure by executing the following command:
|
||||
```bash
|
||||
# ACE-0.6B-512px
|
||||
PYTHONPATH=. python scepter/tools/run_train.py --cfg scepter/methods/edit/dit_ace_0.6b_512.yaml
|
||||
# ACE-0.6B-1024px
|
||||
PYTHONPATH=. python scepter/tools/run_train.py --cfg scepter/methods/edit/dit_ace_0.6b_1024.yaml
|
||||
```
|
||||
|
||||
### ACE Chat Bot
|
||||
|
||||
We have developed a chatbot interface utilizing Gradio, designed to convert user input in natural language into visually captivating images that align semantically with the specified instructions. You can easily access this functionality by launching Scepter Studio with the following command:
|
||||
```bash
|
||||
PYTHONPATH=. python scepter/tools/webui.py --cfg scepter/methods/studio/scepter_ui.yaml --language zh --tab chatbot
|
||||
```
|
||||
Upon starting, you will find a "ChatBot" tab within the Gradio application, which serves as a chat-based interface to handle any requests related to image editing or generation.
|
||||
|
||||
### ACE ComfyUI Workflow
|
||||
|
||||

|
||||
|
||||
<table><tbody>
|
||||
<tr>
|
||||
<td><strong>Origin Image</strong><br>Gold Dragon Tuner</td>
|
||||
<td><strong>Graffiti Art</strong></td>
|
||||
<td><strong>Adorable Kawaii</strong></td>
|
||||
<td><strong>game-retro game</strong></td>
|
||||
<td><strong>Vincent van Gogh</strong></td>
|
||||
<th align="center" colspan="4">ACE Workflow Examples</th>
|
||||
</tr>
|
||||
<tr>
|
||||
<td><img src="asset/images/scedit/tuner_gold_dragon.jpeg" width="240"></td>
|
||||
<td><img src="asset/images/stylebooth/graffiti.jpeg" width="240"></td>
|
||||
<td><img src="asset/images/stylebooth/kawaii.jpeg" width="240"></td>
|
||||
<td><img src="asset/images/stylebooth/retrogame.jpeg" width="240"></td>
|
||||
<td><img src="asset/images/stylebooth/vangogh.jpeg" width="240"></td>
|
||||
<th align="center" colspan="1">Control</th>
|
||||
<th align="center" colspan="1">Semantic</th>
|
||||
<th align="center" colspan="1">Element</th>
|
||||
</tr>
|
||||
<tr>
|
||||
<td>
|
||||
<a href="https://github.com/ali-vilab/ace-page/raw/main/assets/comfyui/ace_control.png" target="_blank">
|
||||
<img src="https://github.com/ali-vilab/ace-page/raw/main/assets/comfyui/ace_control.png" width="200">
|
||||
</a>
|
||||
</td>
|
||||
<td>
|
||||
<a href="https://github.com/ali-vilab/ace-page/raw/main/assets/comfyui/ace_semantic.png" target="_blank">
|
||||
<img src="https://github.com/ali-vilab/ace-page/raw/main/assets/comfyui/ace_semantic.png" width="200">
|
||||
</a>
|
||||
</td>
|
||||
<td>
|
||||
<a href="https://github.com/ali-vilab/ace-page/raw/main/assets/comfyui/ace_element.png" target="_blank">
|
||||
<img src="https://github.com/ali-vilab/ace-page/raw/main/assets/comfyui/ace_element.png" width="200">
|
||||
</a>
|
||||
</td>
|
||||
</tr>
|
||||
</tbody>
|
||||
</table>
|
||||
|
||||
<table>
|
||||
## 🖼 Gallery for Recent Works
|
||||
|
||||
### FLUX Tuners
|
||||
|
||||
<table><tbody>
|
||||
<tr>
|
||||
<td><strong>Origin Image</strong></td>
|
||||
<td><strong>Lowpoly</strong></td>
|
||||
<td><strong>Colored Pencil Art</strong></td>
|
||||
<td><strong>Watercolor</strong></td>
|
||||
<td><strong>misc-disco</strong></td>
|
||||
<th align="center" colspan="3">Yarn Style</th>
|
||||
<th align="center" colspan="3">Soft Watercolor Style</th>
|
||||
</tr>
|
||||
<tr>
|
||||
<td><img src="asset/images/stylebooth/mountain.jpg" width="240"></td>
|
||||
<td><img src="asset/images/stylebooth/lowpoly.jpg" width="240"></td>
|
||||
<td><img src="asset/images/stylebooth/colorpencil.jpeg" width="240"></td>
|
||||
<td><img src="asset/images/stylebooth/watercolor.jpeg" width="240"></td>
|
||||
<td><img src="asset/images/stylebooth/disco.jpeg" width="240"></td>
|
||||
<td><img src="asset/images/flux_tuner/flux_tuner_2_1.webp" width="200"></td>
|
||||
<td><img src="asset/images/flux_tuner/flux_tuner_2_2.webp" width="200"></td>
|
||||
<td><img src="asset/images/flux_tuner/flux_tuner_2_3.webp" width="200"></td>
|
||||
<td><img src="asset/images/flux_tuner/flux_tuner_1_1.webp" width="200"></td>
|
||||
<td><img src="asset/images/flux_tuner/flux_tuner_1_2.webp" width="200"></td>
|
||||
<td><img src="asset/images/flux_tuner/flux_tuner_1_3.webp" width="200"></td>
|
||||
</tr>
|
||||
<tr>
|
||||
<th align="center" colspan="3">Travel Style</th>
|
||||
<th align="center" colspan="3">WuKong Style</th>
|
||||
</tr>
|
||||
<tr>
|
||||
<td><img src="asset/images/flux_tuner/flux_tuner_3_1.webp" width="200"></td>
|
||||
<td><img src="asset/images/flux_tuner/flux_tuner_3_2.webp" width="200"></td>
|
||||
<td><img src="asset/images/flux_tuner/flux_tuner_3_3.webp" width="200"></td>
|
||||
<td><img src="asset/images/flux_tuner/flux_tuner_4_1.webp" width="200"></td>
|
||||
<td><img src="asset/images/flux_tuner/flux_tuner_4_2.webp" width="200"></td>
|
||||
<td><img src="asset/images/flux_tuner/flux_tuner_4_3.webp" width="200"></td>
|
||||
</tr>
|
||||
</tbody>
|
||||
</table>
|
||||
|
||||
### ComfyUI Workflow
|
||||
|
||||

|
||||
|
||||
<table><tbody>
|
||||
<tr>
|
||||
<th align="center" colspan="4">Example Workflow Case</th>
|
||||
</tr>
|
||||
<tr>
|
||||
<th align="center" colspan="1">Base</th>
|
||||
<th align="center" colspan="1">+Mantra</th>
|
||||
<th align="center" colspan="1">+Tuner</th>
|
||||
<th align="center" colspan="1">+Control</th>
|
||||
</tr>
|
||||
<tr>
|
||||
<td>
|
||||
<a href="asset/workflow/sdxl_base.json" target="_blank">
|
||||
<img src="asset/workflow/sdxl_base.jpg" width="200">
|
||||
</a>
|
||||
</td>
|
||||
<td>
|
||||
<a href="asset/workflow/sdxl_base_mantra.json" target="_blank">
|
||||
<img src="asset/workflow/sdxl_base_mantra.jpg" width="200">
|
||||
</a>
|
||||
</td>
|
||||
<td>
|
||||
<a href="asset/workflow/sdxl_base_mantra_tuner.json" target="_blank">
|
||||
<img src="asset/workflow/sdxl_base_mantra_tuner.jpg" width="200">
|
||||
</a>
|
||||
</td>
|
||||
<td>
|
||||
<a href="asset/workflow/sdxl_base_mantra_tuner_control.json" target="_blank">
|
||||
<img src="asset/workflow/sdxl_base_mantra_tuner_control.jpg" width="200">
|
||||
</a>
|
||||
</td>
|
||||
</tr>
|
||||
</tbody>
|
||||
</table>
|
||||
|
||||
|
||||
## 🛠️ Installation
|
||||
|
||||
- Create new environment
|
||||
- Create new environment with `conda` command:
|
||||
|
||||
```shell
|
||||
conda env create -f environment.yaml
|
||||
conda activate scepter
|
||||
```
|
||||
- We recommend installing the specific version of PyTorch and accelerate toolbox [xFormers](https://pypi.org/project/xformers/). You can install these recommended version by pip:
|
||||
|
||||
- Install with `pip` command:
|
||||
|
||||
We recommend installing the specific version of PyTorch and accelerate toolbox [xFormers](https://pypi.org/project/xformers/). You can install these recommended version by pip:
|
||||
```shell
|
||||
pip install -r requirements/recommended.txt
|
||||
```
|
||||
|
||||
- Install SCEPTER by the `pip` command:
|
||||
|
||||
```shell
|
||||
pip install scepter
|
||||
```
|
||||
|
||||
@@ -101,15 +226,17 @@ pip install scepter
|
||||
### Currently supported approaches
|
||||
|
||||
| Tasks | Methods | Links |
|
||||
|:----------------------------:|:--------------------------------------------:|:------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
|
||||
| Text-to-image generation | SD v1.5 | [](https://huggingface.co/runwayml/stable-diffusion-v1-5) |
|
||||
| Text-to-image generation | SD v2.1 | [](https://huggingface.co/runwayml/stable-diffusion-v1-5) |
|
||||
| Text-to-image generation | SD-XL | [](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0) |
|
||||
|:----------------------------:|:----------------------------------------------:|:------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
|
||||
| Text-to-image Generation | SD v1.5 | [](https://huggingface.co/runwayml/stable-diffusion-v1-5) |
|
||||
| Text-to-image Generation | SD v2.1 | [](https://huggingface.co/runwayml/stable-diffusion-v1-5) |
|
||||
| Text-to-image Generation | SD-XL | [](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0) |
|
||||
| Text-to-image Generation | FLUX | [](https://huggingface.co/black-forest-labs/FLUX.1-dev) |
|
||||
| Efficient Tuning | LoRA | [](https://arxiv.org/abs/2106.09685) |
|
||||
| Efficient Tuning | Res-Tuning(NeurIPS23) | [](https://arxiv.org/abs/2310.19859) [](https://res-tuning.github.io/) |
|
||||
| Controllable image synthesis | [🌟SCEdit(CVPR24)](docs/en/tasks/scedit.md) | [](https://arxiv.org/abs/2312.11392) [](https://scedit.github.io/) |
|
||||
| Image editing | [🌟LAR-Gen](docs/en/tasks/largen.md) | [](https://arxiv.org/abs/2403.19534) [](https://ali-vilab.github.io/largen-page/) |
|
||||
| Image editing | [🌟StyleBooth](docs/en/tasks/stylebooth.md) | [](https://arxiv.org/abs/2404.12154) [](https://ali-vilab.github.io/stylebooth-page/) |
|
||||
| Controllable Image Synthesis | [🌟SCEdit(CVPR24)](docs/en/tasks/scedit.md) | [](https://arxiv.org/abs/2312.11392) [](https://scedit.github.io/) |
|
||||
| Image Editing | [🌟LAR-Gen](docs/en/tasks/largen.md) | [](https://arxiv.org/abs/2403.19534) [](https://ali-vilab.github.io/largen-page/) |
|
||||
| Image Editing | [🌟StyleBooth](docs/en/tasks/stylebooth.md) | [](https://arxiv.org/abs/2404.12154) [](https://ali-vilab.github.io/stylebooth-page/) |
|
||||
| Image Generation and Editing | [🌟ACE](https://ali-vilab.github.io/ace-page/) | [](https://arxiv.org/abs/2410.00086) [](https://ali-vilab.github.io/ace-page/) [](https://huggingface.co/spaces/scepter-studio/ACE-Chat) <br> [](https://www.modelscope.cn/models/iic/ACE-0.6B-512px) [](https://huggingface.co/scepter-studio/ACE-0.6B-512px) |
|
||||
|
||||
|
||||
## 🖥️ SCEPTER Studio
|
||||
@@ -132,8 +259,6 @@ The startup of **SCEPTER Studio** eliminates the need for manual downloading and
|
||||
Depending on the network and hardware situation, the initial startup usually requires 15-60 minutes, primarily involving the download and processing of SDv1.5, SDv2.1, and SDXL models.
|
||||
Therefore, subsequent startups will become much faster (about one minute) as downloading is no longer required.
|
||||
|
||||
To support the sharing and downloading of models,
|
||||
please make sure that you have installed **zip** and Git Large File Storage (**git lfs**).
|
||||
### Usage Demo
|
||||
|
||||
| [Image Editing](https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=assets%2Fscepter_studio%2Fimage_editing_20240419.webm) | [Training](https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=assets%2Fscepter_studio%2Ftraining_20240419.webm) | [Model Sharing](https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=assets%2Fscepter_studio%2Fmodel_sharing_20240419.webm) | [Model Inference](https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=assets%2Fscepter_studio%2Fmodel_inference_20240419.webm) | [Data Management](https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=assets%2Fscepter_studio%2Fdata_management_20240419.webm) |
|
||||
@@ -142,9 +267,27 @@ please make sure that you have installed **zip** and Git Large File Storage (**g
|
||||
|
||||
### Modelscope Studio & Huggingface Space
|
||||
|
||||
We deploy a work studio on Modelscope that includes only the inference tab, please refer to [ms_scepter_studio](https://www.modelscope.cn/studios/damo/scepter_studio/summary) and [hf_scepter_studio](https://huggingface.co/spaces/modelscope/scepter_studio)
|
||||
We deploy a work studio on Modelscope that includes only the inference tab, please refer to [ms_scepter_studio](https://www.modelscope.cn/studios/iic/scepter_studio/summary) and [hf_scepter_studio](https://huggingface.co/spaces/modelscope/scepter_studio)
|
||||
|
||||
|
||||
|
||||
## ⚙️️ ComfyUI Workflow
|
||||
|
||||
We support the use of all models in the ComfyUI Workflow through the following methods:
|
||||
|
||||
1) Automatic installation directly via the ComfyUI Manager by searching for the **ComfyUI-Scepter** node.
|
||||
2) Manually install by moving custom_nodes from Scepter to ComfyUI.
|
||||
```shell
|
||||
git clone https://github.com/modelscope/scepter.git
|
||||
cd path/to/scepter
|
||||
pip install -e .
|
||||
cp -r path/to/scepter/workflow/ path/to/ComfyUI/custom_nodes/ComfyUI-Scepter
|
||||
cd path/to/ComfyUI
|
||||
python main.py
|
||||
```
|
||||
|
||||
**Note**: You can use the nodes by dragging the sample images into ComfyUI. Additionally, our nodes can automatically pull models from ModelScope or HuggingFace by selecting the *model_source* field, or you can place the already downloaded models in a local path.
|
||||
|
||||
## 🔍 Learn More
|
||||
|
||||
- [Alibaba TongYi Vision Intelligence Lab](https://github.com/ali-vilab)
|
||||
@@ -177,4 +320,4 @@ This project is licensed under the [Apache License (Version 2.0)](https://github
|
||||
|
||||
|
||||
## Acknowledgement
|
||||
Thanks to [Stability-AI](https://github.com/Stability-AI), [SWIFT library](https://github.com/modelscope/swift/) and [Fooocus](https://github.com/lllyasviel/Fooocus) for their awesome work.
|
||||
Thanks to [Stability-AI](https://github.com/Stability-AI), [SWIFT library](https://github.com/modelscope/swift/), [Fooocus](https://github.com/lllyasviel/Fooocus) and [ComfyUI](https://github.com/comfyanonymous/ComfyUI) for their awesome work.
|
||||
|
||||
@@ -1,8 +1,9 @@
|
||||
albumentations
|
||||
beautifulsoup4
|
||||
bezier
|
||||
einops
|
||||
modelscope
|
||||
ms-swift>=2.0.1
|
||||
modelscope[framework]<=1.20.1
|
||||
ms-swift
|
||||
numpy
|
||||
open_clip_torch
|
||||
opencv-python
|
||||
@@ -11,5 +12,7 @@ oss2>=2.15.0
|
||||
pycocotools
|
||||
pyyaml>=5.3.1
|
||||
scikit-image
|
||||
scikit-learn
|
||||
sentencepiece
|
||||
torchsde
|
||||
transformers
|
||||
transformers<=4.46.3
|
||||
|
||||
@@ -1,4 +1,5 @@
|
||||
git+https://github.com/cocodataset/panopticapi.git
|
||||
torch==2.0.1
|
||||
torchvision==0.15.2
|
||||
xformers==0.0.21
|
||||
torch==2.4.1
|
||||
torchvision==.19.1
|
||||
flash-attn==2.5.8
|
||||
xformers==0.0.28
|
||||
@@ -1,5 +1,6 @@
|
||||
bitsandbytes
|
||||
gradio>=3.47.1,<4.0.0
|
||||
bitsandbytes<=0.44.1
|
||||
gradio
|
||||
gradio_imageslider
|
||||
imagehash
|
||||
psutil
|
||||
tiktoken
|
||||
|
||||
@@ -0,0 +1,161 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 2024
|
||||
#
|
||||
SOLVER:
|
||||
NAME: ACESolver
|
||||
RESUME_FROM:
|
||||
LOAD_MODEL_ONLY: True
|
||||
USE_FSDP: False
|
||||
SHARDING_STRATEGY:
|
||||
USE_AMP: True
|
||||
DTYPE: float16
|
||||
CHANNELS_LAST: True
|
||||
MAX_STEPS: 500
|
||||
MAX_EPOCHS: -1
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 50
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/ace_0.6b_1024
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
- NAME: "HuggingfaceFs"
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
- NAME: "LocalFs"
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
- NAME: "ModelscopeFs"
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionACE
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
SCALE_FACTOR: 0.18215
|
||||
SIZE_FACTOR: 8
|
||||
DECODER_BIAS: 0.5
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: True
|
||||
EVAL_EMA: False
|
||||
TEXT_IDENTIFIER: [ '{image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
USE_TEXT_POS_EMBEDDINGS: True
|
||||
#
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: eps
|
||||
MIN_SNR_GAMMA:
|
||||
NOISE_SCHEDULER:
|
||||
NAME: LinearScheduler
|
||||
NUM_TIMESTEPS: 1000
|
||||
BETA_MIN: 0.0001
|
||||
BETA_MAX: 0.02
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: ACE
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/dit/ace_0.6b_1024px.pth
|
||||
IGNORE_KEYS: [ ]
|
||||
PATCH_SIZE: 2
|
||||
IN_CHANNELS: 4
|
||||
HIDDEN_SIZE: 1152
|
||||
DEPTH: 28
|
||||
NUM_HEADS: 16
|
||||
MLP_RATIO: 4.0
|
||||
PRED_SIGMA: True
|
||||
DROP_PATH: 0.0
|
||||
WINDOW_DIZE: 0
|
||||
Y_CHANNELS: 4096
|
||||
MAX_SEQ_LEN: 4096
|
||||
QK_NORM: True
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
ATTENTION_BACKEND: flash_attn
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKL
|
||||
EMBED_DIM: 4
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/vae/vae.bin
|
||||
IGNORE_KEYS: []
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/text_encoder/t5-v1_1-xxl/
|
||||
TOKENIZER_PATH: ms://iic/ACE-0.6B-1024px@models/tokenizer/t5-v1_1-xxl
|
||||
LENGTH: 120
|
||||
T5_DTYPE: bfloat16
|
||||
ADDED_IDENTIFIER: [ '{image}', '{caption}', '{mask}', '{ref_image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
CLEAN: whitespace
|
||||
USE_GRAD: False
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 20
|
||||
GUIDE_SCALE: 4.5
|
||||
GUIDE_RESCALE: 0.5
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 1e-7
|
||||
EPS: 1e-10
|
||||
WEIGHT_DECAY: 5e-4
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: ImageTextPairMSDatasetForACE
|
||||
MODE: train
|
||||
MS_DATASET_NAME: cache/datasets/hed_pair
|
||||
MS_DATASET_NAMESPACE: ""
|
||||
MS_DATASET_SPLIT: "train"
|
||||
MS_DATASET_SUBNAME: ""
|
||||
PROMPT_PREFIX: ""
|
||||
REPLACE_STYLE: False
|
||||
MAX_SEQ_LEN: 4096
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 1
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
-
|
||||
NAME: BackwardHook
|
||||
PRIORITY: 0
|
||||
-
|
||||
NAME: LogHook
|
||||
LOG_INTERVAL: 50
|
||||
-
|
||||
NAME: CheckpointHook
|
||||
INTERVAL: 100
|
||||
-
|
||||
NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
@@ -0,0 +1,161 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 2024
|
||||
#
|
||||
SOLVER:
|
||||
NAME: ACESolver
|
||||
RESUME_FROM:
|
||||
LOAD_MODEL_ONLY: True
|
||||
USE_FSDP: False
|
||||
SHARDING_STRATEGY:
|
||||
USE_AMP: True
|
||||
DTYPE: float16
|
||||
CHANNELS_LAST: True
|
||||
MAX_STEPS: 500
|
||||
MAX_EPOCHS: -1
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 50
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/ace_0.6b_512
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
- NAME: "HuggingfaceFs"
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
- NAME: "LocalFs"
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
- NAME: "ModelscopeFs"
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionACE
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
SCALE_FACTOR: 0.18215
|
||||
SIZE_FACTOR: 8
|
||||
DECODER_BIAS: 0.5
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: True
|
||||
EVAL_EMA: False
|
||||
TEXT_IDENTIFIER: [ '{image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
USE_TEXT_POS_EMBEDDINGS: True
|
||||
#
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: eps
|
||||
MIN_SNR_GAMMA:
|
||||
NOISE_SCHEDULER:
|
||||
NAME: LinearScheduler
|
||||
NUM_TIMESTEPS: 1000
|
||||
BETA_MIN: 0.0001
|
||||
BETA_MAX: 0.02
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: ACE
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-512px@models/dit/ace_0.6b_512px.pth
|
||||
IGNORE_KEYS: [ ]
|
||||
PATCH_SIZE: 2
|
||||
IN_CHANNELS: 4
|
||||
HIDDEN_SIZE: 1152
|
||||
DEPTH: 28
|
||||
NUM_HEADS: 16
|
||||
MLP_RATIO: 4.0
|
||||
PRED_SIGMA: True
|
||||
DROP_PATH: 0.0
|
||||
WINDOW_DIZE: 0
|
||||
Y_CHANNELS: 4096
|
||||
MAX_SEQ_LEN: 1024
|
||||
QK_NORM: True
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
ATTENTION_BACKEND: flash_attn
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKL
|
||||
EMBED_DIM: 4
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-512px@models/vae/vae.bin
|
||||
IGNORE_KEYS: []
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-512px@models/text_encoder/t5-v1_1-xxl/
|
||||
TOKENIZER_PATH: ms://iic/ACE-0.6B-512px@models/tokenizer/t5-v1_1-xxl
|
||||
LENGTH: 120
|
||||
T5_DTYPE: bfloat16
|
||||
ADDED_IDENTIFIER: [ '{image}', '{caption}', '{mask}', '{ref_image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
CLEAN: whitespace
|
||||
USE_GRAD: False
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 20
|
||||
GUIDE_SCALE: 4.5
|
||||
GUIDE_RESCALE: 0.5
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 1e-7
|
||||
EPS: 1e-10
|
||||
WEIGHT_DECAY: 5e-4
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: ImageTextPairMSDatasetForACE
|
||||
MODE: train
|
||||
MS_DATASET_NAME: cache/datasets/hed_pair
|
||||
MS_DATASET_NAMESPACE: ""
|
||||
MS_DATASET_SPLIT: "train"
|
||||
MS_DATASET_SUBNAME: ""
|
||||
PROMPT_PREFIX: ""
|
||||
REPLACE_STYLE: False
|
||||
MAX_SEQ_LEN: 1024
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 1
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
-
|
||||
NAME: BackwardHook
|
||||
PRIORITY: 0
|
||||
-
|
||||
NAME: LogHook
|
||||
LOG_INTERVAL: 50
|
||||
-
|
||||
NAME: CheckpointHook
|
||||
INTERVAL: 100
|
||||
-
|
||||
NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
@@ -0,0 +1,250 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionSolver
|
||||
RESUME_FROM:
|
||||
LOAD_MODEL_ONLY: True
|
||||
USE_FSDP: False
|
||||
SHARDING_STRATEGY:
|
||||
USE_AMP: True
|
||||
DTYPE: float16
|
||||
CHANNELS_LAST: True
|
||||
MAX_STEPS: 2000
|
||||
MAX_EPOCHS: -1
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/edit_512_lora
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
-
|
||||
NAME: SwiftLoRA
|
||||
R: 64
|
||||
LORA_ALPHA: 64
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: model.*(to_q|to_k|to_v|to_out.0|net.0.proj|net.2)$
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionEdit
|
||||
PARAMETERIZATION: eps
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA:
|
||||
ZERO_TERMINAL_SNR: False
|
||||
PRETRAINED_MODEL: ms://iic/stylebooth@models/stylebooth-tb-5000-0.bin
|
||||
IGNORE_KEYS: [ ]
|
||||
CONCAT_NO_SCALE_FACTOR: True
|
||||
SCALE_FACTOR: 0.18215
|
||||
SIZE_FACTOR: 8
|
||||
# DEFAULT_N_PROMPT: 'lowres, error, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature'
|
||||
DEFAULT_N_PROMPT:
|
||||
SCHEDULE_ARGS:
|
||||
"NAME": "scaled_linear"
|
||||
"BETA_MIN": 0.00085
|
||||
"BETA_MAX": 0.012
|
||||
USE_EMA: False
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: DiffusionUNet
|
||||
IN_CHANNELS: 8
|
||||
OUT_CHANNELS: 4
|
||||
MODEL_CHANNELS: 320
|
||||
NUM_HEADS: 8
|
||||
NUM_RES_BLOCKS: 2
|
||||
ATTENTION_RESOLUTIONS: [ 4, 2, 1 ]
|
||||
CHANNEL_MULT: [ 1, 2, 4, 4 ]
|
||||
CONV_RESAMPLE: True
|
||||
DIMS: 2
|
||||
USE_CHECKPOINT: False
|
||||
USE_SCALE_SHIFT_NORM: False
|
||||
RESBLOCK_UPDOWN: False
|
||||
USE_SPATIAL_TRANSFORMER: True
|
||||
TRANSFORMER_DEPTH: 1
|
||||
CONTEXT_DIM: 768
|
||||
DISABLE_MIDDLE_SELF_ATTN: False
|
||||
USE_LINEAR_IN_TRANSFORMER: False
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: []
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKL
|
||||
EMBED_DIM: 4
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: []
|
||||
BATCH_SIZE: 4
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
TOKENIZER:
|
||||
NAME: ClipTokenizer
|
||||
PRETRAINED_PATH: ms://AI-ModelScope/clip-vit-large-patch14
|
||||
LENGTH: 77
|
||||
CLEAN: True
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: FrozenCLIPEmbedder
|
||||
FREEZE: True
|
||||
LAYER: last
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/clip-vit-large-patch14
|
||||
#
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
SEED: 2023
|
||||
GUIDE_SCALE: #7.5
|
||||
image: 1.5
|
||||
text: 7.5
|
||||
GUIDE_RESCALE: 0.5
|
||||
DISCRETIZATION: trailing
|
||||
IMAGE_SIZE: [512, 512]
|
||||
RUN_TRAIN_N: False
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
AMSGRAD: False
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: ImageTextPairMSDataset
|
||||
MODE: train
|
||||
MS_DATASET_NAME: cache/datasets/hed_pair
|
||||
MS_DATASET_NAMESPACE: ""
|
||||
MS_DATASET_SPLIT: "train"
|
||||
MS_DATASET_SUBNAME: ""
|
||||
PROMPT_PREFIX: ""
|
||||
REPLACE_STYLE: False
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
TRANSFORMS:
|
||||
- NAME: LoadImageFromFileList
|
||||
FILE_KEYS: ['img_path', 'src_path']
|
||||
RGB_ORDER: RGB
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleResize
|
||||
INTERPOLATION: bilinear
|
||||
SIZE: [ 512, 512 ]
|
||||
INPUT_KEY: [ 'img', 'src' ]
|
||||
OUTPUT_KEY: [ 'img', 'src' ]
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleCenterCrop
|
||||
SIZE: [ 512, 512 ]
|
||||
INPUT_KEY: [ 'img', 'src' ]
|
||||
OUTPUT_KEY: [ 'img', 'src' ]
|
||||
BACKEND: pillow
|
||||
- NAME: ImageToTensor
|
||||
INPUT_KEY: [ 'img', 'src' ]
|
||||
OUTPUT_KEY: [ 'img', 'src' ]
|
||||
BACKEND: pillow
|
||||
- NAME: Normalize
|
||||
MEAN: [ 0.5, 0.5, 0.5 ]
|
||||
STD: [ 0.5, 0.5, 0.5 ]
|
||||
INPUT_KEY: [ 'img', 'src' ]
|
||||
OUTPUT_KEY: [ 'image', 'condition_cat' ]
|
||||
BACKEND: torchvision
|
||||
- NAME: Select
|
||||
KEYS: [ 'image', 'condition_cat', 'prompt' ]
|
||||
META_KEYS: [ 'data_key' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
-
|
||||
NAME: BackwardHook
|
||||
PRIORITY: 0
|
||||
-
|
||||
NAME: LogHook
|
||||
LOG_INTERVAL: 50
|
||||
-
|
||||
NAME: CheckpointHook
|
||||
INTERVAL: 1000
|
||||
-
|
||||
NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "Convert to an edge map#;#cache/datasets/hed_pair/images/src_001.jpeg" ]
|
||||
IMAGE_SIZE: [ 512, 512 ]
|
||||
FIELDS: [ "prompt", "src_path" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: ''
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
TRANSFORMS:
|
||||
- NAME: LoadImageFromFileList
|
||||
FILE_KEYS: [ 'src_path' ]
|
||||
RGB_ORDER: RGB
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleResize
|
||||
INTERPOLATION: bilinear
|
||||
SIZE: [ 512, 512 ]
|
||||
INPUT_KEY: [ 'src' ]
|
||||
OUTPUT_KEY: [ 'src' ]
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleCenterCrop
|
||||
SIZE: [ 512, 512 ]
|
||||
INPUT_KEY: [ 'src' ]
|
||||
OUTPUT_KEY: [ 'src' ]
|
||||
BACKEND: pillow
|
||||
- NAME: ImageToTensor
|
||||
INPUT_KEY: [ 'src' ]
|
||||
OUTPUT_KEY: [ 'src' ]
|
||||
BACKEND: pillow
|
||||
- NAME: Normalize
|
||||
MEAN: [ 0.5, 0.5, 0.5 ]
|
||||
STD: [ 0.5, 0.5, 0.5 ]
|
||||
INPUT_KEY: [ 'src' ]
|
||||
OUTPUT_KEY: [ 'condition_cat' ]
|
||||
BACKEND: torchvision
|
||||
- NAME: Select
|
||||
KEYS: [ 'condition_cat', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
EVAL_HOOKS:
|
||||
-
|
||||
NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
SAVE_PROBE_PREFIX: 'image'
|
||||
@@ -11,7 +11,7 @@ SOLVER:
|
||||
# NUM_FOLDS DESCRIPTION: Num folds for training. TYPE: int default: 0
|
||||
NUM_FOLDS: 1
|
||||
# WORK_DIR DESCRIPTION: Save dir of the training log or model. TYPE: str default: ''
|
||||
WORK_DIR: ./exp12/
|
||||
WORK_DIR: ./cache/save_data/example/
|
||||
LOG_FILE: std_log.txt
|
||||
# EVAL_INTERVAL DESCRIPTION: Eval the model interval. TYPE: int default: 1
|
||||
EVAL_INTERVAL: 1
|
||||
@@ -102,7 +102,7 @@ SOLVER:
|
||||
# DATASET DESCRIPTION: the public dataset name TYPE: str default: 'cifar10'
|
||||
DATASET: cifar10
|
||||
# DATA_ROOT DESCRIPTION: the download data save path TYPE: str default: ''
|
||||
DATA_ROOT: ./local_data/cifar10
|
||||
DATA_ROOT: ./cache/cache_data/cifar10
|
||||
# MODE DESCRIPTION: test TYPE: str default: test
|
||||
MODE: test
|
||||
# PIN_MEMORY DESCRIPTION: pin_memory for data loader TYPE: bool default: False
|
||||
|
||||
@@ -0,0 +1,235 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 42
|
||||
TENSOR_PARALLEL_SIZE: 1
|
||||
PIPELINE_PARALLEL_SIZE: 1
|
||||
SYS_ENVS:
|
||||
TORCH_CUDNN_V8_API_ENABLED: '1'
|
||||
TOKENIZERS_PARALLELISM: 'false'
|
||||
TF_CPP_MIN_LOG_LEVEL: '3'
|
||||
PYTORCH_CUDA_ALLOC_CONF: 'expandable_segments:True'
|
||||
#
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionVideoSolver
|
||||
MAX_STEPS: 2000
|
||||
USE_AMP: True
|
||||
DTYPE: bfloat16
|
||||
USE_FAIRSCALE: False
|
||||
USE_FSDP: True
|
||||
LOAD_MODEL_ONLY: False
|
||||
RESUME_FROM:
|
||||
WORK_DIR: ./cache/save_data/dit_cogvideox_2b_lora
|
||||
LOG_FILE: std_log.txt
|
||||
EVAL_INTERVAL: 100
|
||||
LOG_TRAIN_NUM: 4
|
||||
ENABLE_GRADSCALER: False
|
||||
USE_SCALER: False
|
||||
FPS: 8
|
||||
SHARDING_STRATEGY: full_shard
|
||||
FSDP_REDUCE_DTYPE: float32
|
||||
FSDP_BUFFER_DTYPE: float32
|
||||
FSDP_SHARD_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
SAVE_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
TRAIN_MODULES: ['model']
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
- NAME: SwiftLoRA
|
||||
R: 64
|
||||
LORA_ALPHA: 64
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "model.*(.to_k|.to_q|.to_v|.to_out.0)$"
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionCogVideoX
|
||||
PRETRAINED_MODEL:
|
||||
PARAMETERIZATION: v
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA: 3.0
|
||||
ZERO_TERMINAL_SNR: True
|
||||
SCALE_FACTOR_SPATIAL: 8
|
||||
SCALE_FACTOR_TEMPORAL: 4
|
||||
SCALING_FACTOR_IMAGE: 1.15258426
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: v
|
||||
NOISE_SCHEDULER:
|
||||
NAME: ScaledLinearScheduler
|
||||
BETA_MIN: 0.00085
|
||||
BETA_MAX: 0.012
|
||||
SNR_SHIFT_SCALE: 3.0
|
||||
RESCALE_BETAS_ZERO_SNR: True
|
||||
DIFFUSION_SAMPLERS:
|
||||
NAME: DDIMSampler
|
||||
DISCRETIZATION_TYPE: trailing
|
||||
ETA: 0.0
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: CogVideoXTransformer3DModel
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-2b@transformer/diffusion_pytorch_model.safetensors
|
||||
NUM_ATTENTION_HEADS: 30
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 16
|
||||
FLIP_SIN_TO_COS: True
|
||||
FREQ_SHIFT: 0
|
||||
TIME_EMBED_DIM: 512
|
||||
TEXT_EMBED_DIM: 4096
|
||||
NUM_LAYERS: 30
|
||||
DROPOUT: 0.0
|
||||
ATTENTION_BIAS: True
|
||||
SAMPLE_WIDTH: 90
|
||||
SAMPLE_HEIGHT: 60
|
||||
SAMPLE_FRAMES: 49
|
||||
PATCH_SIZE: 2
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
MAX_TEXT_SEQ_LENGTH: 226
|
||||
ACTIVATION_FN: "gelu-approximate"
|
||||
TIMESTEP_ACTIVATION_FN: "silu"
|
||||
NORM_ELEMENTWISE_AFFINE: True
|
||||
NORM_EPS: 1e-5
|
||||
SPATIAL_INTERPOLATION_SCALE: 1.875
|
||||
TEMPORAL_INTERPOLATION_SCALE: 1.0
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: False
|
||||
USE_LEARNED_POSITIONAL_EMBEDDINGS: False
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-2b@vae/diffusion_pytorch_model.safetensors
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
LENGTH: 226
|
||||
CLEAN:
|
||||
USE_GRAD: False
|
||||
#
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
SEED: 42
|
||||
GUIDE_SCALE: 6.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
NUM_FRAMES: 49
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: Adam
|
||||
LEARNING_RATE: 1e-3
|
||||
BETAS: [ 0.9, 0.95 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 0.0
|
||||
AMSGRAD: False
|
||||
#
|
||||
# LR_SCHEDULER:
|
||||
# NAME: StepAnnealingLR
|
||||
# WARMUP_STEPS: 200
|
||||
# TOTAL_STEPS: 2000
|
||||
# DECAY_MODE: 'cosine'
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: VideoGenDataset
|
||||
MODE: train
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
PROMPT_PREFIX: 'DISNEY '
|
||||
SAMPLER:
|
||||
NAME: MixtureOfSamplers
|
||||
SUB_SAMPLERS:
|
||||
- NAME: MultiLevelBatchSampler
|
||||
PROB: 1.0
|
||||
FIELDS: [ "video_path", "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PATH_PREFIX: cache/datasets/Disney-VideoGeneration-Dataset/
|
||||
INDEX_FILE: cache/datasets/Disney-VideoGeneration-Dataset/index.jsonl
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'video', "prompt" ]
|
||||
META_KEYS: [ ]
|
||||
#
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "A girl riding a bike.", "A panda, dressed in a small, red jacket and a tiny hat, sits on a wooden stool in a serene bamboo forest. The panda's fluffy paws strum a miniature acoustic guitar, producing soft, melodic tunes. Nearby, a few other pandas gather, watching curiously and some clapping in rhythm. Sunlight filters through the tall bamboo, casting a gentle glow on the scene. The panda's face is expressive, showing concentration and joy as it plays. The background includes a small, flowing stream and vibrant green foliage, enhancing the peaceful and magical atmosphere of this unique musical performance." ]
|
||||
IMAGE_SIZE: [ 480, 720 ]
|
||||
FIELDS: [ "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: 'DISNEY '
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
USE_NUM: 8
|
||||
NUM_WORKERS: 4
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'index', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
- NAME: BackwardHook
|
||||
PRIORITY: 10
|
||||
- NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
PRIORITY: 20
|
||||
- NAME: CheckpointHook
|
||||
INTERVAL: 1000
|
||||
PRIORITY: 40
|
||||
#
|
||||
EVAL_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
@@ -0,0 +1,266 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 42
|
||||
TENSOR_PARALLEL_SIZE: 1
|
||||
PIPELINE_PARALLEL_SIZE: 1
|
||||
SYS_ENVS:
|
||||
TORCH_CUDNN_V8_API_ENABLED: '1'
|
||||
TOKENIZERS_PARALLELISM: 'false'
|
||||
TF_CPP_MIN_LOG_LEVEL: '3'
|
||||
PYTORCH_CUDA_ALLOC_CONF: 'expandable_segments:True'
|
||||
#
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionVideoSolver
|
||||
MAX_STEPS: 2000
|
||||
USE_AMP: True
|
||||
DTYPE: bfloat16
|
||||
USE_FAIRSCALE: False
|
||||
USE_FSDP: True
|
||||
LOAD_MODEL_ONLY: False
|
||||
ENABLE_GRADSCALER: False
|
||||
USE_SCALER: False
|
||||
RESUME_FROM:
|
||||
WORK_DIR: ./cache/save_data/dit_cogvideox_5b_i2v_lora
|
||||
LOG_FILE: std_log.txt
|
||||
EVAL_INTERVAL: 100
|
||||
LOG_TRAIN_NUM: 4
|
||||
FPS: 8
|
||||
SHARDING_STRATEGY: full_shard
|
||||
FSDP_REDUCE_DTYPE: float32
|
||||
FSDP_BUFFER_DTYPE: float32
|
||||
FSDP_SHARD_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
SAVE_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
TRAIN_MODULES: ['model']
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
- NAME: SwiftLoRA
|
||||
R: 64
|
||||
LORA_ALPHA: 64
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "model.*(.to_k|.to_q|.to_v|.to_out.0)$"
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionCogVideoX
|
||||
PRETRAINED_MODEL:
|
||||
PARAMETERIZATION: v
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA: 3.0
|
||||
ZERO_TERMINAL_SNR: True
|
||||
SCALE_FACTOR_SPATIAL: 8
|
||||
SCALE_FACTOR_TEMPORAL: 4
|
||||
SCALING_FACTOR_IMAGE: 0.7 # 5b diff
|
||||
NOISED_IMAGE_DROPOUT: 0.05
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: v
|
||||
NOISE_SCHEDULER:
|
||||
NAME: ScaledLinearScheduler
|
||||
BETA_MIN: 0.00085
|
||||
BETA_MAX: 0.012
|
||||
SNR_SHIFT_SCALE: 1.0 # 5b diff
|
||||
RESCALE_BETAS_ZERO_SNR: True
|
||||
DIFFUSION_SAMPLERS:
|
||||
NAME: DDIMSampler
|
||||
DISCRETIZATION_TYPE: trailing
|
||||
ETA: 0.0
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: CogVideoXTransformer3DModel
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: # 5b-I2V diff
|
||||
- ms://AI-ModelScope/CogVideoX-5b-I2V@transformer/diffusion_pytorch_model-00001-of-00003.safetensors
|
||||
- ms://AI-ModelScope/CogVideoX-5b-I2V@transformer/diffusion_pytorch_model-00002-of-00003.safetensors
|
||||
- ms://AI-ModelScope/CogVideoX-5b-I2V@transformer/diffusion_pytorch_model-00003-of-00003.safetensors
|
||||
NUM_ATTENTION_HEADS: 48 # 5b diff
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
IN_CHANNELS: 32 # 5b-I2V diff
|
||||
LATENT_CHANNELS: 16
|
||||
OUT_CHANNELS: 16
|
||||
FLIP_SIN_TO_COS: True
|
||||
FREQ_SHIFT: 0
|
||||
TIME_EMBED_DIM: 512
|
||||
TEXT_EMBED_DIM: 4096
|
||||
NUM_LAYERS: 42 # 5b diff
|
||||
DROPOUT: 0.0
|
||||
ATTENTION_BIAS: True
|
||||
SAMPLE_WIDTH: 90
|
||||
SAMPLE_HEIGHT: 60
|
||||
SAMPLE_FRAMES: 49
|
||||
PATCH_SIZE: 2
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
MAX_TEXT_SEQ_LENGTH: 226
|
||||
ACTIVATION_FN: "gelu-approximate"
|
||||
TIMESTEP_ACTIVATION_FN: "silu"
|
||||
NORM_ELEMENTWISE_AFFINE: True
|
||||
NORM_EPS: 1e-5
|
||||
SPATIAL_INTERPOLATION_SCALE: 1.875
|
||||
TEMPORAL_INTERPOLATION_SCALE: 1.0
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: True # 5b diff
|
||||
USE_LEARNED_POSITIONAL_EMBEDDINGS: True # 5b-I2V diff
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-5b-I2V@vae/diffusion_pytorch_model.safetensors # 5b diff
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
LENGTH: 226
|
||||
CLEAN:
|
||||
USE_GRAD: False
|
||||
#
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
SEED: 42
|
||||
GUIDE_SCALE: 6.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
NUM_FRAMES: 49
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: Adam
|
||||
LEARNING_RATE: 1e-3
|
||||
BETAS: [ 0.9, 0.95 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 0.0
|
||||
AMSGRAD: False
|
||||
#
|
||||
# LR_SCHEDULER:
|
||||
# NAME: StepAnnealingLR
|
||||
# WARMUP_STEPS: 200
|
||||
# TOTAL_STEPS: 2000
|
||||
# DECAY_MODE: 'cosine'
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: VideoGenDataset
|
||||
MODE: train
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 0
|
||||
PROMPT_PREFIX: 'DISNEY '
|
||||
DATA_TYPE: 'i2v'
|
||||
SAMPLER:
|
||||
NAME: MixtureOfSamplers
|
||||
SUB_SAMPLERS:
|
||||
- NAME: MultiLevelBatchSampler
|
||||
PROB: 1.0
|
||||
FIELDS: [ "video_path", "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PATH_PREFIX: cache/datasets/Disney-VideoGeneration-Dataset/
|
||||
INDEX_FILE: cache/datasets/Disney-VideoGeneration-Dataset/index.jsonl
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ "video", "image", "prompt" ]
|
||||
META_KEYS: [ ]
|
||||
#
|
||||
# EVAL_DATA:
|
||||
# NAME: Text2ImageDataset
|
||||
# MODE: eval
|
||||
# PROMPT_FILE:
|
||||
# PROMPT_DATA: [ "A cat running.#;#asset/images/edit_tuner/cat_512.jpg" ]
|
||||
# FIELDS: [ "prompt", "img_path" ]
|
||||
# DELIMITER: '#;#'
|
||||
# PROMPT_PREFIX: ''
|
||||
# PIN_MEMORY: True
|
||||
# BATCH_SIZE: 1
|
||||
# USE_NUM: 8
|
||||
# NUM_WORKERS: 0
|
||||
# IMAGE_SIZE: [ 480, 720 ]
|
||||
# TRANSFORMS:
|
||||
# - NAME: LoadImageFromFileList
|
||||
# FILE_KEYS: [ 'img_path' ]
|
||||
# RGB_ORDER: RGB
|
||||
# BACKEND: pillow
|
||||
# - NAME: FlexibleResize
|
||||
# INTERPOLATION: bilinear
|
||||
# SIZE: [ 480, 720 ]
|
||||
# INPUT_KEY: [ 'img' ]
|
||||
# OUTPUT_KEY: [ 'img' ]
|
||||
# BACKEND: pillow
|
||||
# - NAME: FlexibleCenterCrop
|
||||
# SIZE: [ 480, 720 ]
|
||||
# INPUT_KEY: [ 'img' ]
|
||||
# OUTPUT_KEY: [ 'img' ]
|
||||
# BACKEND: pillow
|
||||
# - NAME: ImageToTensor
|
||||
# INPUT_KEY: [ 'img' ]
|
||||
# OUTPUT_KEY: [ 'img' ]
|
||||
# BACKEND: pillow
|
||||
# - NAME: Normalize
|
||||
# MEAN: [ 0.5, 0.5, 0.5 ]
|
||||
# STD: [ 0.5, 0.5, 0.5 ]
|
||||
# INPUT_KEY: [ 'img' ]
|
||||
# OUTPUT_KEY: [ 'image' ]
|
||||
# BACKEND: torchvision
|
||||
# - NAME: Select
|
||||
# KEYS: [ 'image', 'prompt' ]
|
||||
# META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
- NAME: BackwardHook
|
||||
PRIORITY: 10
|
||||
- NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
PRIORITY: 20
|
||||
- NAME: CheckpointHook
|
||||
INTERVAL: 1000
|
||||
PRIORITY: 40
|
||||
#
|
||||
# EVAL_HOOKS:
|
||||
# - NAME: ProbeDataHook
|
||||
# PROB_INTERVAL: 100
|
||||
# PRIORITY: 0
|
||||
@@ -0,0 +1,273 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 42
|
||||
TENSOR_PARALLEL_SIZE: 1
|
||||
PIPELINE_PARALLEL_SIZE: 1
|
||||
SYS_ENVS:
|
||||
TORCH_CUDNN_V8_API_ENABLED: '1'
|
||||
TOKENIZERS_PARALLELISM: 'false'
|
||||
TF_CPP_MIN_LOG_LEVEL: '3'
|
||||
PYTORCH_CUDA_ALLOC_CONF: 'expandable_segments:True'
|
||||
#
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionVideoSolver
|
||||
MAX_STEPS: 2000
|
||||
USE_AMP: True
|
||||
DTYPE: bfloat16
|
||||
USE_FAIRSCALE: False
|
||||
USE_FSDP: True
|
||||
LOAD_MODEL_ONLY: False
|
||||
ENABLE_GRADSCALER: False
|
||||
USE_SCALER: False
|
||||
RESUME_FROM:
|
||||
WORK_DIR: ./cache/save_data/dit_cogvideox_5b_lora
|
||||
LOG_FILE: std_log.txt
|
||||
EVAL_INTERVAL: 100
|
||||
LOG_TRAIN_NUM: 4
|
||||
FPS: 8
|
||||
SHARDING_STRATEGY: full_shard
|
||||
FSDP_REDUCE_DTYPE: float32
|
||||
FSDP_BUFFER_DTYPE: float32
|
||||
FSDP_SHARD_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
SAVE_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
TRAIN_MODULES: ['model']
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
- NAME: SwiftLoRA
|
||||
R: 64
|
||||
LORA_ALPHA: 64
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "model.*(.to_k|.to_q|.to_v|.to_out.0)$"
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionCogVideoX
|
||||
PRETRAINED_MODEL:
|
||||
PARAMETERIZATION: v
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA: 3.0
|
||||
ZERO_TERMINAL_SNR: True
|
||||
SCALE_FACTOR_SPATIAL: 8
|
||||
SCALE_FACTOR_TEMPORAL: 4
|
||||
SCALING_FACTOR_IMAGE: 0.7 # 5b diff
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: v
|
||||
NOISE_SCHEDULER:
|
||||
NAME: ScaledLinearScheduler
|
||||
BETA_MIN: 0.00085
|
||||
BETA_MAX: 0.012
|
||||
SNR_SHIFT_SCALE: 1.0 # 5b diff
|
||||
RESCALE_BETAS_ZERO_SNR: True
|
||||
DIFFUSION_SAMPLERS:
|
||||
NAME: DDIMSampler
|
||||
DISCRETIZATION_TYPE: trailing
|
||||
ETA: 0.0
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: CogVideoXTransformer3DModel
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: # 5b diff
|
||||
- ms://AI-ModelScope/CogVideoX-5b@transformer/diffusion_pytorch_model-00001-of-00002.safetensors
|
||||
- ms://AI-ModelScope/CogVideoX-5b@transformer/diffusion_pytorch_model-00002-of-00002.safetensors
|
||||
NUM_ATTENTION_HEADS: 48 # 5b diff
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 16
|
||||
FLIP_SIN_TO_COS: True
|
||||
FREQ_SHIFT: 0
|
||||
TIME_EMBED_DIM: 512
|
||||
TEXT_EMBED_DIM: 4096
|
||||
NUM_LAYERS: 42 # 5b diff
|
||||
DROPOUT: 0.0
|
||||
ATTENTION_BIAS: True
|
||||
SAMPLE_WIDTH: 90
|
||||
SAMPLE_HEIGHT: 60
|
||||
SAMPLE_FRAMES: 49
|
||||
PATCH_SIZE: 2
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
MAX_TEXT_SEQ_LENGTH: 226
|
||||
ACTIVATION_FN: "gelu-approximate"
|
||||
TIMESTEP_ACTIVATION_FN: "silu"
|
||||
NORM_ELEMENTWISE_AFFINE: True
|
||||
NORM_EPS: 1e-5
|
||||
SPATIAL_INTERPOLATION_SCALE: 1.875
|
||||
TEMPORAL_INTERPOLATION_SCALE: 1.0
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: True # 5b diff
|
||||
USE_LEARNED_POSITIONAL_EMBEDDINGS: False
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-5b@vae/diffusion_pytorch_model.safetensors # 5b diff
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
LENGTH: 226
|
||||
CLEAN:
|
||||
USE_GRAD: False
|
||||
#
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
SEED: 42
|
||||
GUIDE_SCALE: 6.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
NUM_FRAMES: 49
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: Adam
|
||||
LEARNING_RATE: 1e-3
|
||||
BETAS: [ 0.9, 0.95 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 0.0
|
||||
AMSGRAD: False
|
||||
#
|
||||
# LR_SCHEDULER:
|
||||
# NAME: StepAnnealingLR
|
||||
# WARMUP_STEPS: 200
|
||||
# TOTAL_STEPS: 2000
|
||||
# DECAY_MODE: 'cosine'
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: VideoGenDatasetOTF
|
||||
MODE: train
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
PROMPT_PREFIX: 'DISNEY '
|
||||
DELIMITER: '#;#'
|
||||
FIELDS: [ 'video_path', 'prompt' ]
|
||||
PATH_PREFIX: cache/datasets/Disney-VideoGeneration-Dataset/
|
||||
DATA_FILE: cache/datasets/Disney-VideoGeneration-Dataset/index.jsonl
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'video', 'video_latent', "prompt" ]
|
||||
META_KEYS: [ ]
|
||||
MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-5b@vae/diffusion_pytorch_model.safetensors
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "A girl riding a bike.", "A panda, dressed in a small, red jacket and a tiny hat, sits on a wooden stool in a serene bamboo forest. The panda's fluffy paws strum a miniature acoustic guitar, producing soft, melodic tunes. Nearby, a few other pandas gather, watching curiously and some clapping in rhythm. Sunlight filters through the tall bamboo, casting a gentle glow on the scene. The panda's face is expressive, showing concentration and joy as it plays. The background includes a small, flowing stream and vibrant green foliage, enhancing the peaceful and magical atmosphere of this unique musical performance." ]
|
||||
IMAGE_SIZE: [ 480, 720 ]
|
||||
FIELDS: [ "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: 'DISNEY '
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
USE_NUM: 8
|
||||
NUM_WORKERS: 4
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'index', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
- NAME: BackwardHook
|
||||
PRIORITY: 10
|
||||
- NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
PRIORITY: 20
|
||||
- NAME: CheckpointHook
|
||||
INTERVAL: 1000
|
||||
PRIORITY: 40
|
||||
#
|
||||
EVAL_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
@@ -0,0 +1,246 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 166666
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionSolver
|
||||
MAX_STEPS: 100000
|
||||
USE_AMP: True
|
||||
DTYPE: bfloat16
|
||||
USE_FAIRSCALE: False
|
||||
USE_FSDP: True
|
||||
LOAD_MODEL_ONLY: False
|
||||
ENABLE_GRADSCALER: False
|
||||
USE_SCALER: False
|
||||
RESUME_FROM:
|
||||
WORK_DIR: ./cache/save_data/dit_flux_dev_1024_lora
|
||||
LOG_FILE: std_log.txt
|
||||
EVAL_INTERVAL: 100
|
||||
LOG_TRAIN_NUM: 16
|
||||
FSDP_REDUCE_DTYPE: float32
|
||||
FSDP_BUFFER_DTYPE: float32
|
||||
FSDP_SHARD_MODULES: [ 'model', 'cond_stage_model.t5_model' ] #
|
||||
SAVE_MODULES: [ 'model'] #
|
||||
TRAIN_MODULES: ['model']
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
FREEZE:
|
||||
TUNER:
|
||||
- NAME: SwiftLoRA
|
||||
R: 4
|
||||
LORA_ALPHA: 4
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "(model.double_blocks.*(.qkv|.proj|.img_mod.lin|.txt_mod.lin))|(model.single_blocks.*(.linear1|.linear2|.modulation.lin))$"
|
||||
##
|
||||
MODEL:
|
||||
NAME: LatentDiffusionFlux
|
||||
PARAMETERIZATION: rf
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA:
|
||||
ZERO_TERMINAL_SNR: False
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
NAME: DiffusionFluxRF
|
||||
PREDICTION_TYPE: raw
|
||||
NOISE_SCHEDULER:
|
||||
NAME: FlowMatchSigmaScheduler
|
||||
WEIGHTING_SCHEME: logit_normal
|
||||
SHIFT: 3.0
|
||||
LOGIT_MEAN: 0.0
|
||||
LOGIT_STD: 1.0
|
||||
MODE_SCALE: 1.29
|
||||
SAMPLER_SCHEDULER:
|
||||
NAME: FlowMatchFluxShiftScheduler
|
||||
SHIFT: False
|
||||
SIGMOID_SCALE: 1
|
||||
BASE_SHIFT: 0.5
|
||||
MAX_SHIFT: 1.15
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: Flux
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-dev@flux1-dev.safetensors
|
||||
IN_CHANNELS: 64
|
||||
HIDDEN_SIZE: 3072
|
||||
NUM_HEADS: 24
|
||||
AXES_DIM: [ 16, 56, 56 ]
|
||||
THETA: 10000
|
||||
VEC_IN_DIM: 768
|
||||
GUIDANCE_EMBED: True
|
||||
CONTEXT_IN_DIM: 4096
|
||||
MLP_RATIO: 4.0
|
||||
QKV_BIAS: True
|
||||
DEPTH: 19
|
||||
DEPTH_SINGLE_BLOCKS: 38
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLFlux
|
||||
EMBED_DIM: 16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-dev@ae.safetensors
|
||||
IGNORE_KEYS: [ ]
|
||||
BATCH_SIZE: 8
|
||||
USE_CONV: False
|
||||
SCALE_FACTOR: 0.3611
|
||||
SHIFT_FACTOR: 0.1159
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5PlusClipFluxEmbedder
|
||||
T5_MODEL:
|
||||
NAME: HFEmbedder
|
||||
HF_MODEL_CLS: T5EncoderModel
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-dev@text_encoder_2/
|
||||
HF_TOKENIZER_CLS: T5Tokenizer
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-dev@tokenizer_2/
|
||||
MAX_LENGTH: 512
|
||||
OUTPUT_KEY: last_hidden_state
|
||||
D_TYPE: bfloat16
|
||||
BATCH_INFER: False
|
||||
CLEAN: whitespace
|
||||
CLIP_MODEL:
|
||||
NAME: HFEmbedder
|
||||
HF_MODEL_CLS: CLIPTextModel
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-dev@text_encoder/
|
||||
HF_TOKENIZER_CLS: CLIPTokenizer
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-dev@tokenizer/
|
||||
MAX_LENGTH: 77
|
||||
OUTPUT_KEY: pooler_output
|
||||
D_TYPE: bfloat16
|
||||
BATCH_INFER: True
|
||||
CLEAN: whitespace
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLE_STEPS: 50
|
||||
SAMPLER: flow_euler
|
||||
SEED: 2024
|
||||
IMAGE_SIZE: [ 1024, 1024 ]
|
||||
GUIDE_SCALE: 3.5
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 4e-4
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
AMSGRAD: False
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: ImageTextPairMSDataset
|
||||
MODE: train
|
||||
MS_DATASET_NAME: style_custom_dataset
|
||||
MS_DATASET_NAMESPACE: damo
|
||||
MS_DATASET_SUBNAME: 3D
|
||||
PROMPT_PREFIX: ""
|
||||
MS_DATASET_SPLIT: train
|
||||
MS_REMAP_KEYS: { 'Image:FILE': 'Target:FILE' }
|
||||
REPLACE_STYLE: False
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
TRANSFORMS:
|
||||
- NAME: LoadImageFromFile
|
||||
RGB_ORDER: RGB
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleResize
|
||||
INTERPOLATION: bilinear
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleCenterCrop
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: ImageToTensor
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: Normalize
|
||||
MEAN: [ 0.5, 0.5, 0.5 ]
|
||||
STD: [ 0.5, 0.5, 0.5 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'image' ]
|
||||
BACKEND: torchvision
|
||||
- NAME: Select
|
||||
KEYS: [ 'image', 'prompt' ]
|
||||
META_KEYS: [ 'data_key' ]
|
||||
#
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "a boy wearing a jacket", "a dog running on the lawn" ]
|
||||
IMAGE_SIZE: [ 1024, 1024 ]
|
||||
FIELDS: [ "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: ''
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 2
|
||||
NUM_WORKERS: 4
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'index', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
- NAME: BackwardHook
|
||||
# GRADIENT_CLIP: 1.0
|
||||
PRIORITY: 10
|
||||
- NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
-
|
||||
NAME: TensorboardLogHook
|
||||
-
|
||||
NAME: CheckpointHook
|
||||
INTERVAL: 10000
|
||||
PRIORITY: 200
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
DISABLE_SNAPSHOT: True
|
||||
EVAL_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
@@ -0,0 +1,267 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 166666
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionSolver
|
||||
MAX_STEPS: 100000
|
||||
USE_AMP: True
|
||||
DTYPE: bfloat16
|
||||
USE_FAIRSCALE: False
|
||||
USE_FSDP: True
|
||||
LOAD_MODEL_ONLY: False
|
||||
ENABLE_GRADSCALER: False
|
||||
USE_SCALER: False
|
||||
RESUME_FROM:
|
||||
WORK_DIR: ./cache/save_data/dit_flux_schnell_1024_lora
|
||||
LOG_FILE: std_log.txt
|
||||
EVAL_INTERVAL: 100
|
||||
LOG_TRAIN_NUM: 16
|
||||
FSDP_REDUCE_DTYPE: float32
|
||||
FSDP_BUFFER_DTYPE: float32
|
||||
FSDP_SHARD_MODULES: [ 'model', 'cond_stage_model.t5_model' ] #
|
||||
SAVE_MODULES: [ 'model']
|
||||
TRAIN_MODULES: ['model']
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
FREEZE:
|
||||
TUNER:
|
||||
- NAME: SwiftLoRA
|
||||
R: 4
|
||||
LORA_ALPHA: 4
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "(model.double_blocks.*(.qkv|.proj|.img_mod.lin|.txt_mod.lin))|(model.single_blocks.*(.linear1|.linear2|.modulation.lin))$"
|
||||
##
|
||||
MODEL:
|
||||
NAME: LatentDiffusionFlux
|
||||
PARAMETERIZATION: rf
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA:
|
||||
ZERO_TERMINAL_SNR: False
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
NAME: DiffusionFluxRF
|
||||
PREDICTION_TYPE: raw
|
||||
NOISE_SCHEDULER:
|
||||
NAME: FlowMatchSigmaScheduler
|
||||
# WEIGHTING_SCHEME DESCRIPTION: The weighting scheme for sampling timesteps, choose from ['sigma_sqrt', 'logit_normal', 'mode', 'cosmap', 'none']. TYPE: str default: 'logit_normal'
|
||||
WEIGHTING_SCHEME: logit_normal
|
||||
SHIFT: 3.0
|
||||
# LOGIT_MEAN DESCRIPTION: The mean of the logit distribution for sampling timesteps. TYPE: float default: 0.0
|
||||
LOGIT_MEAN: 0.0
|
||||
# LOGIT_STD DESCRIPTION: The standard deviation of the logit distribution for sampling timesteps. TYPE: float default: 1.0
|
||||
LOGIT_STD: 1.0
|
||||
# MODE_SCALE DESCRIPTION: The scale factor for the mode of the logit distribution for sampling timesteps. TYPE: float default: 1.29
|
||||
MODE_SCALE: 1.29
|
||||
SAMPLER_SCHEDULER:
|
||||
# NAME DESCRIPTION: TYPE: default: 'FlowMatchFluxShiftScheduler'
|
||||
NAME: FlowMatchFluxShiftScheduler
|
||||
# SHIFT DESCRIPTION: Use timestamp shift or not, default is True. TYPE: bool default: True
|
||||
SHIFT: False
|
||||
# SIGMOID_SCALE DESCRIPTION: The scale of sigmoid function for sampling timesteps. TYPE: int default: 1
|
||||
SIGMOID_SCALE: 1
|
||||
# BASE_SHIFT DESCRIPTION: The base shift factor for the timestamp. TYPE: float default: 0.5
|
||||
BASE_SHIFT: 0.5
|
||||
# MAX_SHIFT DESCRIPTION: The max shift factor for the timestamp. TYPE: float default: 1.15
|
||||
MAX_SHIFT: 1.15
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'Flux'
|
||||
NAME: Flux
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-schnell@flux1-schnell.safetensors
|
||||
# IN_CHANNELS DESCRIPTION: model's input channels. TYPE: int default: 64
|
||||
IN_CHANNELS: 64
|
||||
# HIDDEN_SIZE DESCRIPTION: model's hidden size. TYPE: int default: 1024
|
||||
HIDDEN_SIZE: 3072
|
||||
# NUM_HEADS DESCRIPTION: number of heads in the transformer. TYPE: int default: 16
|
||||
NUM_HEADS: 24
|
||||
# AXES_DIM DESCRIPTION: dimensions of the axes of the positional encoding. TYPE: list default: [16, 56, 56]
|
||||
AXES_DIM: [ 16, 56, 56 ]
|
||||
# THETA DESCRIPTION: theta for positional encoding. TYPE: int default: 10000
|
||||
THETA: 10000
|
||||
# VEC_IN_DIM DESCRIPTION: dimension of the vector input. TYPE: int default: 768
|
||||
VEC_IN_DIM: 768
|
||||
# GUIDANCE_EMBED DESCRIPTION: whether to use guidance embedding. TYPE: bool default: False
|
||||
GUIDANCE_EMBED: False
|
||||
# CONTEXT_IN_DIM DESCRIPTION: dimension of the context input. TYPE: int default: 4096
|
||||
CONTEXT_IN_DIM: 4096
|
||||
# MLP_RATIO DESCRIPTION: ratio of mlp hidden size to hidden size. TYPE: float default: 4.0
|
||||
MLP_RATIO: 4.0
|
||||
# QKV_BIAS DESCRIPTION: whether to use bias in qkv projection. TYPE: bool default: True
|
||||
QKV_BIAS: True
|
||||
# DEPTH DESCRIPTION: number of transformer blocks. TYPE: int default: 19
|
||||
DEPTH: 19
|
||||
# DEPTH_SINGLE_BLOCKS DESCRIPTION: number of transformer blocks in the single stream block. TYPE: int default: 38
|
||||
DEPTH_SINGLE_BLOCKS: 38
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLFlux
|
||||
EMBED_DIM: 16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-schnell@ae.safetensors
|
||||
IGNORE_KEYS: [ ]
|
||||
BATCH_SIZE: 8
|
||||
USE_CONV: False
|
||||
SCALE_FACTOR: 0.3611
|
||||
SHIFT_FACTOR: 0.1159
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5PlusClipFluxEmbedder
|
||||
T5_MODEL:
|
||||
NAME: HFEmbedder
|
||||
HF_MODEL_CLS: T5EncoderModel
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-schnell@text_encoder_2/
|
||||
HF_TOKENIZER_CLS: T5Tokenizer
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-schnell@tokenizer_2/
|
||||
MAX_LENGTH: 256
|
||||
OUTPUT_KEY: last_hidden_state
|
||||
D_TYPE: bfloat16
|
||||
BATCH_INFER: False
|
||||
CLEAN: whitespace
|
||||
CLIP_MODEL:
|
||||
NAME: HFEmbedder
|
||||
HF_MODEL_CLS: CLIPTextModel
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-schnell@text_encoder/
|
||||
HF_TOKENIZER_CLS: CLIPTokenizer
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-schnell@tokenizer/
|
||||
MAX_LENGTH: 77
|
||||
OUTPUT_KEY: pooler_output
|
||||
D_TYPE: bfloat16
|
||||
BATCH_INFER: True
|
||||
CLEAN: whitespace
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLE_STEPS: 4
|
||||
SAMPLER: flow_euler
|
||||
SEED: 2024
|
||||
IMAGE_SIZE: [ 1024, 1024 ]
|
||||
GUIDE_SCALE: 3.5
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 4e-4
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
AMSGRAD: False
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: ImageTextPairMSDataset
|
||||
MODE: train
|
||||
MS_DATASET_NAME: style_custom_dataset
|
||||
MS_DATASET_NAMESPACE: damo
|
||||
MS_DATASET_SUBNAME: 3D
|
||||
PROMPT_PREFIX: ""
|
||||
MS_DATASET_SPLIT: train
|
||||
MS_REMAP_KEYS: { 'Image:FILE': 'Target:FILE' }
|
||||
REPLACE_STYLE: False
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
TRANSFORMS:
|
||||
- NAME: LoadImageFromFile
|
||||
RGB_ORDER: RGB
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleResize
|
||||
INTERPOLATION: bilinear
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleCenterCrop
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: ImageToTensor
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: Normalize
|
||||
MEAN: [ 0.5, 0.5, 0.5 ]
|
||||
STD: [ 0.5, 0.5, 0.5 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'image' ]
|
||||
BACKEND: torchvision
|
||||
- NAME: Select
|
||||
KEYS: [ 'image', 'prompt' ]
|
||||
META_KEYS: [ 'data_key' ]
|
||||
#
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "a boy wearing a jacket", "a dog running on the lawn" ]
|
||||
IMAGE_SIZE: [ 1024, 1024 ]
|
||||
FIELDS: [ "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: ''
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 2
|
||||
NUM_WORKERS: 4
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'index', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
- NAME: BackwardHook
|
||||
# GRADIENT_CLIP: 1.0
|
||||
PRIORITY: 10
|
||||
- NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
-
|
||||
NAME: TensorboardLogHook
|
||||
-
|
||||
NAME: CheckpointHook
|
||||
INTERVAL: 10000
|
||||
PRIORITY: 200
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
DISABLE_SNAPSHOT: True
|
||||
EVAL_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
@@ -0,0 +1,223 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
#
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionSolver
|
||||
RESUME_FROM:
|
||||
LOAD_MODEL_ONLY: True
|
||||
USE_FSDP: False
|
||||
SHARDING_STRATEGY:
|
||||
USE_AMP: True
|
||||
DTYPE: float16
|
||||
CHANNELS_LAST: True
|
||||
MAX_STEPS: 1000
|
||||
MAX_EPOCHS: -1
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/dit_pixart_alpha_1024_lora
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
FREEZE:
|
||||
#
|
||||
TUNER:
|
||||
- NAME: SwiftLoRA
|
||||
R: 128
|
||||
LORA_ALPHA: 128
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "model.*(.q|.k|.v|.o|mlp.fc1|mlp.fc2)$"
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionPixart
|
||||
PARAMETERIZATION: eps
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA:
|
||||
ZERO_TERMINAL_SNR: False
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
SCALE_FACTOR: 0.18215
|
||||
SIZE_FACTOR: 8
|
||||
DECODER_BIAS: 0.5
|
||||
DEFAULT_N_PROMPT:
|
||||
SCHEDULE_ARGS:
|
||||
"NAME": "linear"
|
||||
"BETA_MIN": 0.0001
|
||||
"BETA_MAX": 0.02
|
||||
USE_EMA: False
|
||||
LOAD_REFINER: False
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: PixArt
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/PixArt-alpha@PixArt-XL-2-1024-MS.pth
|
||||
INPUT_SIZE: 128
|
||||
PATCH_SIZE: 2
|
||||
IN_CHANNELS: 4
|
||||
HIDDEN_SIZE: 1152
|
||||
DEPTH: 28
|
||||
NUM_HEADS: 16
|
||||
MLP_RATIO: 4.0
|
||||
CLASS_DROPOUT_PROB: 0.1
|
||||
PRED_SIGMA: True
|
||||
DROP_PATH: 0.0
|
||||
WINDOW_DIZE: 0
|
||||
USE_REL_POS: False
|
||||
CAPTION_CHANNELS: 4096
|
||||
LEWEI_SCALE: 2
|
||||
MODEL_MAX_LENGTH: 120
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKL
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-2-base@512-base-ema.safetensors
|
||||
EMBED_DIM: 4
|
||||
IGNORE_KEYS: [ ]
|
||||
BATCH_SIZE: 1
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/PixArt-alpha@t5-v1_1-xxl/
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/PixArt-alpha@t5-v1_1-xxl/
|
||||
LENGTH: 120
|
||||
CLEAN: heavy
|
||||
USE_GRAD: False
|
||||
#
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 20
|
||||
SEED: 2024
|
||||
GUIDE_SCALE: 4.5
|
||||
GUIDE_RESCALE: 0.5
|
||||
DISCRETIZATION: trailing
|
||||
RUN_TRAIN_N: False
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
AMSGRAD: False
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: ImageTextPairMSDataset
|
||||
MODE: train
|
||||
MS_DATASET_NAME: style_custom_dataset
|
||||
MS_DATASET_NAMESPACE: damo
|
||||
MS_DATASET_SUBNAME: 3D
|
||||
PROMPT_PREFIX: ""
|
||||
MS_DATASET_SPLIT: train
|
||||
MS_REMAP_KEYS: { 'Image:FILE': 'Target:FILE' }
|
||||
REPLACE_STYLE: False
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
TRANSFORMS:
|
||||
- NAME: LoadImageFromFile
|
||||
RGB_ORDER: RGB
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleResize
|
||||
INTERPOLATION: bilinear
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleCenterCrop
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: ImageToTensor
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: Normalize
|
||||
MEAN: [ 0.5, 0.5, 0.5 ]
|
||||
STD: [ 0.5, 0.5, 0.5 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'image' ]
|
||||
BACKEND: torchvision
|
||||
- NAME: Select
|
||||
KEYS: [ 'image', 'prompt' ]
|
||||
META_KEYS: [ 'data_key' ]
|
||||
#
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "a boy wearing a jacket", "a dog running on the lawn" ]
|
||||
IMAGE_SIZE: [ 1024, 1024 ]
|
||||
FIELDS: [ "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: ''
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'index', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
-
|
||||
NAME: BackwardHook
|
||||
PRIORITY: 0
|
||||
-
|
||||
NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
SHOW_GPU_MEM: True
|
||||
-
|
||||
NAME: TensorboardLogHook
|
||||
-
|
||||
NAME: CheckpointHook
|
||||
INTERVAL: 10000
|
||||
PRIORITY: 200
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
DISABLE_SNAPSHOT: True
|
||||
#
|
||||
EVAL_HOOKS:
|
||||
-
|
||||
NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
SAVE_PROBE_PREFIX: 'image'
|
||||
@@ -0,0 +1,233 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
#
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionSolver
|
||||
RESUME_FROM:
|
||||
LOAD_MODEL_ONLY: True
|
||||
USE_FSDP: False
|
||||
SHARDING_STRATEGY:
|
||||
USE_AMP: True
|
||||
DTYPE: float16
|
||||
CHANNELS_LAST: True
|
||||
MAX_STEPS: 500
|
||||
MAX_EPOCHS: -1
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 50
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/dit_sd3_1024
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
- NAME: "ModelscopeFs"
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionSD3
|
||||
PARAMETERIZATION: rf
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA:
|
||||
ZERO_TERMINAL_SNR: False
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
SCALE_FACTOR: 1.5305
|
||||
SHIFT_FACTOR: 0.0609
|
||||
DEFAULT_N_PROMPT:
|
||||
SCHEDULE_ARGS:
|
||||
"NAME": "shifted"
|
||||
"SHIFT": 3
|
||||
USE_EMA: False
|
||||
T_WEIGHT: uniform
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: MMDiT
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-3-medium@sd3_medium.safetensors
|
||||
IGNORE_KEYS: '^first_stage_model.'
|
||||
IN_CHANNELS: 16
|
||||
PATCH_SIZE: 2
|
||||
OUT_CHANNELS: 16
|
||||
DEPTH: 24
|
||||
INPUT_SIZE:
|
||||
ADM_IN_CHANNELS: 2048
|
||||
CONTEXT_EMBEDDER_CONFIG: { 'target': 'torch.nn.Linear', 'params': { 'in_features': 4096, 'out_features': 1536 } }
|
||||
NUM_PATCHES: 36864
|
||||
POS_EMBED_MAX_SIZE: 192
|
||||
POS_EMBED_SCALING_FACTOR:
|
||||
USE_CHECKPOINT: True
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKL
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-3-medium@sd3_medium.safetensors
|
||||
EMBED_DIM: 16
|
||||
IGNORE_KEYS: '^model.diffusion_model.'
|
||||
BATCH_SIZE: 1
|
||||
USE_CONV: False
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: SD3TextEmbedder
|
||||
P_ZERO: 0.0
|
||||
CLIP_L:
|
||||
NAME: FrozenCLIPEmbedder2
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@text_encoder
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@tokenizer
|
||||
MAX_LENGTH: 77
|
||||
FREEZE: True
|
||||
LAYER: penultimate
|
||||
RETURN_POOLED: True
|
||||
USE_FINAL_LAYER_NORM: False
|
||||
IS_TRAINABLE: False
|
||||
CLIP_G:
|
||||
NAME: FrozenCLIPEmbedder2
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@text_encoder_2
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@tokenizer_2
|
||||
MAX_LENGTH: 77
|
||||
FREEZE: True
|
||||
LAYER: penultimate
|
||||
RETURN_POOLED: True
|
||||
USE_FINAL_LAYER_NORM: False
|
||||
IS_TRAINABLE: False
|
||||
T5_XXL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@text_encoder_3
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@tokenizer_3
|
||||
LENGTH: 256
|
||||
CLEAN: whitespace
|
||||
USE_GRAD: False
|
||||
T5_DTYPE: float16
|
||||
#
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: euler
|
||||
SAMPLE_STEPS: 28
|
||||
SEED: 1749023094
|
||||
GUIDE_SCALE: 5.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
DISCRETIZATION: trailing
|
||||
RUN_TRAIN_N: False
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 1e-5
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
AMSGRAD: False
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: ImageTextPairMSDataset
|
||||
MODE: train
|
||||
MS_DATASET_NAME: style_custom_dataset
|
||||
MS_DATASET_NAMESPACE: damo
|
||||
MS_DATASET_SUBNAME: 3D
|
||||
PROMPT_PREFIX: ""
|
||||
MS_DATASET_SPLIT: train
|
||||
MS_REMAP_KEYS: { 'Image:FILE': 'Target:FILE' }
|
||||
REPLACE_STYLE: False
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
TRANSFORMS:
|
||||
- NAME: LoadImageFromFile
|
||||
RGB_ORDER: RGB
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleResize
|
||||
INTERPOLATION: bilinear
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleCenterCrop
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: ImageToTensor
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: Normalize
|
||||
MEAN: [ 0.5, 0.5, 0.5 ]
|
||||
STD: [ 0.5, 0.5, 0.5 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'image' ]
|
||||
BACKEND: torchvision
|
||||
- NAME: Select
|
||||
KEYS: [ 'image', 'prompt' ]
|
||||
META_KEYS: [ 'data_key' ]
|
||||
#
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "a cat holds a blackboard that writes \"hello world\"", "a dog running on the lawn" ]
|
||||
IMAGE_SIZE: [ 1024, 1024 ]
|
||||
FIELDS: [ "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: ''
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'index', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
-
|
||||
NAME: BackwardHook
|
||||
PRIORITY: 10000
|
||||
-
|
||||
NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
SHOW_GPU_MEM: True
|
||||
-
|
||||
NAME: TensorboardLogHook
|
||||
-
|
||||
NAME: CheckpointHook
|
||||
INTERVAL: 10000
|
||||
PRIORITY: 200
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
DISABLE_SNAPSHOT: True
|
||||
#
|
||||
EVAL_HOOKS:
|
||||
-
|
||||
NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 50
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
SAVE_PROBE_PREFIX: 'image'
|
||||
@@ -0,0 +1,241 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
#
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionSolver
|
||||
RESUME_FROM:
|
||||
LOAD_MODEL_ONLY: True
|
||||
USE_FSDP: False
|
||||
SHARDING_STRATEGY:
|
||||
USE_AMP: True
|
||||
DTYPE: float16
|
||||
CHANNELS_LAST: True
|
||||
MAX_STEPS: 500
|
||||
MAX_EPOCHS: -1
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 50
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/dit_sd3_1024_lora
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
- NAME: "ModelscopeFs"
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
#
|
||||
TUNER:
|
||||
- NAME: SwiftLoRA
|
||||
R: 128
|
||||
LORA_ALPHA: 128
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "model.*(.attn.qkv|.attn.proj|mlp.fc1|mlp.fc2)$"
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionSD3
|
||||
PARAMETERIZATION: rf
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA:
|
||||
ZERO_TERMINAL_SNR: False
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
SCALE_FACTOR: 1.5305
|
||||
SHIFT_FACTOR: 0.0609
|
||||
DEFAULT_N_PROMPT:
|
||||
SCHEDULE_ARGS:
|
||||
"NAME": "shifted"
|
||||
"SHIFT": 3
|
||||
USE_EMA: False
|
||||
T_WEIGHT: uniform
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: MMDiT
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-3-medium@sd3_medium.safetensors
|
||||
IGNORE_KEYS: '^first_stage_model.'
|
||||
IN_CHANNELS: 16
|
||||
PATCH_SIZE: 2
|
||||
OUT_CHANNELS: 16
|
||||
DEPTH: 24
|
||||
INPUT_SIZE:
|
||||
ADM_IN_CHANNELS: 2048
|
||||
CONTEXT_EMBEDDER_CONFIG: { 'target': 'torch.nn.Linear', 'params': { 'in_features': 4096, 'out_features': 1536 } }
|
||||
NUM_PATCHES: 36864
|
||||
POS_EMBED_MAX_SIZE: 192
|
||||
POS_EMBED_SCALING_FACTOR:
|
||||
USE_CHECKPOINT: True
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKL
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-3-medium@sd3_medium.safetensors
|
||||
EMBED_DIM: 16
|
||||
IGNORE_KEYS: '^model.diffusion_model.'
|
||||
BATCH_SIZE: 1
|
||||
USE_CONV: False
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: SD3TextEmbedder
|
||||
P_ZERO: 0.0
|
||||
CLIP_L:
|
||||
NAME: FrozenCLIPEmbedder2
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@text_encoder
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@tokenizer
|
||||
MAX_LENGTH: 77
|
||||
FREEZE: True
|
||||
LAYER: penultimate
|
||||
RETURN_POOLED: True
|
||||
USE_FINAL_LAYER_NORM: False
|
||||
IS_TRAINABLE: False
|
||||
CLIP_G:
|
||||
NAME: FrozenCLIPEmbedder2
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@text_encoder_2
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@tokenizer_2
|
||||
MAX_LENGTH: 77
|
||||
FREEZE: True
|
||||
LAYER: penultimate
|
||||
RETURN_POOLED: True
|
||||
USE_FINAL_LAYER_NORM: False
|
||||
IS_TRAINABLE: False
|
||||
T5_XXL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@text_encoder_3
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@tokenizer_3
|
||||
LENGTH: 256
|
||||
CLEAN: whitespace
|
||||
USE_GRAD: False
|
||||
T5_DTYPE: float16
|
||||
#
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: euler
|
||||
SAMPLE_STEPS: 28
|
||||
SEED: 1749023094
|
||||
GUIDE_SCALE: 5.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
DISCRETIZATION: trailing
|
||||
RUN_TRAIN_N: False
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 5e-5
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
AMSGRAD: False
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: ImageTextPairMSDataset
|
||||
MODE: train
|
||||
MS_DATASET_NAME: style_custom_dataset
|
||||
MS_DATASET_NAMESPACE: damo
|
||||
MS_DATASET_SUBNAME: 3D
|
||||
PROMPT_PREFIX: ""
|
||||
MS_DATASET_SPLIT: train
|
||||
MS_REMAP_KEYS: { 'Image:FILE': 'Target:FILE' }
|
||||
REPLACE_STYLE: False
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
TRANSFORMS:
|
||||
- NAME: LoadImageFromFile
|
||||
RGB_ORDER: RGB
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleResize
|
||||
INTERPOLATION: bilinear
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleCenterCrop
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: ImageToTensor
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: Normalize
|
||||
MEAN: [ 0.5, 0.5, 0.5 ]
|
||||
STD: [ 0.5, 0.5, 0.5 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'image' ]
|
||||
BACKEND: torchvision
|
||||
- NAME: Select
|
||||
KEYS: [ 'image', 'prompt' ]
|
||||
META_KEYS: [ 'data_key' ]
|
||||
#
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "a cat holds a blackboard that writes \"hello world\"", "a dog running on the lawn" ]
|
||||
IMAGE_SIZE: [ 1024, 1024 ]
|
||||
FIELDS: [ "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: ''
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'index', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
-
|
||||
NAME: BackwardHook
|
||||
PRIORITY: 10000
|
||||
-
|
||||
NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
SHOW_GPU_MEM: True
|
||||
-
|
||||
NAME: TensorboardLogHook
|
||||
-
|
||||
NAME: CheckpointHook
|
||||
INTERVAL: 10000
|
||||
PRIORITY: 200
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
DISABLE_SNAPSHOT: True
|
||||
#
|
||||
EVAL_HOOKS:
|
||||
-
|
||||
NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 50
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
SAVE_PROBE_PREFIX: 'image'
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sd15_512_full
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusion
|
||||
@@ -124,7 +125,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.0064
|
||||
LEARNING_RATE: 0.00001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -190,7 +191,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
-
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sd15_512_lora
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
TUNER:
|
||||
-
|
||||
NAME: SwiftLoRA
|
||||
@@ -132,7 +133,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -198,7 +199,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
-
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sd15_512_textlora
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
TUNER:
|
||||
-
|
||||
NAME: SwiftLoRA
|
||||
@@ -140,7 +141,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -206,7 +207,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
-
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sd21_512_full
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusion
|
||||
@@ -120,7 +121,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.0064
|
||||
LEARNING_RATE: 0.00001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -186,7 +187,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
-
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sd21_512_lora
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
-
|
||||
@@ -129,7 +130,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.0064
|
||||
LEARNING_RATE: 0.00001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -195,7 +196,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
-
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sd21_768_full
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusion
|
||||
@@ -120,7 +121,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.0064
|
||||
LEARNING_RATE: 0.00001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -186,7 +187,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
-
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sd21_768_lora
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
-
|
||||
@@ -129,7 +130,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -195,7 +196,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
-
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sdxl_1024_full
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionXL
|
||||
@@ -238,7 +239,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.0064
|
||||
LEARNING_RATE: 0.00001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -306,7 +307,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sdxl_1024_lora
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
-
|
||||
@@ -247,7 +248,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -315,7 +316,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sdxl_1024_textlora
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
-
|
||||
@@ -255,7 +256,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -323,7 +324,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sd15_512_sce_ctr_hed
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
FREEZE:
|
||||
FREEZE_PART: [ "first_stage_model", "cond_stage_model", "model" ]
|
||||
@@ -127,7 +128,7 @@ SOLVER:
|
||||
DOWN_RATIO: 1.0
|
||||
CONTROL_ANNO:
|
||||
NAME: HedAnnotator
|
||||
PRETRAINED_MODEL: ms://damo/scepter_scedit@annotator/ckpts/ControlNetHED.pth
|
||||
PRETRAINED_MODEL: ms://iic/scepter_scedit@annotator/ckpts/ControlNetHED.pth
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
@@ -141,7 +142,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -167,13 +168,13 @@ SOLVER:
|
||||
RGB_ORDER: RGB
|
||||
BACKEND: pillow
|
||||
- NAME: Resize
|
||||
SIZE: 768
|
||||
SIZE: 512
|
||||
INTERPOLATION: bilinear
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: CenterCrop
|
||||
SIZE: 768
|
||||
SIZE: 512
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
@@ -215,13 +216,13 @@ SOLVER:
|
||||
RGB_ORDER: RGB
|
||||
BACKEND: pillow
|
||||
- NAME: Resize
|
||||
SIZE: 768
|
||||
SIZE: 512
|
||||
INTERPOLATION: bilinear
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: CenterCrop
|
||||
SIZE: 768
|
||||
SIZE: 512
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sd21_768_sce_ctr_canny
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
FREEZE:
|
||||
FREEZE_PART: [ "first_stage_model", "cond_stage_model", "model" ]
|
||||
@@ -140,7 +141,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sd21_768_sce_ctr_pose
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
FREEZE:
|
||||
FREEZE_PART: [ "first_stage_model", "cond_stage_model", "model" ]
|
||||
@@ -125,8 +126,8 @@ SOLVER:
|
||||
DOWN_RATIO: 1.0
|
||||
CONTROL_ANNO:
|
||||
NAME: OpenposeAnnotator
|
||||
BODY_MODEL_PATH: ms://damo/scepter_scedit@annotator/ckpts/body_pose_model.pth
|
||||
HAND_MODEL_PATH: ms://damo/scepter_scedit@annotator/ckpts/hand_pose_model.pth
|
||||
BODY_MODEL_PATH: ms://iic/scepter_scedit@annotator/ckpts/body_pose_model.pth
|
||||
HAND_MODEL_PATH: ms://iic/scepter_scedit@annotator/ckpts/hand_pose_model.pth
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
@@ -140,7 +141,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sdxl_1024_sce_ctr_canny
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
FREEZE:
|
||||
FREEZE_PART: [ "first_stage_model", "cond_stage_model", "model" ]
|
||||
@@ -254,7 +255,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sdxl_1024_sce_ctr_color
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
FREEZE:
|
||||
FREEZE_PART: [ "first_stage_model", "cond_stage_model", "model" ]
|
||||
@@ -255,7 +256,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sdxl_1024_sce_ctr_color_datatxt
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
FREEZE:
|
||||
FREEZE_PART: [ "first_stage_model", "cond_stage_model", "model" ]
|
||||
@@ -255,7 +256,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sdxl_1024_sce_ctr_depth
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
FREEZE:
|
||||
FREEZE_PART: [ "first_stage_model", "cond_stage_model", "model" ]
|
||||
@@ -241,7 +242,7 @@ SOLVER:
|
||||
DOWN_RATIO: 1.0
|
||||
CONTROL_ANNO:
|
||||
NAME: MidasDetector
|
||||
PRETRAINED_MODEL: ms://damo/scepter_scedit@annotator/ckpts/dpt_hybrid-midas-501f0c75.pt
|
||||
PRETRAINED_MODEL: ms://iic/scepter_scedit@annotator/ckpts/dpt_hybrid-midas-501f0c75.pt
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
@@ -255,7 +256,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sd15_512_sce_t2i
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
FREEZE:
|
||||
FREEZE_PART: [ "first_stage_model", "cond_stage_model", "model" ]
|
||||
@@ -134,7 +135,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -200,7 +201,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
-
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sd15_512_sce_t2i_swift
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
-
|
||||
@@ -132,7 +133,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -198,7 +199,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
-
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sd15_512_textsce_t2i_swift
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
-
|
||||
@@ -140,7 +141,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -206,7 +207,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
-
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sd21_768_sce_t2i
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
FREEZE:
|
||||
FREEZE_PART: [ "first_stage_model", "cond_stage_model", "model" ]
|
||||
@@ -130,7 +131,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -196,7 +197,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
-
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sd21_768_sce_t2i_swift
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
-
|
||||
@@ -128,7 +129,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -194,7 +195,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
-
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sdxl_1024_sce_t2i
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
FREEZE:
|
||||
FREEZE_PART: [ "first_stage_model", "cond_stage_model", "model" ]
|
||||
@@ -247,7 +248,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -315,7 +316,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sdxl_1024_sce_t2i_datatxt
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
FREEZE:
|
||||
FREEZE_PART: [ "first_stage_model", "cond_stage_model", "model" ]
|
||||
@@ -247,7 +248,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sdxl_1024_sce_t2i_swift
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
-
|
||||
@@ -245,7 +246,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -313,7 +314,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
|
||||
@@ -14,13 +14,14 @@ SOLVER:
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 100
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/sdxl_1024_textsce_t2i_swift
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
-
|
||||
@@ -253,7 +254,7 @@ SOLVER:
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 0.064
|
||||
LEARNING_RATE: 0.0001
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
@@ -321,7 +322,7 @@ SOLVER:
|
||||
NUM_WORKERS: 4
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/data"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
|
||||
@@ -0,0 +1,25 @@
|
||||
WORK_DIR: chatbot
|
||||
FILE_SYSTEM:
|
||||
- NAME: LocalFs
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
- NAME: ModelscopeFs
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
- NAME: HuggingfaceFs
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
#
|
||||
ENABLE_I2V: False
|
||||
SKIP_EXAMPLES: True
|
||||
#
|
||||
MODEL:
|
||||
EDIT_MODEL:
|
||||
MODEL_CFG_DIR: scepter/methods/studio/chatbot/models/
|
||||
I2V:
|
||||
MODEL_NAME: CogVideoX-5b-I2V
|
||||
MODEL_DIR: ms://ZhipuAI/CogVideoX-5b-I2V/
|
||||
CAPTIONER:
|
||||
MODEL_NAME: InternVL2-2B
|
||||
MODEL_DIR: ms://OpenGVLab/InternVL2-2B/
|
||||
PROMPT: '<image>\nThis image is the first frame of a video. Based on this image, please imagine what changes may occur in the next few seconds of the video. Please output brief description, such as "a dog running" or "a person turns to left". No more than 30 words.'
|
||||
ENHANCER:
|
||||
MODEL_NAME: Meta-Llama-3.1-8B-Instruct
|
||||
MODEL_DIR: ms://LLM-Research/Meta-Llama-3.1-8B-Instruct/
|
||||
@@ -0,0 +1,128 @@
|
||||
NAME: ACE_0.6B_1024
|
||||
IS_DEFAULT: False
|
||||
USE_DYNAMIC_MODEL: True
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
#
|
||||
INPUT:
|
||||
INPUT_IMAGE:
|
||||
INPUT_MASK:
|
||||
TASK:
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT: ""
|
||||
OUTPUT_HEIGHT: 1024
|
||||
OUTPUT_WIDTH: 1024
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
GUIDE_SCALE: 4.5
|
||||
GUIDE_RESCALE: 0.5
|
||||
SEED: -1
|
||||
TAR_INDEX: 0
|
||||
OUTPUT:
|
||||
LATENT:
|
||||
IMAGES:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: encode
|
||||
DTYPE: float16
|
||||
INPUT: ["IMAGE"]
|
||||
- NAME: decode
|
||||
DTYPE: float16
|
||||
INPUT: ["LATENT"]
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: forward
|
||||
DTYPE: float16
|
||||
INPUT: ["SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE"]
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: encode_list_of_list
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["PROMPT"]
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionACE
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
SCALE_FACTOR: 0.18215
|
||||
SIZE_FACTOR: 8
|
||||
DECODER_BIAS: 0.5
|
||||
DEFAULT_N_PROMPT: ""
|
||||
TEXT_IDENTIFIER: [ '{image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
USE_TEXT_POS_EMBEDDINGS: True
|
||||
#
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: eps
|
||||
MIN_SNR_GAMMA:
|
||||
NOISE_SCHEDULER:
|
||||
NAME: LinearScheduler
|
||||
NUM_TIMESTEPS: 1000
|
||||
BETA_MIN: 0.0001
|
||||
BETA_MAX: 0.02
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: ACE
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/dit/ace_0.6b_1024px.pth
|
||||
IGNORE_KEYS: [ ]
|
||||
PATCH_SIZE: 2
|
||||
IN_CHANNELS: 4
|
||||
HIDDEN_SIZE: 1152
|
||||
DEPTH: 28
|
||||
NUM_HEADS: 16
|
||||
MLP_RATIO: 4.0
|
||||
PRED_SIGMA: True
|
||||
DROP_PATH: 0.0
|
||||
WINDOW_DIZE: 0
|
||||
Y_CHANNELS: 4096
|
||||
MAX_SEQ_LEN: 4096
|
||||
QK_NORM: True
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
ATTENTION_BACKEND: flash_attn
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKL
|
||||
EMBED_DIM: 4
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/vae/vae.bin
|
||||
IGNORE_KEYS: []
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/text_encoder/t5-v1_1-xxl/
|
||||
TOKENIZER_PATH: ms://iic/ACE-0.6B-1024px@models/tokenizer/t5-v1_1-xxl
|
||||
LENGTH: 120
|
||||
T5_DTYPE: bfloat16
|
||||
ADDED_IDENTIFIER: [ '{image}', '{caption}', '{mask}', '{ref_image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
CLEAN: whitespace
|
||||
USE_GRAD: False
|
||||
@@ -0,0 +1,284 @@
|
||||
NAME: ACE_0.6B_1024_REFINER
|
||||
IS_DEFAULT: False
|
||||
USE_DYNAMIC_MODEL: True
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
#
|
||||
INPUT:
|
||||
INPUT_IMAGE:
|
||||
INPUT_MASK:
|
||||
TASK:
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT: ""
|
||||
OUTPUT_HEIGHT: 1024
|
||||
OUTPUT_WIDTH: 1024
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
GUIDE_SCALE: 4.5
|
||||
GUIDE_RESCALE: 0.5
|
||||
SEED: -1
|
||||
TAR_INDEX: 0
|
||||
REFINER_SCALE: 0.2
|
||||
USE_ACE: True
|
||||
#REFINER_PROMPT: "High Resolution, Sharpness, Clarity, Detail Enhancement, Noise Reduction, HD, 4k, Image Restoration, HDR"
|
||||
REFINER_PROMPT: "High Resolution, Sharpness, Clarity, Detail Enhancement, Noise Reduction, HD, 4k, Image Restoration, HDR"
|
||||
OUTPUT:
|
||||
LATENT:
|
||||
IMAGES:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: encode
|
||||
DTYPE: float16
|
||||
INPUT: ["IMAGE"]
|
||||
- NAME: decode
|
||||
DTYPE: float16
|
||||
INPUT: ["LATENT"]
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: forward
|
||||
DTYPE: float16
|
||||
INPUT: ["SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE"]
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: encode_list_of_list
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["PROMPT"]
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionACE
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
SCALE_FACTOR: 0.18215
|
||||
SIZE_FACTOR: 8
|
||||
DECODER_BIAS: 0.5
|
||||
DEFAULT_N_PROMPT: ""
|
||||
TEXT_IDENTIFIER: [ '{image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
USE_TEXT_POS_EMBEDDINGS: True
|
||||
#
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: eps
|
||||
MIN_SNR_GAMMA:
|
||||
NOISE_SCHEDULER:
|
||||
NAME: LinearScheduler
|
||||
NUM_TIMESTEPS: 1000
|
||||
BETA_MIN: 0.0001
|
||||
BETA_MAX: 0.02
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: ACE
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/dit/ace_0.6b_1024px.pth
|
||||
IGNORE_KEYS: [ ]
|
||||
PATCH_SIZE: 2
|
||||
IN_CHANNELS: 4
|
||||
HIDDEN_SIZE: 1152
|
||||
DEPTH: 28
|
||||
NUM_HEADS: 16
|
||||
MLP_RATIO: 4.0
|
||||
PRED_SIGMA: True
|
||||
DROP_PATH: 0.0
|
||||
WINDOW_DIZE: 0
|
||||
Y_CHANNELS: 4096
|
||||
MAX_SEQ_LEN: 4096
|
||||
QK_NORM: True
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
ATTENTION_BACKEND: flash_attn
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKL
|
||||
EMBED_DIM: 4
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/vae/vae.bin
|
||||
IGNORE_KEYS: []
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/text_encoder/t5-v1_1-xxl/
|
||||
TOKENIZER_PATH: ms://iic/ACE-0.6B-1024px@models/tokenizer/t5-v1_1-xxl
|
||||
LENGTH: 120
|
||||
T5_DTYPE: bfloat16
|
||||
ADDED_IDENTIFIER: [ '{image}', '{caption}', '{mask}', '{ref_image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
CLEAN: whitespace
|
||||
USE_GRAD: False
|
||||
|
||||
ACE_PROMPT: [
|
||||
"A cute cartoon rabbit holding a whiteboard that says 'ACE Refiner', standing in a sunny meadow filled with flowers, with a big smile and bright colors.",
|
||||
"A beautiful young woman with long flowing hair, wearing a summer dress, holding a whiteboard that reads 'ACE Refiner' while sitting on a park bench surrounded by cherry blossoms.",
|
||||
"An adorable cartoon cat wearing oversized glasses, holding a whiteboard that says 'ACE Refiner', perched on a stack of colorful books in a cozy library setting.",
|
||||
"A charming girl with pigtails, wearing a cute school uniform, enthusiastically holding a whiteboard that has 'ACE Refiner' written on it, in a bright and cheerful classroom full of educational posters.",
|
||||
"A friendly cartoon dog with floppy ears, sitting in front of a doghouse, proudly holding a whiteboard that says 'ACE Refiner', with a playful expression and a blue sky in the background.",
|
||||
"A cute anime girl with big expressive eyes, dressed in a colorful outfit, holding a whiteboard that reads 'ACE Refiner' in a fantastical landscape filled with mythical creatures.",
|
||||
"A vibrant cartoon fox holding a whiteboard that says 'ACE Refiner', standing on a rock by a sparkling stream, surrounded by lush greenery and butterflies.",
|
||||
"A stylish young woman in a business outfit, smiling as she holds a whiteboard written with 'ACE Refiner', in a modern office filled with plants and natural light.",
|
||||
"A cute cartoon unicorn holding a sparkling whiteboard that says 'ACE Refiner', frolicking in a magical forest, with rainbows and stars in the background.",
|
||||
"A happy family, consisting of a cute little girl and her playful puppy, holding a whiteboard that says 'ACE Refiner', together in their backyard on a sunny day."
|
||||
]
|
||||
REFINER_MODEL:
|
||||
NAME: ""
|
||||
IS_DEFAULT: False
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
RESOLUTIONS: [ [ 1024, 1024 ] ]
|
||||
INPUT:
|
||||
INPUT_IMAGE:
|
||||
INPUT_MASK:
|
||||
TASK:
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT: ""
|
||||
OUTPUT_HEIGHT: 1024
|
||||
OUTPUT_WIDTH: 1024
|
||||
SAMPLER: flow_euler
|
||||
SAMPLE_STEPS: 30
|
||||
GUIDE_SCALE: 3.5
|
||||
GUIDE_RESCALE:
|
||||
OUTPUT:
|
||||
LATENT:
|
||||
IMAGES:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: encode
|
||||
DTYPE: bfloat16
|
||||
INPUT: [ "IMAGE" ]
|
||||
- NAME: decode
|
||||
DTYPE: bfloat16
|
||||
INPUT: [ "LATENT" ]
|
||||
PARAS:
|
||||
SCALE_FACTOR: 1.5305
|
||||
SHIFT_FACTOR: 0.0609
|
||||
SIZE_FACTOR: 8
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: forward
|
||||
DTYPE: bfloat16
|
||||
INPUT: [ "SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE" ]
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: encode
|
||||
DTYPE: bfloat16
|
||||
INPUT: [ "PROMPT" ]
|
||||
|
||||
MODEL:
|
||||
DIFFUSION:
|
||||
NAME: DiffusionFluxRF
|
||||
PREDICTION_TYPE: raw
|
||||
NOISE_SCHEDULER:
|
||||
NAME: FlowMatchSigmaScheduler
|
||||
WEIGHTING_SCHEME: logit_normal
|
||||
SHIFT: 3.0
|
||||
LOGIT_MEAN: 0.0
|
||||
LOGIT_STD: 1.0
|
||||
MODE_SCALE: 1.29
|
||||
DIFFUSION_MODEL:
|
||||
NAME: FluxMR
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-dev@flux1-dev.safetensors
|
||||
IN_CHANNELS: 64
|
||||
OUT_CHANNELS: 64
|
||||
HIDDEN_SIZE: 3072
|
||||
NUM_HEADS: 24
|
||||
AXES_DIM: [ 16, 56, 56 ]
|
||||
THETA: 10000
|
||||
VEC_IN_DIM: 768
|
||||
GUIDANCE_EMBED: True
|
||||
CONTEXT_IN_DIM: 4096
|
||||
MLP_RATIO: 4.0
|
||||
QKV_BIAS: True
|
||||
DEPTH: 19
|
||||
DEPTH_SINGLE_BLOCKS: 38
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
ATTN_BACKEND: flash_attn
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLFlux
|
||||
EMBED_DIM: 16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-dev@ae.safetensors
|
||||
IGNORE_KEYS: [ ]
|
||||
BATCH_SIZE: 8
|
||||
USE_CONV: False
|
||||
SCALE_FACTOR: 0.3611
|
||||
SHIFT_FACTOR: 0.1159
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
USE_CHECKPOINT: False
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
USE_CHECKPOINT: False
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5PlusClipFluxEmbedder
|
||||
T5_MODEL:
|
||||
NAME: HFEmbedder
|
||||
HF_MODEL_CLS: T5EncoderModel
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-dev@text_encoder_2/
|
||||
HF_TOKENIZER_CLS: T5Tokenizer
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-dev@tokenizer_2/
|
||||
MAX_LENGTH: 512
|
||||
OUTPUT_KEY: last_hidden_state
|
||||
D_TYPE: bfloat16
|
||||
BATCH_INFER: False
|
||||
CLEAN: whitespace
|
||||
CLIP_MODEL:
|
||||
NAME: HFEmbedder
|
||||
HF_MODEL_CLS: CLIPTextModel
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-dev@text_encoder/
|
||||
HF_TOKENIZER_CLS: CLIPTokenizer
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-dev@tokenizer/
|
||||
MAX_LENGTH: 77
|
||||
OUTPUT_KEY: pooler_output
|
||||
D_TYPE: bfloat16
|
||||
BATCH_INFER: True
|
||||
CLEAN: whitespace
|
||||
@@ -0,0 +1,128 @@
|
||||
NAME: ACE_0.6B_512
|
||||
IS_DEFAULT: True
|
||||
USE_DYNAMIC_MODEL: True
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
#
|
||||
INPUT:
|
||||
INPUT_IMAGE:
|
||||
INPUT_MASK:
|
||||
TASK:
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT: ""
|
||||
OUTPUT_HEIGHT: 512
|
||||
OUTPUT_WIDTH: 512
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 20
|
||||
GUIDE_SCALE: 4.5
|
||||
GUIDE_RESCALE: 0.5
|
||||
SEED: -1
|
||||
TAR_INDEX: 0
|
||||
OUTPUT:
|
||||
LATENT:
|
||||
IMAGES:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: encode
|
||||
DTYPE: float16
|
||||
INPUT: ["IMAGE"]
|
||||
- NAME: decode
|
||||
DTYPE: float16
|
||||
INPUT: ["LATENT"]
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: forward
|
||||
DTYPE: float16
|
||||
INPUT: ["SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE"]
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: encode_list_of_list
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["PROMPT"]
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionACE
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
SCALE_FACTOR: 0.18215
|
||||
SIZE_FACTOR: 8
|
||||
DECODER_BIAS: 0.5
|
||||
DEFAULT_N_PROMPT: ""
|
||||
TEXT_IDENTIFIER: [ '{image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
USE_TEXT_POS_EMBEDDINGS: True
|
||||
#
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: eps
|
||||
MIN_SNR_GAMMA:
|
||||
NOISE_SCHEDULER:
|
||||
NAME: LinearScheduler
|
||||
NUM_TIMESTEPS: 1000
|
||||
BETA_MIN: 0.0001
|
||||
BETA_MAX: 0.02
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: ACE
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-512px@models/dit/ace_0.6b_512px.pth
|
||||
IGNORE_KEYS: [ ]
|
||||
PATCH_SIZE: 2
|
||||
IN_CHANNELS: 4
|
||||
HIDDEN_SIZE: 1152
|
||||
DEPTH: 28
|
||||
NUM_HEADS: 16
|
||||
MLP_RATIO: 4.0
|
||||
PRED_SIGMA: True
|
||||
DROP_PATH: 0.0
|
||||
WINDOW_DIZE: 0
|
||||
Y_CHANNELS: 4096
|
||||
MAX_SEQ_LEN: 1024
|
||||
QK_NORM: True
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
ATTENTION_BACKEND: flash_attn
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKL
|
||||
EMBED_DIM: 4
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-512px@models/vae/vae.bin
|
||||
IGNORE_KEYS: []
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-512px@models/text_encoder/t5-v1_1-xxl/
|
||||
TOKENIZER_PATH: ms://iic/ACE-0.6B-512px@models/tokenizer/t5-v1_1-xxl
|
||||
LENGTH: 120
|
||||
T5_DTYPE: bfloat16
|
||||
ADDED_IDENTIFIER: [ '{image}', '{caption}', '{mask}', '{ref_image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
CLEAN: whitespace
|
||||
USE_GRAD: False
|
||||
@@ -5,59 +5,59 @@ CONTROLLERS:
|
||||
DESCRIPTION:
|
||||
BASE_MODEL: SD2.1
|
||||
TYPE: Canny
|
||||
MODEL_PATH: ms://damo/scepter_scedit@controllable_model/SD2.1/canny_control/
|
||||
MODEL_PATH: ms://iic/scepter_scedit@controllable_model/SD2.1/canny_control/
|
||||
- NAME: openpose
|
||||
NAME_ZH:
|
||||
DESCRIPTION:
|
||||
BASE_MODEL: SD2.1
|
||||
TYPE: Openpose
|
||||
MODEL_PATH: ms://damo/scepter_scedit@controllable_model/SD2.1/pose_control/
|
||||
MODEL_PATH: ms://iic/scepter_scedit@controllable_model/SD2.1/pose_control/
|
||||
- NAME: color
|
||||
NAME_ZH:
|
||||
DESCRIPTION:
|
||||
BASE_MODEL: SD2.1
|
||||
TYPE: Color
|
||||
MODEL_PATH: ms://damo/scepter_scedit@controllable_model/SD2.1/color_control/
|
||||
MODEL_PATH: ms://iic/scepter_scedit@controllable_model/SD2.1/color_control/
|
||||
- NAME: hed
|
||||
NAME_ZH:
|
||||
DESCRIPTION:
|
||||
BASE_MODEL: SD2.1
|
||||
TYPE: Hed
|
||||
MODEL_PATH: ms://damo/scepter_scedit@controllable_model/SD2.1/hed_control
|
||||
MODEL_PATH: ms://iic/scepter_scedit@controllable_model/SD2.1/hed_control
|
||||
- NAME: depth
|
||||
NAME_ZH:
|
||||
DESCRIPTION:
|
||||
BASE_MODEL: SD2.1
|
||||
TYPE: Midas
|
||||
MODEL_PATH: ms://damo/scepter_scedit@controllable_model/SD2.1/depth_control
|
||||
MODEL_PATH: ms://iic/scepter_scedit@controllable_model/SD2.1/depth_control
|
||||
# SD_XL1.0
|
||||
- NAME: canny
|
||||
NAME_ZH:
|
||||
DESCRIPTION:
|
||||
BASE_MODEL: SD_XL1.0
|
||||
TYPE: Canny
|
||||
MODEL_PATH: ms://damo/scepter_scedit@controllable_model/SD_XL1.0/canny_control
|
||||
MODEL_PATH: ms://iic/scepter_scedit@controllable_model/SD_XL1.0/canny_control
|
||||
- NAME: color
|
||||
NAME_ZH:
|
||||
DESCRIPTION:
|
||||
BASE_MODEL: SD_XL1.0
|
||||
TYPE: Color
|
||||
MODEL_PATH: ms://damo/scepter_scedit@controllable_model/SD_XL1.0/color_control
|
||||
MODEL_PATH: ms://iic/scepter_scedit@controllable_model/SD_XL1.0/color_control
|
||||
- NAME: depth
|
||||
NAME_ZH:
|
||||
DESCRIPTION:
|
||||
BASE_MODEL: SD_XL1.0
|
||||
TYPE: Midas
|
||||
MODEL_PATH: ms://damo/scepter_scedit@controllable_model/SD_XL1.0/depth_control
|
||||
MODEL_PATH: ms://iic/scepter_scedit@controllable_model/SD_XL1.0/depth_control
|
||||
- NAME: hed
|
||||
NAME_ZH:
|
||||
DESCRIPTION:
|
||||
BASE_MODEL: SD_XL1.0
|
||||
TYPE: Hed
|
||||
MODEL_PATH: ms://damo/scepter_scedit@controllable_model/SD_XL1.0/hed_control
|
||||
MODEL_PATH: ms://iic/scepter_scedit@controllable_model/SD_XL1.0/hed_control
|
||||
- NAME: openpose
|
||||
NAME_ZH:
|
||||
DESCRIPTION:
|
||||
BASE_MODEL: SD_XL1.0
|
||||
TYPE: Openpose
|
||||
MODEL_PATH: ms://damo/scepter_scedit@controllable_model/SD_XL1.0/pose_control
|
||||
MODEL_PATH: ms://iic/scepter_scedit@controllable_model/SD_XL1.0/pose_control
|
||||
|
||||
@@ -1,11 +1,20 @@
|
||||
TUNERS:
|
||||
- NAME: Clay-Style-Editing
|
||||
NAME_ZH: 黏土风
|
||||
SOURCE: scepter
|
||||
DESCRIPTION: None
|
||||
BASE_MODEL: EDIT
|
||||
MODEL_PATH: ms://iic/stylebooth@tuners/clay_style_edit/
|
||||
IMAGE_PATH: ms://iic/stylebooth@tuners/clay_style_edit/image.jpg
|
||||
TUNER_TYPE: LORA
|
||||
PROMPT_EXAMPLE: Convert this image into clay style
|
||||
- NAME: Azure-Dragon
|
||||
NAME_ZH: 青龙
|
||||
SOURCE: scepter
|
||||
DESCRIPTION: None
|
||||
BASE_MODEL: SD_XL1.0
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/azure_dragon/
|
||||
IMAGE_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/azure_dragon/xl_azure_dragon.png
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/azure_dragon/
|
||||
IMAGE_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/azure_dragon/xl_azure_dragon.png
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: Azure Dragon, 8K, high quality,Ultra High Detail.One of the Four Divine Creatures in Charge of Water.
|
||||
- NAME: Gold-Dragon
|
||||
@@ -13,8 +22,8 @@ TUNERS:
|
||||
SOURCE: scepter
|
||||
DESCRIPTION: None
|
||||
BASE_MODEL: SD_XL1.0
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/gold_dragon/
|
||||
IMAGE_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/gold_dragon/xl_gold_dragon.png
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/gold_dragon/
|
||||
IMAGE_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/gold_dragon/xl_gold_dragon.png
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: Chinese Gold Dragon in the clouds. Translucent Texture. Zbrush. Fuzzy Art. Exquisite Craftsmanship. 3D. 8K. Ultra High Detail
|
||||
- NAME: SpringFestival-Dragon
|
||||
@@ -22,8 +31,8 @@ TUNERS:
|
||||
SOURCE: scepter
|
||||
DESCRIPTION: None
|
||||
BASE_MODEL: SD_XL1.0
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/spring_festival_dragon/
|
||||
IMAGE_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/spring_festival_dragon/xl_spring_festival_dragon.png
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/spring_festival_dragon/
|
||||
IMAGE_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/spring_festival_dragon/xl_spring_festival_dragon.png
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: Chinese dragon. Spring Festival.Festive.Street.Lanterns.32K.High quality.expressive, dramatic, dreamlike and mysterious, Surrealism
|
||||
- NAME: Red-Dragon
|
||||
@@ -31,8 +40,8 @@ TUNERS:
|
||||
SOURCE: scepter
|
||||
DESCRIPTION: None
|
||||
BASE_MODEL: SD_XL1.0
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/red_dragon/
|
||||
IMAGE_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/red_dragon/xl_red_dragon.png
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/red_dragon/
|
||||
IMAGE_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/red_dragon/xl_red_dragon.png
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: Traditional Red Dragon of China. Low Water Level. Studio Ghibli Style. Mural Illustration. White Background. High Detail
|
||||
- NAME: ChinesePunk-Dragon
|
||||
@@ -40,8 +49,8 @@ TUNERS:
|
||||
SOURCE: scepter
|
||||
DESCRIPTION: None
|
||||
BASE_MODEL: SD_XL1.0
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/chinese_punk_dragon/
|
||||
IMAGE_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/chinese_punk_dragon/xl_chinese_punk_dragon.png
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/chinese_punk_dragon/
|
||||
IMAGE_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/chinese_punk_dragon/xl_chinese_punk_dragon.png
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: uhd Image,Dragon,Chinese Dragon, Dunhuang Mural Style, Traditional Maritime Art Style
|
||||
- NAME: Cute-Dragon
|
||||
@@ -49,8 +58,8 @@ TUNERS:
|
||||
SOURCE: scepter
|
||||
DESCRIPTION: None
|
||||
BASE_MODEL: SD_XL1.0
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/cute_dragon/
|
||||
IMAGE_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/cute_dragon/xl_kawaii_dragon.png
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/cute_dragon/
|
||||
IMAGE_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/cute_dragon/xl_kawaii_dragon.png
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: China Kawaii Dragon. Contest Winner. Minimalist Illustration. White Background. Flat Style. Digital Painting Style. Red. 32k uhd. Fun Comics. Fuzzy Art. Bold. Comic-Inspired Characters
|
||||
- NAME: Dragon-Baby
|
||||
@@ -58,8 +67,8 @@ TUNERS:
|
||||
SOURCE: scepter
|
||||
DESCRIPTION: None
|
||||
BASE_MODEL: SD_XL1.0
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/baby_dragon/
|
||||
IMAGE_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/baby_dragon/xl_baby_dragon.png
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/baby_dragon/
|
||||
IMAGE_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/baby_dragon/xl_baby_dragon.png
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: Warm Colors, Soft,Chinese Dragon Baby, Felt Style,Dragon Baby, Best Quality, 3D Doll, Macaron Tones, Glittering Big Eyes, Winter,Dragon
|
||||
- NAME: Sloppy-Dragon
|
||||
@@ -67,8 +76,8 @@ TUNERS:
|
||||
SOURCE: scepter
|
||||
DESCRIPTION: None
|
||||
BASE_MODEL: SD_XL1.0
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/sloppy_dragon/
|
||||
IMAGE_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/sloppy_dragon/xl_sloppy_dragon.png
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/sloppy_dragon/
|
||||
IMAGE_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/sloppy_dragon/xl_sloppy_dragon.png
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: Messy Chinese Dragon,Cute, Wu Guanzhong, Rough
|
||||
-
|
||||
@@ -77,8 +86,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/894f40ed44b37c3372e6a22b8ae577a4.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/Caricature
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/894f40ed44b37c3372e6a22b8ae577a4.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/Caricature
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -87,8 +96,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/894f40ed44b37c3372e6a22b8ae577a4.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/Caricature
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/894f40ed44b37c3372e6a22b8ae577a4.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/Caricature
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -97,8 +106,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/894f40ed44b37c3372e6a22b8ae577a4.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/Caricature
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/894f40ed44b37c3372e6a22b8ae577a4.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/Caricature
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -107,8 +116,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/80e5b4075c572c04cbb4e48c37b8366b.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/ColorFieldPainting
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/80e5b4075c572c04cbb4e48c37b8366b.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/ColorFieldPainting
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -117,8 +126,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/80e5b4075c572c04cbb4e48c37b8366b.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/ColorFieldPainting
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/80e5b4075c572c04cbb4e48c37b8366b.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/ColorFieldPainting
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -127,8 +136,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/80e5b4075c572c04cbb4e48c37b8366b.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/ColorFieldPainting
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/80e5b4075c572c04cbb4e48c37b8366b.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/ColorFieldPainting
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -137,8 +146,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/9ae235d7f1a7c2a4edab52a5e9f9cbae.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/ColoredPencilArt
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/9ae235d7f1a7c2a4edab52a5e9f9cbae.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/ColoredPencilArt
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -147,8 +156,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/9ae235d7f1a7c2a4edab52a5e9f9cbae.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/ColoredPencilArt
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/9ae235d7f1a7c2a4edab52a5e9f9cbae.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/ColoredPencilArt
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -157,8 +166,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/9ae235d7f1a7c2a4edab52a5e9f9cbae.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/ColoredPencilArt
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/9ae235d7f1a7c2a4edab52a5e9f9cbae.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/ColoredPencilArt
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -167,8 +176,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/3da915da2f5cedaf243e57e08163f35b.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/DarkMoodyAtmosphere
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/3da915da2f5cedaf243e57e08163f35b.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/DarkMoodyAtmosphere
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -177,8 +186,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/3da915da2f5cedaf243e57e08163f35b.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/DarkMoodyAtmosphere
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/3da915da2f5cedaf243e57e08163f35b.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/DarkMoodyAtmosphere
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -187,8 +196,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/3da915da2f5cedaf243e57e08163f35b.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/DarkMoodyAtmosphere
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/3da915da2f5cedaf243e57e08163f35b.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/DarkMoodyAtmosphere
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -197,8 +206,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/69fd81f5983107acc3d334af62915851.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/DrippingPaintSplatterArt
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/69fd81f5983107acc3d334af62915851.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/DrippingPaintSplatterArt
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -207,8 +216,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/69fd81f5983107acc3d334af62915851.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/DrippingPaintSplatterArt
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/69fd81f5983107acc3d334af62915851.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/DrippingPaintSplatterArt
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -217,8 +226,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/69fd81f5983107acc3d334af62915851.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/DrippingPaintSplatterArt
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/69fd81f5983107acc3d334af62915851.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/DrippingPaintSplatterArt
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -227,8 +236,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/f152edb4b3ca6248758b48115258ddfa.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/FadedPolaroidPhoto
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/f152edb4b3ca6248758b48115258ddfa.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/FadedPolaroidPhoto
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -237,8 +246,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/f152edb4b3ca6248758b48115258ddfa.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/FadedPolaroidPhoto
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/f152edb4b3ca6248758b48115258ddfa.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/FadedPolaroidPhoto
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -247,8 +256,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/f152edb4b3ca6248758b48115258ddfa.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/FadedPolaroidPhoto
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/f152edb4b3ca6248758b48115258ddfa.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/FadedPolaroidPhoto
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -257,8 +266,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/940cfd34155634cf051e1b2942cca426.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/Flat2DArt
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/940cfd34155634cf051e1b2942cca426.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/Flat2DArt
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -267,8 +276,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/940cfd34155634cf051e1b2942cca426.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/Flat2DArt
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/940cfd34155634cf051e1b2942cca426.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/Flat2DArt
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -277,8 +286,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/940cfd34155634cf051e1b2942cca426.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/Flat2DArt
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/940cfd34155634cf051e1b2942cca426.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/Flat2DArt
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -287,8 +296,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/57b751b11564cb22cd49ef21f2004a5f.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/GraffitiArt
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/57b751b11564cb22cd49ef21f2004a5f.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/GraffitiArt
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -297,8 +306,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/57b751b11564cb22cd49ef21f2004a5f.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/GraffitiArt
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/57b751b11564cb22cd49ef21f2004a5f.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/GraffitiArt
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -307,8 +316,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/57b751b11564cb22cd49ef21f2004a5f.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/GraffitiArt
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/57b751b11564cb22cd49ef21f2004a5f.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/GraffitiArt
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -317,8 +326,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/0312b673dc6858a9864d7f45f0c5c1fc.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/Impressionism
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/0312b673dc6858a9864d7f45f0c5c1fc.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/Impressionism
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -327,8 +336,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/0312b673dc6858a9864d7f45f0c5c1fc.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/Impressionism
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/0312b673dc6858a9864d7f45f0c5c1fc.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/Impressionism
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -337,8 +346,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/0312b673dc6858a9864d7f45f0c5c1fc.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/Impressionism
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/0312b673dc6858a9864d7f45f0c5c1fc.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/Impressionism
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -347,8 +356,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/9aa040b0c60d289da9610c91ad9b7c7e.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/LogoDesign
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/9aa040b0c60d289da9610c91ad9b7c7e.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/LogoDesign
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -357,8 +366,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/9aa040b0c60d289da9610c91ad9b7c7e.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/LogoDesign
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/9aa040b0c60d289da9610c91ad9b7c7e.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/LogoDesign
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -367,8 +376,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/9aa040b0c60d289da9610c91ad9b7c7e.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/LogoDesign
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/9aa040b0c60d289da9610c91ad9b7c7e.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/LogoDesign
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -377,8 +386,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/a9056e1eac85e5e4fe96a93917d4cce4.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/PencilSketchDrawing
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/a9056e1eac85e5e4fe96a93917d4cce4.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/PencilSketchDrawing
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -387,8 +396,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/a9056e1eac85e5e4fe96a93917d4cce4.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/PencilSketchDrawing
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/a9056e1eac85e5e4fe96a93917d4cce4.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/PencilSketchDrawing
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -397,8 +406,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/a9056e1eac85e5e4fe96a93917d4cce4.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/PencilSketchDrawing
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/a9056e1eac85e5e4fe96a93917d4cce4.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/PencilSketchDrawing
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -407,8 +416,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/568777f447fc02510b618152726d5002.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/SilhouetteArt
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/568777f447fc02510b618152726d5002.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/SilhouetteArt
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -417,8 +426,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/568777f447fc02510b618152726d5002.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/SilhouetteArt
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/568777f447fc02510b618152726d5002.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/SilhouetteArt
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -427,8 +436,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/568777f447fc02510b618152726d5002.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/SilhouetteArt
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/568777f447fc02510b618152726d5002.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/SilhouetteArt
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -437,8 +446,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/07d7b27cd73f2d43684003563511c15b.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/Steampunk2
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/07d7b27cd73f2d43684003563511c15b.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/Steampunk2
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -447,8 +456,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/07d7b27cd73f2d43684003563511c15b.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/Steampunk2
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/07d7b27cd73f2d43684003563511c15b.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/Steampunk2
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -457,8 +466,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/07d7b27cd73f2d43684003563511c15b.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/Steampunk2
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/07d7b27cd73f2d43684003563511c15b.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/Steampunk2
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -467,8 +476,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/2d1e9867058db2c57f2fe47530de3243.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/StickerDesigns
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/2d1e9867058db2c57f2fe47530de3243.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/StickerDesigns
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -477,8 +486,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/2d1e9867058db2c57f2fe47530de3243.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/StickerDesigns
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/2d1e9867058db2c57f2fe47530de3243.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/StickerDesigns
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -487,8 +496,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/2d1e9867058db2c57f2fe47530de3243.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/StickerDesigns
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/2d1e9867058db2c57f2fe47530de3243.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/StickerDesigns
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -497,8 +506,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/8859d532ae5901cc8457d6118fb9b7da.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/Watercolor2
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/8859d532ae5901cc8457d6118fb9b7da.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/Watercolor2
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -507,8 +516,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/8859d532ae5901cc8457d6118fb9b7da.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/Watercolor2
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/8859d532ae5901cc8457d6118fb9b7da.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/Watercolor2
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -517,8 +526,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: diva
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/8859d532ae5901cc8457d6118fb9b7da.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/Watercolor2
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/8859d532ae5901cc8457d6118fb9b7da.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/Watercolor2
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -527,8 +536,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: mre
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/5895d78cf58c1ca05178991f37cc48ff.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/mre-elemental-art
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/5895d78cf58c1ca05178991f37cc48ff.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/mre-elemental-art
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -537,8 +546,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: mre
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/5895d78cf58c1ca05178991f37cc48ff.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/mre-elemental-art
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/5895d78cf58c1ca05178991f37cc48ff.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/mre-elemental-art
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -547,8 +556,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: mre
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/5895d78cf58c1ca05178991f37cc48ff.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/mre-elemental-art
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/5895d78cf58c1ca05178991f37cc48ff.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/mre-elemental-art
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -557,8 +566,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: mre
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/a08149bc8e50f6bc65c0010d4cd416f8.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/mre-anime
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/a08149bc8e50f6bc65c0010d4cd416f8.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/mre-anime
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -567,8 +576,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: mre
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/a08149bc8e50f6bc65c0010d4cd416f8.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/mre-anime
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/a08149bc8e50f6bc65c0010d4cd416f8.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/mre-anime
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -577,8 +586,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: mre
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/a08149bc8e50f6bc65c0010d4cd416f8.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/mre-anime
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/a08149bc8e50f6bc65c0010d4cd416f8.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/mre-anime
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -587,8 +596,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: mre
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/48c65cebf1fa4284d7b8feb619412e65.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/mre-comic
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/48c65cebf1fa4284d7b8feb619412e65.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/mre-comic
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -597,8 +606,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: mre
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/48c65cebf1fa4284d7b8feb619412e65.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/mre-comic
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/48c65cebf1fa4284d7b8feb619412e65.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/mre-comic
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -607,8 +616,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: mre
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/48c65cebf1fa4284d7b8feb619412e65.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/mre-comic
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/48c65cebf1fa4284d7b8feb619412e65.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/mre-comic
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -617,8 +626,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/8fc51113f725f27326c4398a7457cd6d.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/sai-craftclay
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/8fc51113f725f27326c4398a7457cd6d.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/sai-craftclay
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -627,8 +636,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/8fc51113f725f27326c4398a7457cd6d.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/sai-craftclay
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/8fc51113f725f27326c4398a7457cd6d.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/sai-craftclay
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -637,8 +646,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/8fc51113f725f27326c4398a7457cd6d.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/sai-craftclay
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/8fc51113f725f27326c4398a7457cd6d.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/sai-craftclay
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -647,8 +656,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/a6f8d92afcd5803dfb2ebecbc92091b6.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/sai-fantasyart
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/a6f8d92afcd5803dfb2ebecbc92091b6.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/sai-fantasyart
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -657,8 +666,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/a6f8d92afcd5803dfb2ebecbc92091b6.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/sai-fantasyart
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/a6f8d92afcd5803dfb2ebecbc92091b6.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/sai-fantasyart
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -667,8 +676,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/a6f8d92afcd5803dfb2ebecbc92091b6.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/sai-fantasyart
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/a6f8d92afcd5803dfb2ebecbc92091b6.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/sai-fantasyart
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -677,8 +686,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/034a51b0dd34b018be8859bf45b4f7ed.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/sai-lineart
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/034a51b0dd34b018be8859bf45b4f7ed.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/sai-lineart
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -687,8 +696,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/034a51b0dd34b018be8859bf45b4f7ed.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/sai-lineart
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/034a51b0dd34b018be8859bf45b4f7ed.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/sai-lineart
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -697,8 +706,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/034a51b0dd34b018be8859bf45b4f7ed.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/sai-lineart
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/034a51b0dd34b018be8859bf45b4f7ed.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/sai-lineart
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -707,8 +716,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/7e9ed25bb34008beb5f417df63c4b2fe.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/sai-neonpunk
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/7e9ed25bb34008beb5f417df63c4b2fe.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/sai-neonpunk
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -717,8 +726,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/7e9ed25bb34008beb5f417df63c4b2fe.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/sai-neonpunk
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/7e9ed25bb34008beb5f417df63c4b2fe.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/sai-neonpunk
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -727,8 +736,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/7e9ed25bb34008beb5f417df63c4b2fe.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/sai-neonpunk
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/7e9ed25bb34008beb5f417df63c4b2fe.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/sai-neonpunk
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -737,8 +746,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/924f46a8f276011a0953d7988e90ee25.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/sai-origami
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/924f46a8f276011a0953d7988e90ee25.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/sai-origami
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -747,8 +756,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/924f46a8f276011a0953d7988e90ee25.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/sai-origami
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/924f46a8f276011a0953d7988e90ee25.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/sai-origami
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -757,8 +766,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/924f46a8f276011a0953d7988e90ee25.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/sai-origami
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/924f46a8f276011a0953d7988e90ee25.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/sai-origami
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -767,8 +776,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD_XL1.0
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD_XL1.0/a5ab89c0960be8c1216e65c98d92ae4a.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD_XL1.0/sai-pixelart
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD_XL1.0/a5ab89c0960be8c1216e65c98d92ae4a.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD_XL1.0/sai-pixelart
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -777,8 +786,8 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD2.1
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD2.1/a5ab89c0960be8c1216e65c98d92ae4a.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD2.1/sai-pixelart
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD2.1/a5ab89c0960be8c1216e65c98d92ae4a.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD2.1/sai-pixelart
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
-
|
||||
@@ -787,7 +796,7 @@ TUNERS:
|
||||
DESCRIPTION:
|
||||
SOURCE: sai
|
||||
BASE_MODEL: SD1.5
|
||||
IMAGE_PATH: ms://damo/scepter@mantra_images/SD1.5/a5ab89c0960be8c1216e65c98d92ae4a.png
|
||||
MODEL_PATH: ms://damo/scepter_scedit@tuners_model/SD1.5/sai-pixelart
|
||||
IMAGE_PATH: ms://iic/scepter@mantra_images_jpg/SD1.5/a5ab89c0960be8c1216e65c98d92ae4a.jpg
|
||||
MODEL_PATH: ms://iic/scepter_scedit@tuners_model/SD1.5/sai-pixelart
|
||||
TUNER_TYPE: SwiftSCE
|
||||
PROMPT_EXAMPLE: a boy wearing green jacket
|
||||
|
||||
@@ -10,7 +10,7 @@ DESC_INFO:
|
||||
<table align="center">
|
||||
<tr>
|
||||
<td>
|
||||
<img src="https://modelscope.cn/api/v1/models/damo/scepter/repo?Revision=master&FilePath=assets/scepter_studio/scepter_studio_banner.jpg">
|
||||
<img src="https://modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=assets/scepter_studio/scepter_studio_banner.jpg">
|
||||
<h3><center>SCEPTER Studio是基于开源基模型和自研微调编辑算法构建的生成定制和编辑工具箱,提供围绕生成、微调、编辑、数据处理等一系列的工具和插件。</center><h3>
|
||||
</td>
|
||||
</tr>
|
||||
@@ -22,7 +22,7 @@ DESC_INFO:
|
||||
<table align="center">
|
||||
<tr>
|
||||
<td>
|
||||
<img src="https://modelscope.cn/api/v1/models/damo/scepter/repo?Revision=master&FilePath=assets/scepter_studio/scepter_studio_banner.jpg">
|
||||
<img src="https://modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=assets/scepter_studio/scepter_studio_banner.jpg">
|
||||
<h3><center>SCEPTER Studio is a customized generation and editing toolkit built on the open-source base models and proprietary fine-tuning editing algorithms, offering a range of tools and plugins centered around generation, fine-tuning, editing, and data processing.</center><h3>
|
||||
</td>
|
||||
</tr>
|
||||
|
||||
@@ -0,0 +1,151 @@
|
||||
NAME: COGVIDEOX_2B
|
||||
IS_DEFAULT: False
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
RESOLUTIONS: [[480, 720]]
|
||||
INPUT:
|
||||
IMAGE:
|
||||
ORIGINAL_SIZE_AS_TUPLE: [480, 720]
|
||||
TARGET_SIZE_AS_TUPLE: [480, 720]
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT: ""
|
||||
PROMPT_PREFIX: ""
|
||||
SAMPLE: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
GUIDE_SCALE: 6.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
DISCRETIZATION: trailing
|
||||
NUM_FRAMES:
|
||||
DEFAULT: 49
|
||||
VISIBLE: True
|
||||
FPS:
|
||||
DEFAULT: 8
|
||||
VISIBLE: True
|
||||
OUTPUT:
|
||||
VIDEOS:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: decode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["LATENT"]
|
||||
PARAS:
|
||||
SCALING_FACTOR_IMAGE: 1.15258426
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: forward
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE", "GUIDE_RESCALE", "DISCRETIZATION", "NUM_FRAMES", "FPS"]
|
||||
PARAS:
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: False
|
||||
PATCH_SIZE: 2
|
||||
LATENT_CHANNELS: 16
|
||||
SCALE_FACTOR_SPATIAL: 8
|
||||
SCALE_FACTOR_TEMPORAL: 4
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: encode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["PROMPT"]
|
||||
#
|
||||
MODEL:
|
||||
PRETRAINED_MODEL:
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: v
|
||||
NOISE_SCHEDULER:
|
||||
NAME: ScaledLinearScheduler
|
||||
BETA_MIN: 0.00085
|
||||
BETA_MAX: 0.012
|
||||
SNR_SHIFT_SCALE: 3.0
|
||||
RESCALE_BETAS_ZERO_SNR: True
|
||||
DIFFUSION_SAMPLERS:
|
||||
NAME: DDIMSampler
|
||||
DISCRETIZATION_TYPE: trailing
|
||||
ETA: 0.0
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: CogVideoXTransformer3DModel
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-2b@transformer/diffusion_pytorch_model.safetensors
|
||||
NUM_ATTENTION_HEADS: 30
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 16
|
||||
FLIP_SIN_TO_COS: True
|
||||
FREQ_SHIFT: 0
|
||||
TIME_EMBED_DIM: 512
|
||||
TEXT_EMBED_DIM: 4096
|
||||
NUM_LAYERS: 30
|
||||
DROPOUT: 0.0
|
||||
ATTENTION_BIAS: True
|
||||
SAMPLE_WIDTH: 90
|
||||
SAMPLE_HEIGHT: 60
|
||||
SAMPLE_FRAMES: 49
|
||||
PATCH_SIZE: 2
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
MAX_TEXT_SEQ_LENGTH: 226
|
||||
ACTIVATION_FN: "gelu-approximate"
|
||||
TIMESTEP_ACTIVATION_FN: "silu"
|
||||
NORM_ELEMENTWISE_AFFINE: True
|
||||
NORM_EPS: 1e-5
|
||||
SPATIAL_INTERPOLATION_SCALE: 1.875
|
||||
TEMPORAL_INTERPOLATION_SCALE: 1.0
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: False
|
||||
USE_LEARNED_POSITIONAL_EMBEDDINGS: False
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-2b@vae/diffusion_pytorch_model.safetensors
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
LENGTH: 226
|
||||
CLEAN:
|
||||
USE_GRAD: False
|
||||
@@ -0,0 +1,153 @@
|
||||
NAME: COGVIDEOX_5B
|
||||
IS_DEFAULT: False
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
RESOLUTIONS: [[480, 720]]
|
||||
INPUT:
|
||||
IMAGE:
|
||||
ORIGINAL_SIZE_AS_TUPLE: [480, 720]
|
||||
TARGET_SIZE_AS_TUPLE: [480, 720]
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT: ""
|
||||
PROMPT_PREFIX: ""
|
||||
SAMPLE: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
GUIDE_SCALE: 6.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
DISCRETIZATION: trailing
|
||||
NUM_FRAMES:
|
||||
DEFAULT: 49
|
||||
VISIBLE: True
|
||||
FPS:
|
||||
DEFAULT: 8
|
||||
VISIBLE: True
|
||||
OUTPUT:
|
||||
VIDEOS:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: decode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["LATENT"]
|
||||
PARAS:
|
||||
SCALING_FACTOR_IMAGE: 0.7 # 5b diff
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: forward
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE", "GUIDE_RESCALE", "DISCRETIZATION", "NUM_FRAMES", "FPS"]
|
||||
PARAS:
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: True
|
||||
PATCH_SIZE: 2
|
||||
LATENT_CHANNELS: 16
|
||||
SCALE_FACTOR_SPATIAL: 8
|
||||
SCALE_FACTOR_TEMPORAL: 4
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: encode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["PROMPT"]
|
||||
#
|
||||
MODEL:
|
||||
PRETRAINED_MODEL:
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: v
|
||||
NOISE_SCHEDULER:
|
||||
NAME: ScaledLinearScheduler
|
||||
BETA_MIN: 0.00085
|
||||
BETA_MAX: 0.012
|
||||
SNR_SHIFT_SCALE: 1.0 # 5b diff
|
||||
RESCALE_BETAS_ZERO_SNR: True
|
||||
DIFFUSION_SAMPLERS:
|
||||
NAME: DDIMSampler
|
||||
DISCRETIZATION_TYPE: trailing
|
||||
ETA: 0.0
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: CogVideoXTransformer3DModel
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: # 5b diff
|
||||
- ms://AI-ModelScope/CogVideoX-5b@transformer/diffusion_pytorch_model-00001-of-00002.safetensors
|
||||
- ms://AI-ModelScope/CogVideoX-5b@transformer/diffusion_pytorch_model-00002-of-00002.safetensors
|
||||
NUM_ATTENTION_HEADS: 48 # 5b diff
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 16
|
||||
FLIP_SIN_TO_COS: True
|
||||
FREQ_SHIFT: 0
|
||||
TIME_EMBED_DIM: 512
|
||||
TEXT_EMBED_DIM: 4096
|
||||
NUM_LAYERS: 42 # 5b diff
|
||||
DROPOUT: 0.0
|
||||
ATTENTION_BIAS: True
|
||||
SAMPLE_WIDTH: 90
|
||||
SAMPLE_HEIGHT: 60
|
||||
SAMPLE_FRAMES: 49
|
||||
PATCH_SIZE: 2
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
MAX_TEXT_SEQ_LENGTH: 226
|
||||
ACTIVATION_FN: "gelu-approximate"
|
||||
TIMESTEP_ACTIVATION_FN: "silu"
|
||||
NORM_ELEMENTWISE_AFFINE: True
|
||||
NORM_EPS: 1e-5
|
||||
SPATIAL_INTERPOLATION_SCALE: 1.875
|
||||
TEMPORAL_INTERPOLATION_SCALE: 1.0
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: True # 5b diff
|
||||
USE_LEARNED_POSITIONAL_EMBEDDINGS: False
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-5b@vae/diffusion_pytorch_model.safetensors # 5b diff
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
LENGTH: 226
|
||||
CLEAN:
|
||||
USE_GRAD: False
|
||||
@@ -0,0 +1,201 @@
|
||||
NAME: FLUX1.0_DEV
|
||||
IS_DEFAULT: False
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
RESOLUTIONS: [[1024, 1024]]
|
||||
INPUT:
|
||||
IMAGE:
|
||||
ORIGINAL_SIZE_AS_TUPLE: [1024, 1024]
|
||||
TARGET_SIZE_AS_TUPLE: [1024, 1024]
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT:
|
||||
DEFAULT: ""
|
||||
VISIBLE: False
|
||||
PROMPT_PREFIX: ""
|
||||
SAMPLE:
|
||||
VALUES: ["flow_euler"]
|
||||
DEFAULT: "flow_euler"
|
||||
SAMPLE_STEPS: 50
|
||||
GUIDE_SCALE: 3.5
|
||||
GUIDE_RESCALE:
|
||||
DEFAULT: 0.0
|
||||
VISIBLE: False
|
||||
DISCRETIZATION:
|
||||
VALUES: []
|
||||
DEFAULT:
|
||||
VISIBLE: False
|
||||
OUTPUT:
|
||||
LATENT:
|
||||
IMAGES:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: encode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["IMAGE"]
|
||||
-
|
||||
NAME: decode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["LATENT"]
|
||||
PARAS:
|
||||
SCALE_FACTOR: 1.5305
|
||||
SHIFT_FACTOR: 0.0609
|
||||
SIZE_FACTOR: 8
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: forward
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE"]
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: encode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["PROMPT"]
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionFlux
|
||||
PARAMETERIZATION: rf
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA:
|
||||
ZERO_TERMINAL_SNR: False
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
# NAME DESCRIPTION: TYPE: default: 'DiffusionFluxRF'
|
||||
NAME: DiffusionFluxRF
|
||||
PREDICTION_TYPE: raw
|
||||
# NOISE_SCHEDULER DESCRIPTION: TYPE: default: ''
|
||||
NOISE_SCHEDULER:
|
||||
# NAME DESCRIPTION: TYPE: default: 'FlowMatchSigmaScheduler'
|
||||
NAME: FlowMatchSigmaScheduler
|
||||
# WEIGHTING_SCHEME DESCRIPTION: The weighting scheme for sampling timesteps, choose from ['sigma_sqrt', 'logit_normal', 'mode', 'cosmap', 'none']. TYPE: str default: 'logit_normal'
|
||||
WEIGHTING_SCHEME: logit_normal
|
||||
SHIFT: 3.0
|
||||
# LOGIT_MEAN DESCRIPTION: The mean of the logit distribution for sampling timesteps. TYPE: float default: 0.0
|
||||
LOGIT_MEAN: 0.0
|
||||
# LOGIT_STD DESCRIPTION: The standard deviation of the logit distribution for sampling timesteps. TYPE: float default: 1.0
|
||||
LOGIT_STD: 1.0
|
||||
# MODE_SCALE DESCRIPTION: The scale factor for the mode of the logit distribution for sampling timesteps. TYPE: float default: 1.29
|
||||
MODE_SCALE: 1.29
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'Flux'
|
||||
NAME: Flux
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-dev@flux1-dev.safetensors
|
||||
# IN_CHANNELS DESCRIPTION: model's input channels. TYPE: int default: 64
|
||||
IN_CHANNELS: 64
|
||||
# HIDDEN_SIZE DESCRIPTION: model's hidden size. TYPE: int default: 1024
|
||||
HIDDEN_SIZE: 3072
|
||||
# NUM_HEADS DESCRIPTION: number of heads in the transformer. TYPE: int default: 16
|
||||
NUM_HEADS: 24
|
||||
# AXES_DIM DESCRIPTION: dimensions of the axes of the positional encoding. TYPE: list default: [16, 56, 56]
|
||||
AXES_DIM: [ 16, 56, 56 ]
|
||||
# THETA DESCRIPTION: theta for positional encoding. TYPE: int default: 10000
|
||||
THETA: 10000
|
||||
# VEC_IN_DIM DESCRIPTION: dimension of the vector input. TYPE: int default: 768
|
||||
VEC_IN_DIM: 768
|
||||
# GUIDANCE_EMBED DESCRIPTION: whether to use guidance embedding. TYPE: bool default: False
|
||||
GUIDANCE_EMBED: True
|
||||
# CONTEXT_IN_DIM DESCRIPTION: dimension of the context input. TYPE: int default: 4096
|
||||
CONTEXT_IN_DIM: 4096
|
||||
# MLP_RATIO DESCRIPTION: ratio of mlp hidden size to hidden size. TYPE: float default: 4.0
|
||||
MLP_RATIO: 4.0
|
||||
# QKV_BIAS DESCRIPTION: whether to use bias in qkv projection. TYPE: bool default: True
|
||||
QKV_BIAS: True
|
||||
# DEPTH DESCRIPTION: number of transformer blocks. TYPE: int default: 19
|
||||
DEPTH: 19
|
||||
# DEPTH_SINGLE_BLOCKS DESCRIPTION: number of transformer blocks in the single stream block. TYPE: int default: 38
|
||||
DEPTH_SINGLE_BLOCKS: 38
|
||||
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLFlux
|
||||
EMBED_DIM: 16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-dev@ae.safetensors
|
||||
IGNORE_KEYS: [ ]
|
||||
BATCH_SIZE: 8
|
||||
USE_CONV: False
|
||||
SCALE_FACTOR: 0.3611
|
||||
SHIFT_FACTOR: 0.1159
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'T5PlusClipFluxEmbedder'
|
||||
NAME: T5PlusClipFluxEmbedder
|
||||
# T5_MODEL DESCRIPTION: TYPE: default: ''
|
||||
T5_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'HFEmbedder'
|
||||
NAME: HFEmbedder
|
||||
# HF_MODEL_CLS DESCRIPTION: huggingface cls in transfomer TYPE: NoneType default: None
|
||||
HF_MODEL_CLS: T5EncoderModel
|
||||
# MODEL_PATH DESCRIPTION: model folder path TYPE: NoneType default: None
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-dev@text_encoder_2/
|
||||
# HF_TOKENIZER_CLS DESCRIPTION: huggingface cls in transfomer TYPE: NoneType default: None
|
||||
HF_TOKENIZER_CLS: T5Tokenizer
|
||||
# TOKENIZER_PATH DESCRIPTION: tokenizer folder path TYPE: NoneType default: None
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-dev@tokenizer_2/
|
||||
# MAX_LENGTH DESCRIPTION: max length of input TYPE: int default: 77
|
||||
MAX_LENGTH: 512
|
||||
# OUTPUT_KEY DESCRIPTION: output key TYPE: str default: 'last_hidden_state'
|
||||
OUTPUT_KEY: last_hidden_state
|
||||
# D_TYPE DESCRIPTION: dtype TYPE: str default: 'bfloat16'
|
||||
D_TYPE: bfloat16
|
||||
# BATCH_INFER DESCRIPTION: batch infer TYPE: bool default: False
|
||||
BATCH_INFER: False
|
||||
CLEAN: whitespace
|
||||
# CLIP_MODEL DESCRIPTION: TYPE: default: ''
|
||||
CLIP_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'HFEmbedder'
|
||||
NAME: HFEmbedder
|
||||
# HF_MODEL_CLS DESCRIPTION: huggingface cls in transfomer TYPE: NoneType default: None
|
||||
HF_MODEL_CLS: CLIPTextModel
|
||||
# MODEL_PATH DESCRIPTION: model folder path TYPE: NoneType default: None
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-dev@text_encoder/
|
||||
# HF_TOKENIZER_CLS DESCRIPTION: huggingface cls in transfomer TYPE: NoneType default: None
|
||||
HF_TOKENIZER_CLS: CLIPTokenizer
|
||||
# TOKENIZER_PATH DESCRIPTION: tokenizer folder path TYPE: NoneType default: None
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-dev@tokenizer/
|
||||
# MAX_LENGTH DESCRIPTION: max length of input TYPE: int default: 77
|
||||
MAX_LENGTH: 77
|
||||
# OUTPUT_KEY DESCRIPTION: output key TYPE: str default: 'last_hidden_state'
|
||||
OUTPUT_KEY: pooler_output
|
||||
# D_TYPE DESCRIPTION: dtype TYPE: str default: 'bfloat16'
|
||||
D_TYPE: bfloat16
|
||||
# BATCH_INFER DESCRIPTION: batch infer TYPE: bool default: False
|
||||
BATCH_INFER: True
|
||||
CLEAN: whitespace
|
||||
@@ -0,0 +1,212 @@
|
||||
NAME: FLUX1.0_SCHNELL
|
||||
IS_DEFAULT: False
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
RESOLUTIONS: [[1024, 1024]]
|
||||
INPUT:
|
||||
IMAGE:
|
||||
ORIGINAL_SIZE_AS_TUPLE: [1024, 1024]
|
||||
TARGET_SIZE_AS_TUPLE: [1024, 1024]
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT:
|
||||
DEFAULT: ""
|
||||
VISIBLE: False
|
||||
PROMPT_PREFIX: ""
|
||||
SAMPLE:
|
||||
VALUES: ["flow_euler"]
|
||||
DEFAULT: "flow_euler"
|
||||
SAMPLE_STEPS: 4
|
||||
GUIDE_SCALE: 3.5
|
||||
GUIDE_RESCALE:
|
||||
DEFAULT: 0.0
|
||||
VISIBLE: False
|
||||
DISCRETIZATION:
|
||||
VALUES: []
|
||||
DEFAULT:
|
||||
VISIBLE: False
|
||||
OUTPUT:
|
||||
LATENT:
|
||||
IMAGES:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: encode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["IMAGE"]
|
||||
-
|
||||
NAME: decode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["LATENT"]
|
||||
PARAS:
|
||||
SCALE_FACTOR: 1.5305
|
||||
SHIFT_FACTOR: 0.0609
|
||||
SIZE_FACTOR: 8
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: forward
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE"]
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: encode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["PROMPT"]
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionFlux
|
||||
PARAMETERIZATION: rf
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA:
|
||||
ZERO_TERMINAL_SNR: False
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
# NAME DESCRIPTION: TYPE: default: 'DiffusionFluxRF'
|
||||
NAME: DiffusionFluxRF
|
||||
PREDICTION_TYPE: raw
|
||||
# NOISE_SCHEDULER DESCRIPTION: TYPE: default: ''
|
||||
NOISE_SCHEDULER:
|
||||
# NAME DESCRIPTION: TYPE: default: 'FlowMatchSigmaScheduler'
|
||||
NAME: FlowMatchSigmaScheduler
|
||||
# WEIGHTING_SCHEME DESCRIPTION: The weighting scheme for sampling timesteps, choose from ['sigma_sqrt', 'logit_normal', 'mode', 'cosmap', 'none']. TYPE: str default: 'logit_normal'
|
||||
WEIGHTING_SCHEME: logit_normal
|
||||
SHIFT: 3.0
|
||||
# LOGIT_MEAN DESCRIPTION: The mean of the logit distribution for sampling timesteps. TYPE: float default: 0.0
|
||||
LOGIT_MEAN: 0.0
|
||||
# LOGIT_STD DESCRIPTION: The standard deviation of the logit distribution for sampling timesteps. TYPE: float default: 1.0
|
||||
LOGIT_STD: 1.0
|
||||
# MODE_SCALE DESCRIPTION: The scale factor for the mode of the logit distribution for sampling timesteps. TYPE: float default: 1.29
|
||||
MODE_SCALE: 1.29
|
||||
SAMPLER_SCHEDULER:
|
||||
# NAME DESCRIPTION: TYPE: default: 'FlowMatchFluxShiftScheduler'
|
||||
NAME: FlowMatchFluxShiftScheduler
|
||||
# SHIFT DESCRIPTION: Use timestamp shift or not, default is True. TYPE: bool default: True
|
||||
SHIFT: False
|
||||
# SIGMOID_SCALE DESCRIPTION: The scale of sigmoid function for sampling timesteps. TYPE: int default: 1
|
||||
SIGMOID_SCALE: 1
|
||||
# BASE_SHIFT DESCRIPTION: The base shift factor for the timestamp. TYPE: float default: 0.5
|
||||
BASE_SHIFT: 0.5
|
||||
# MAX_SHIFT DESCRIPTION: The max shift factor for the timestamp. TYPE: float default: 1.15
|
||||
MAX_SHIFT: 1.15
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'Flux'
|
||||
NAME: Flux
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-schnell@flux1-schnell.safetensors
|
||||
# IN_CHANNELS DESCRIPTION: model's input channels. TYPE: int default: 64
|
||||
IN_CHANNELS: 64
|
||||
# HIDDEN_SIZE DESCRIPTION: model's hidden size. TYPE: int default: 1024
|
||||
HIDDEN_SIZE: 3072
|
||||
# NUM_HEADS DESCRIPTION: number of heads in the transformer. TYPE: int default: 16
|
||||
NUM_HEADS: 24
|
||||
# AXES_DIM DESCRIPTION: dimensions of the axes of the positional encoding. TYPE: list default: [16, 56, 56]
|
||||
AXES_DIM: [ 16, 56, 56 ]
|
||||
# THETA DESCRIPTION: theta for positional encoding. TYPE: int default: 10000
|
||||
THETA: 10000
|
||||
# VEC_IN_DIM DESCRIPTION: dimension of the vector input. TYPE: int default: 768
|
||||
VEC_IN_DIM: 768
|
||||
# GUIDANCE_EMBED DESCRIPTION: whether to use guidance embedding. TYPE: bool default: False
|
||||
GUIDANCE_EMBED: False
|
||||
# CONTEXT_IN_DIM DESCRIPTION: dimension of the context input. TYPE: int default: 4096
|
||||
CONTEXT_IN_DIM: 4096
|
||||
# MLP_RATIO DESCRIPTION: ratio of mlp hidden size to hidden size. TYPE: float default: 4.0
|
||||
MLP_RATIO: 4.0
|
||||
# QKV_BIAS DESCRIPTION: whether to use bias in qkv projection. TYPE: bool default: True
|
||||
QKV_BIAS: True
|
||||
# DEPTH DESCRIPTION: number of transformer blocks. TYPE: int default: 19
|
||||
DEPTH: 19
|
||||
# DEPTH_SINGLE_BLOCKS DESCRIPTION: number of transformer blocks in the single stream block. TYPE: int default: 38
|
||||
DEPTH_SINGLE_BLOCKS: 38
|
||||
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLFlux
|
||||
EMBED_DIM: 16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-schnell@ae.safetensors
|
||||
IGNORE_KEYS: [ ]
|
||||
BATCH_SIZE: 8
|
||||
USE_CONV: False
|
||||
SCALE_FACTOR: 0.3611
|
||||
SHIFT_FACTOR: 0.1159
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'T5PlusClipFluxEmbedder'
|
||||
NAME: T5PlusClipFluxEmbedder
|
||||
# T5_MODEL DESCRIPTION: TYPE: default: ''
|
||||
T5_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'HFEmbedder'
|
||||
NAME: HFEmbedder
|
||||
# HF_MODEL_CLS DESCRIPTION: huggingface cls in transfomer TYPE: NoneType default: None
|
||||
HF_MODEL_CLS: T5EncoderModel
|
||||
# MODEL_PATH DESCRIPTION: model folder path TYPE: NoneType default: None
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-schnell@text_encoder_2/
|
||||
# HF_TOKENIZER_CLS DESCRIPTION: huggingface cls in transfomer TYPE: NoneType default: None
|
||||
HF_TOKENIZER_CLS: T5Tokenizer
|
||||
# TOKENIZER_PATH DESCRIPTION: tokenizer folder path TYPE: NoneType default: None
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-schnell@tokenizer_2/
|
||||
# MAX_LENGTH DESCRIPTION: max length of input TYPE: int default: 77
|
||||
MAX_LENGTH: 256
|
||||
# OUTPUT_KEY DESCRIPTION: output key TYPE: str default: 'last_hidden_state'
|
||||
OUTPUT_KEY: last_hidden_state
|
||||
# D_TYPE DESCRIPTION: dtype TYPE: str default: 'bfloat16'
|
||||
D_TYPE: bfloat16
|
||||
# BATCH_INFER DESCRIPTION: batch infer TYPE: bool default: False
|
||||
BATCH_INFER: False
|
||||
CLEAN: whitespace
|
||||
# CLIP_MODEL DESCRIPTION: TYPE: default: ''
|
||||
CLIP_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'HFEmbedder'
|
||||
NAME: HFEmbedder
|
||||
# HF_MODEL_CLS DESCRIPTION: huggingface cls in transfomer TYPE: NoneType default: None
|
||||
HF_MODEL_CLS: CLIPTextModel
|
||||
# MODEL_PATH DESCRIPTION: model folder path TYPE: NoneType default: None
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-schnell@text_encoder/
|
||||
# HF_TOKENIZER_CLS DESCRIPTION: huggingface cls in transfomer TYPE: NoneType default: None
|
||||
HF_TOKENIZER_CLS: CLIPTokenizer
|
||||
# TOKENIZER_PATH DESCRIPTION: tokenizer folder path TYPE: NoneType default: None
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-schnell@tokenizer/
|
||||
# MAX_LENGTH DESCRIPTION: max length of input TYPE: int default: 77
|
||||
MAX_LENGTH: 77
|
||||
# OUTPUT_KEY DESCRIPTION: output key TYPE: str default: 'last_hidden_state'
|
||||
OUTPUT_KEY: pooler_output
|
||||
# D_TYPE DESCRIPTION: dtype TYPE: str default: 'bfloat16'
|
||||
D_TYPE: bfloat16
|
||||
# BATCH_INFER DESCRIPTION: batch infer TYPE: bool default: False
|
||||
BATCH_INFER: True
|
||||
CLEAN: whitespace
|
||||
@@ -0,0 +1,120 @@
|
||||
NAME: PIXART_ALPHA
|
||||
IS_DEFAULT: False
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
RESOLUTIONS: [[1024, 1024]]
|
||||
INPUT:
|
||||
IMAGE:
|
||||
ORIGINAL_SIZE_AS_TUPLE: [1024, 1024]
|
||||
TARGET_SIZE_AS_TUPLE: [1024, 1024]
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT: ""
|
||||
PROMPT_PREFIX: ""
|
||||
SAMPLE: ddim
|
||||
SAMPLE_STEPS: 20
|
||||
GUIDE_SCALE: 4.5
|
||||
GUIDE_RESCALE: 0.5
|
||||
DISCRETIZATION: trailing
|
||||
OUTPUT:
|
||||
LATENT:
|
||||
IMAGES:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: encode
|
||||
DTYPE: float32
|
||||
INPUT: ["IMAGE"]
|
||||
-
|
||||
NAME: decode
|
||||
DTYPE: float32
|
||||
INPUT: ["LATENT"]
|
||||
PARAS:
|
||||
SCALE_FACTOR: 0.18215
|
||||
SIZE_FACTOR: 8
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: forward
|
||||
DTYPE: float16
|
||||
INPUT: ["SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE", "GUIDE_RESCALE", "DISCRETIZATION"]
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: encode
|
||||
DTYPE: float32
|
||||
INPUT: ["PROMPT"]
|
||||
#
|
||||
MODEL:
|
||||
PRETRAINED_MODEL:
|
||||
DECODER_BIAS: 0.5
|
||||
SCHEDULE:
|
||||
PARAMETERIZATION: "eps"
|
||||
TIMESTEPS: 1000
|
||||
ZERO_TERMINAL_SNR: False
|
||||
SCHEDULE_ARGS:
|
||||
"NAME": "linear"
|
||||
"BETA_MIN": 0.0001
|
||||
"BETA_MAX": 0.02
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: PixArt
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/PixArt-alpha@PixArt-XL-2-1024-MS.pth
|
||||
INPUT_SIZE: 128
|
||||
PATCH_SIZE: 2
|
||||
IN_CHANNELS: 4
|
||||
HIDDEN_SIZE: 1152
|
||||
DEPTH: 28
|
||||
NUM_HEADS: 16
|
||||
MLP_RATIO: 4.0
|
||||
CLASS_DROPOUT_PROB: 0.1
|
||||
PRED_SIGMA: True
|
||||
DROP_PATH: 0.0
|
||||
WINDOW_DIZE: 0
|
||||
USE_REL_POS: False
|
||||
CAPTION_CHANNELS: 4096
|
||||
LEWEI_SCALE: 2
|
||||
MODEL_MAX_LENGTH: 120
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKL
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-2-base@512-base-ema.safetensors
|
||||
EMBED_DIM: 4
|
||||
IGNORE_KEYS: [ ]
|
||||
BATCH_SIZE: 1
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/PixArt-alpha@t5-v1_1-xxl/
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/PixArt-alpha@t5-v1_1-xxl/
|
||||
LENGTH: 120
|
||||
CLEAN: heavy
|
||||
USE_GRAD: False
|
||||
@@ -0,0 +1,148 @@
|
||||
NAME: SD3
|
||||
IS_DEFAULT: False
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
RESOLUTIONS: [[1024, 1024]]
|
||||
INPUT:
|
||||
IMAGE:
|
||||
ORIGINAL_SIZE_AS_TUPLE: [1024, 1024]
|
||||
TARGET_SIZE_AS_TUPLE: [1024, 1024]
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT: ""
|
||||
PROMPT_PREFIX: ""
|
||||
SAMPLE: euler
|
||||
SAMPLE_STEPS: 28
|
||||
GUIDE_SCALE: 5.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
DISCRETIZATION: trailing
|
||||
OUTPUT:
|
||||
LATENT:
|
||||
IMAGES:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: encode
|
||||
DTYPE: float32
|
||||
INPUT: ["IMAGE"]
|
||||
-
|
||||
NAME: decode
|
||||
DTYPE: float32
|
||||
INPUT: ["LATENT"]
|
||||
PARAS:
|
||||
SCALE_FACTOR: 1.5305
|
||||
SHIFT_FACTOR: 0.0609
|
||||
SIZE_FACTOR: 8
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: forward
|
||||
DTYPE: float16
|
||||
INPUT: ["SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE", "GUIDE_RESCALE", "DISCRETIZATION"]
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: encode
|
||||
DTYPE: float32
|
||||
INPUT: ["PROMPT"]
|
||||
#
|
||||
MODEL:
|
||||
PRETRAINED_MODEL:
|
||||
SCHEDULE:
|
||||
PARAMETERIZATION: rf
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA:
|
||||
ZERO_TERMINAL_SNR: False
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
SCALE_FACTOR: 1.5305
|
||||
SHIFT_FACTOR: 0.0609
|
||||
DEFAULT_N_PROMPT:
|
||||
SCHEDULE_ARGS:
|
||||
"NAME": "shifted"
|
||||
"SHIFT": 3
|
||||
T_WEIGHT: uniform
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: MMDiT
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-3-medium@sd3_medium.safetensors
|
||||
IGNORE_KEYS: '^first_stage_model.'
|
||||
IN_CHANNELS: 16
|
||||
PATCH_SIZE: 2
|
||||
OUT_CHANNELS: 16
|
||||
DEPTH: 24
|
||||
INPUT_SIZE:
|
||||
ADM_IN_CHANNELS: 2048
|
||||
CONTEXT_EMBEDDER_CONFIG: { 'target': 'torch.nn.Linear', 'params': { 'in_features': 4096, 'out_features': 1536 } }
|
||||
NUM_PATCHES: 36864
|
||||
POS_EMBED_MAX_SIZE: 192
|
||||
POS_EMBED_SCALING_FACTOR:
|
||||
USE_CHECKPOINT: True
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKL
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-3-medium@sd3_medium.safetensors
|
||||
EMBED_DIM: 16
|
||||
IGNORE_KEYS: '^model.diffusion_model.'
|
||||
BATCH_SIZE: 1
|
||||
USE_CONV: False
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: SD3TextEmbedder
|
||||
P_ZERO: 0.0
|
||||
CLIP_L:
|
||||
NAME: FrozenCLIPEmbedder2
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@text_encoder
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@tokenizer
|
||||
MAX_LENGTH: 77
|
||||
FREEZE: True
|
||||
LAYER: penultimate
|
||||
RETURN_POOLED: True
|
||||
USE_FINAL_LAYER_NORM: False
|
||||
IS_TRAINABLE: False
|
||||
CLIP_G:
|
||||
NAME: FrozenCLIPEmbedder2
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@text_encoder_2
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@tokenizer_2
|
||||
MAX_LENGTH: 77
|
||||
FREEZE: True
|
||||
LAYER: penultimate
|
||||
RETURN_POOLED: True
|
||||
USE_FINAL_LAYER_NORM: False
|
||||
IS_TRAINABLE: False
|
||||
T5_XXL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@text_encoder_3
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/stable-diffusion-3-medium-diffusers@tokenizer_3
|
||||
LENGTH: 256
|
||||
CLEAN: whitespace
|
||||
USE_GRAD: False
|
||||
T5_DTYPE: float16
|
||||
@@ -2,7 +2,7 @@ NAME: EDIT
|
||||
IS_DEFAULT: False
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
RESOLUTIONS: [[1024, 1024]]
|
||||
RESOLUTIONS: [[512, 512], [1024, 1024]]
|
||||
INPUT:
|
||||
IMAGE:
|
||||
PROMPT: ""
|
||||
@@ -49,7 +49,7 @@ DEFAULT_PARAS:
|
||||
INPUT: ["PROMPT", "NEGATIVE_PROMPT"]
|
||||
|
||||
MODEL:
|
||||
PRETRAINED_MODEL: ms://damo/stylebooth@models/stylebooth-tb-5000-0.bin
|
||||
PRETRAINED_MODEL: ms://iic/stylebooth@models/stylebooth-tb-5000-0.bin
|
||||
SCHEDULE:
|
||||
PARAMETERIZATION: "eps"
|
||||
TIMESTEPS: 1000
|
||||
|
||||
@@ -6,64 +6,91 @@ DIFFUSION_PARAS:
|
||||
'dpm2_karras', 'dpm2_ancestral_karras', 'dpmpp_2s_ancestral_karras', 'dpmpp_2m_karras',
|
||||
'dpmpp_sde_karras', 'dpmpp_2m_sde_karras']
|
||||
DEFAULT: 'dpmpp_2s_ancestral'
|
||||
VISIBLE: True
|
||||
NEGATIVE_PROMPT:
|
||||
DEFAULT:
|
||||
VISIBLE: True
|
||||
PROMPT_PREFIX:
|
||||
DEFAULT:
|
||||
VISIBLE: True
|
||||
SAMPLES:
|
||||
MIN: 1
|
||||
MAX: 4
|
||||
DEFAULT: 1
|
||||
VISIBLE: True
|
||||
NUM_FRAMES:
|
||||
MIN: 1
|
||||
MAX: 100
|
||||
DEFAULT: 49
|
||||
VISIBLE: False
|
||||
FPS:
|
||||
MIN: 1
|
||||
MAX: 50
|
||||
DEFAULT: 8
|
||||
VISIBLE: False
|
||||
SAMPLE_STEPS:
|
||||
MIN: 1
|
||||
MAX: 100
|
||||
DEFAULT: 30
|
||||
VISIBLE: True
|
||||
GUIDE_SCALE:
|
||||
MIN: 0
|
||||
MAX: 10
|
||||
DEFAULT: 5.0
|
||||
VISIBLE: True
|
||||
GUIDE_RESCALE:
|
||||
MIN: 0
|
||||
MAX: 1.0
|
||||
DEFAULT: 0.5
|
||||
VISIBLE: True
|
||||
DISCRETIZATION:
|
||||
VALUES: ["trailing", "leading", "linspace"]
|
||||
DEFAULT: "linspace"
|
||||
VISIBLE: True
|
||||
REFINE_SAMPLERS:
|
||||
VALUES: [ 'ddim', 'euler', 'euler_ancestral', 'heun', 'dpm2',
|
||||
'dpm2_ancestral', 'dpmpp_2m', 'dpmpp_sde', 'dpmpp_2m_sde', 'dpmpp_2s_ancestral',
|
||||
'dpm2_karras', 'dpm2_ancestral_karras', 'dpmpp_2s_ancestral_karras', 'dpmpp_2m_karras',
|
||||
'dpmpp_sde_karras', 'dpmpp_2m_sde_karras' ]
|
||||
DEFAULT: 'dpmpp_2s_ancestral'
|
||||
VISIBLE: True
|
||||
REFINE_SAMPLE_STEPS:
|
||||
MIN: 0
|
||||
MAX: 100
|
||||
DEFAULT: 30
|
||||
VISIBLE: True
|
||||
REFINE_GUIDE_SCALE:
|
||||
MIN: 0
|
||||
MAX: 10
|
||||
DEFAULT: 5.0
|
||||
VISIBLE: True
|
||||
REFINE_GUIDE_RESCALE:
|
||||
MIN: 0
|
||||
MAX: 1.0
|
||||
DEFAULT: 0.5
|
||||
VISIBLE: True
|
||||
REFINE_DISCRETIZATION:
|
||||
VALUES: [ "trailing", "leading", "linspace" ]
|
||||
DEFAULT: "linspace"
|
||||
VISIBLE: True
|
||||
AESTHETIC_SCORE:
|
||||
MIN: 0.0
|
||||
MAX: 10.0
|
||||
DEFAULT: 6.0
|
||||
VISIBLE: True
|
||||
NEGATIVE_AESTHETIC_SCORE:
|
||||
MIN: 0.0
|
||||
MAX: 10.0
|
||||
DEFAULT: 2.5
|
||||
VISIBLE: True
|
||||
REFINE_STRENGTH:
|
||||
MIN: 0
|
||||
MAX: 1.0
|
||||
DEFAULT: 0.15
|
||||
RESOLUTIONS:
|
||||
VALUES: [[704, 1408], [704, 1344], [768, 1344],
|
||||
VALUES: [
|
||||
[512, 512], [768, 768],
|
||||
[704, 1408], [704, 1344], [768, 1344],
|
||||
[720, 1280],
|
||||
[768, 1280], [832, 1216], [832, 1152],
|
||||
[896, 1152], [896, 1088], [960, 1088],
|
||||
@@ -73,8 +100,14 @@ DIFFUSION_PARAS:
|
||||
[1280, 768],
|
||||
[1344, 768], [1344, 704], [1408, 704],
|
||||
[1472, 704], [1536, 640], [1600, 640],
|
||||
[1664, 576], [1728, 576]]
|
||||
[1664, 576], [1728, 576],
|
||||
[2048, 2048], [2048, 1920], [1920, 2048],
|
||||
[1536, 2560], [2560, 1536], [2560, 1440],
|
||||
[2560, 1440],
|
||||
[480, 720], [720, 480]
|
||||
]
|
||||
DEFAULT: [1024, 1024]
|
||||
VISIBLE: True
|
||||
EXTENSION_PARAS:
|
||||
MANTRA_BOOK: scepter/methods/studio/extensions/mantra_book/mantra_book.yaml
|
||||
OFFICIAL_TUNERS: scepter/methods/studio/extensions/tuners/official_tuners.yaml
|
||||
@@ -87,18 +120,18 @@ CONTROLABLE_ANNOTATORS:
|
||||
IS_DEFAULT: True
|
||||
-
|
||||
NAME: "HedAnnotator"
|
||||
PRETRAINED_MODEL: "ms://damo/scepter_scedit@annotator/ckpts/ControlNetHED.pth"
|
||||
PRETRAINED_MODEL: "ms://iic/scepter_scedit@annotator/ckpts/ControlNetHED.pth"
|
||||
TYPE: Hed
|
||||
IS_DEFAULT: False
|
||||
-
|
||||
NAME: "OpenposeAnnotator"
|
||||
BODY_MODEL_PATH: "ms://damo/scepter_scedit@annotator/ckpts/body_pose_model.pth"
|
||||
HAND_MODEL_PATH: "ms://damo/scepter_scedit@annotator/ckpts/hand_pose_model.pth"
|
||||
BODY_MODEL_PATH: "ms://iic/scepter_scedit@annotator/ckpts/body_pose_model.pth"
|
||||
HAND_MODEL_PATH: "ms://iic/scepter_scedit@annotator/ckpts/hand_pose_model.pth"
|
||||
TYPE: Openpose
|
||||
IS_DEFAULT: False
|
||||
-
|
||||
NAME: "MidasDetector"
|
||||
PRETRAINED_MODEL: "ms://damo/scepter_scedit@annotator/ckpts/dpt_hybrid-midas-501f0c75.pt"
|
||||
PRETRAINED_MODEL: "ms://iic/scepter_scedit@annotator/ckpts/dpt_hybrid-midas-501f0c75.pt"
|
||||
TYPE: Midas
|
||||
IS_DEFAULT: False
|
||||
-
|
||||
|
||||
@@ -68,7 +68,7 @@ DEFAULT_PARAS:
|
||||
INPUT: ["ORIGINAL_SIZE_AS_TUPLE", "AESTHETIC_SCORE", "NEGATIVE_AESTHETIC_SCORE", "CROP_COORDS_TOP_LEFT", "PROMPT", "NEGATIVE_PROMPT"]
|
||||
|
||||
MODEL:
|
||||
PRETRAINED_MODEL: ms://damo/LARGEN@models/largen_ckpt_s22k.pth
|
||||
PRETRAINED_MODEL: ms://iic/LARGEN@models/largen_ckpt_s22k.pth
|
||||
# SCHEDULE_ARGS DESCRIPTION: TYPE: default: ''
|
||||
SCHEDULE:
|
||||
PARAMETERIZATION: "eps"
|
||||
@@ -245,8 +245,8 @@ MODEL:
|
||||
LEGACY_UCG_VALUE:
|
||||
-
|
||||
NAME: IPAdapterPlusEmbedder
|
||||
CLIP_DIR: ms://damo/LARGEN@models/clip_encoder/
|
||||
PRETRAINED_MODEL: ms://damo/LARGEN@models/ip-adapter-plus_sdxl_vit-h.bin
|
||||
CLIP_DIR: ms://iic/LARGEN@models/clip_encoder/
|
||||
PRETRAINED_MODEL: ms://iic/LARGEN@models/ip-adapter-plus_sdxl_vit-h.bin
|
||||
INPUT_KEYS: [ "ref_ip", "ref_detail" ]
|
||||
IN_DIM: 1280
|
||||
HEADS: 20
|
||||
|
||||