
 | Run vision models locally (Qwen3-VL, Florence-2, etc.) - no API key needed |
| **SID_LLM_API** |
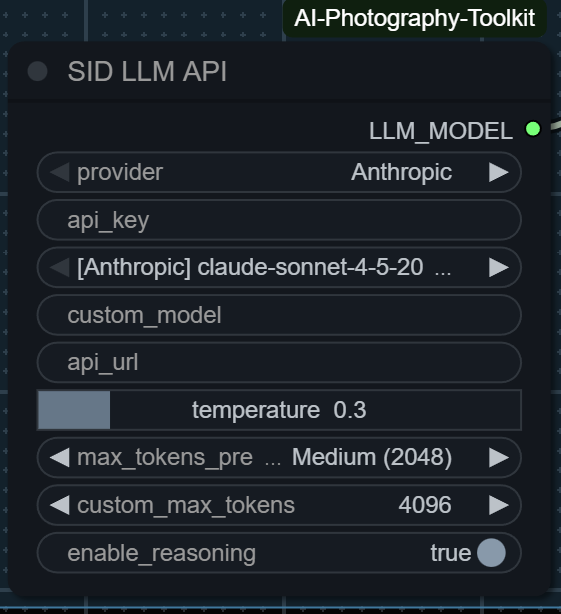 | Use cloud providers (Claude, GPT-4o, Gemini, Grok, etc.) |
| **SID_ZImagePromptGenerator** |
 | Generate prompts from images |
## Quick Start
### Option 1: Cloud API (Best Quality)
1. Add **SID_LLM_API** node
2. Select provider (e.g., `Anthropic`)
3. Enter your API key
4. Add **SID_ZImagePromptGenerator** node
5. Connect: `LLM node → Prompt Generator ← Image`
6. Run!
### Option 2: Local (Free, No API Key)
1. Add **SID_LLM_Local** node
2. Select model (e.g., `Qwen3-VL-8B-Instruct`)
3. Add **SID_ZImagePromptGenerator** node
4. Connect: `LLM node → Prompt Generator ← Image`
5. Run!
## Workflow
```
Image ─────────────────┐
├─→ SID_ZImagePromptGenerator ─→ prompt ─→ CLIP Text Encode
SID_LLM_API ───────────┘
(or SID_LLM_Local)
```
## Supported Providers
**Cloud (require API key):** Anthropic Claude, OpenAI GPT-4o, Google Gemini, xAI Grok, Mistral, Together AI, Fireworks, Groq, OpenRouter
**Local (free):** Ollama, LM Studio, or use SID_LLM_Local with built-in models
## Sample Workflow
Download: [sample_workflow.json](sample_workflows/sample_workflow.json)
## Tips
- **Best quality:** Use Claude or GPT-4o with "Enable Reasoning" turned on
- **Best local:** Use Qwen3-VL-8B-Instruct with reasoning off
- **Fastest:** Use "Quick" analysis mode
---
**Version:** 4.2.0 | **Author:** Siddhartha Lahiri
For advanced configuration, provider details, and migration guide, see [Technical_Details.md](Technical_Details.md).
[Changelog](CHANGELOG.md) | [MIT License](LICENSE)