docs: add Japanese README file (#138)
I created Japanese translated README.
This commit is contained in:
 Ikko Eltociear Ashimine
@@ -11,7 +11,7 @@
|
||||
[](https://huggingface.co/spaces/alibaba-pai/EasyAnimate)
|
||||
[](https://discord.gg/UzkpB4Bn)
|
||||
|
||||
English | [简体中文](./README_zh-CN.md)
|
||||
English | [简体中文](./README_zh-CN.md) | [日本語](./README_ja.md)
|
||||
|
||||
# Table of Contents
|
||||
- [Table of Contents](#table-of-contents)
|
||||
@@ -436,4 +436,4 @@ EasyAnimateV5:
|
||||
- HunYuan DiT: https://github.com/tencent/HunyuanDiT
|
||||
|
||||
# License
|
||||
This project is licensed under the [Apache License (Version 2.0)](https://github.com/modelscope/modelscope/blob/master/LICENSE).
|
||||
This project is licensed under the [Apache License (Version 2.0)](https://github.com/modelscope/modelscope/blob/master/LICENSE).
|
||||
|
||||
+438
@@ -0,0 +1,438 @@
|
||||
# 📷 EasyAnimate | 高解像度および長時間動画生成のためのエンドツーエンドソリューション
|
||||
😊 EasyAnimateは、高解像度および長時間動画を生成するためのエンドツーエンドソリューションです。トランスフォーマーベースの拡散生成器をトレーニングし、長時間動画を処理するためのVAEをトレーニングし、メタデータを前処理することができます。
|
||||
|
||||
😊 DITをベースに、トランスフォーマーを拡散器として使用して動画や画像を生成します。
|
||||
|
||||
😊 ようこそ!
|
||||
|
||||
[](https://arxiv.org/abs/2405.18991)
|
||||
[](https://easyanimate.github.io/)
|
||||
[](https://modelscope.cn/studios/PAI/EasyAnimate/summary)
|
||||
[](https://huggingface.co/spaces/alibaba-pai/EasyAnimate)
|
||||
[](https://discord.gg/UzkpB4Bn)
|
||||
|
||||
English | [简体中文](./README_zh-CN.md) | 日本語
|
||||
|
||||
# 目次
|
||||
- [目次](#目次)
|
||||
- [紹介](#紹介)
|
||||
- [クイックスタート](#クイックスタート)
|
||||
- [ビデオ結果](#ビデオ結果)
|
||||
- [使い方](#使い方)
|
||||
- [モデルズー](#モデルズー)
|
||||
- [TODOリスト](#todoリスト)
|
||||
- [お問い合わせ](#お問い合わせ)
|
||||
- [参考文献](#参考文献)
|
||||
- [ライセンス](#ライセンス)
|
||||
|
||||
# 紹介
|
||||
EasyAnimateは、トランスフォーマーアーキテクチャに基づいたパイプラインで、AI画像および動画の生成、Diffusion TransformerのベースラインモデルおよびLoraモデルのトレーニングに使用されます。事前トレーニング済みのEasyAnimateモデルから直接予測を行い、さまざまな解像度で約6秒間、8fpsの動画を生成できます(EasyAnimateV5、1〜49フレーム)。さらに、ユーザーは特定のスタイル変換のために独自のベースラインおよびLoraモデルをトレーニングできます。
|
||||
|
||||
異なるプラットフォームからのクイックプルアップをサポートします。詳細は[クイックスタート](#クイックスタート)を参照してください。
|
||||
|
||||
**新機能:**
|
||||
- **v5に更新**、1024x1024までの動画生成をサポート、49フレーム、6秒、8fps、モデルスケールを12Bに拡張、MMDIT構造を組み込み、さまざまな入力を持つ制御モデルをサポート。中国語と英語のバイリンガル予測をサポート。[2024.11.08]
|
||||
- **v4に更新**、1024x1024までの動画生成をサポート、144フレーム、6秒、24fps、テキスト、画像、動画からの動画生成をサポート、512から1280までの解像度を単一モデルで処理。中国語と英語のバイリンガル予測をサポート。[2024.08.15]
|
||||
- **v3に更新**、960x960までの動画生成をサポート、144フレーム、6秒、24fps、テキストと画像からの動画生成をサポート。[2024.07.01]
|
||||
- **ModelScope-Sora “データディレクター” クリエイティブレース** — 第三回Data-Juicerビッグモデルデータチャレンジが正式に開始されました!EasyAnimateをベースモデルとして使用し、データ処理がモデルトレーニングに与える影響を探ります。詳細は[競技ウェブサイト](https://tianchi.aliyun.com/competition/entrance/532219)をご覧ください。[2024.06.17]
|
||||
- **v2に更新**、768x768までの動画生成をサポート、144フレーム、6秒、24fps。[2024.05.26]
|
||||
- **コード作成!** 現在、WindowsおよびLinuxをサポート。[2024.04.12]
|
||||
|
||||
機能:
|
||||
- [データ前処理](#data-preprocess)
|
||||
- [VAEのトレーニング](#vae-train)
|
||||
- [DiTのトレーニング](#dit-train)
|
||||
- [動画生成](#video-gen)
|
||||
|
||||
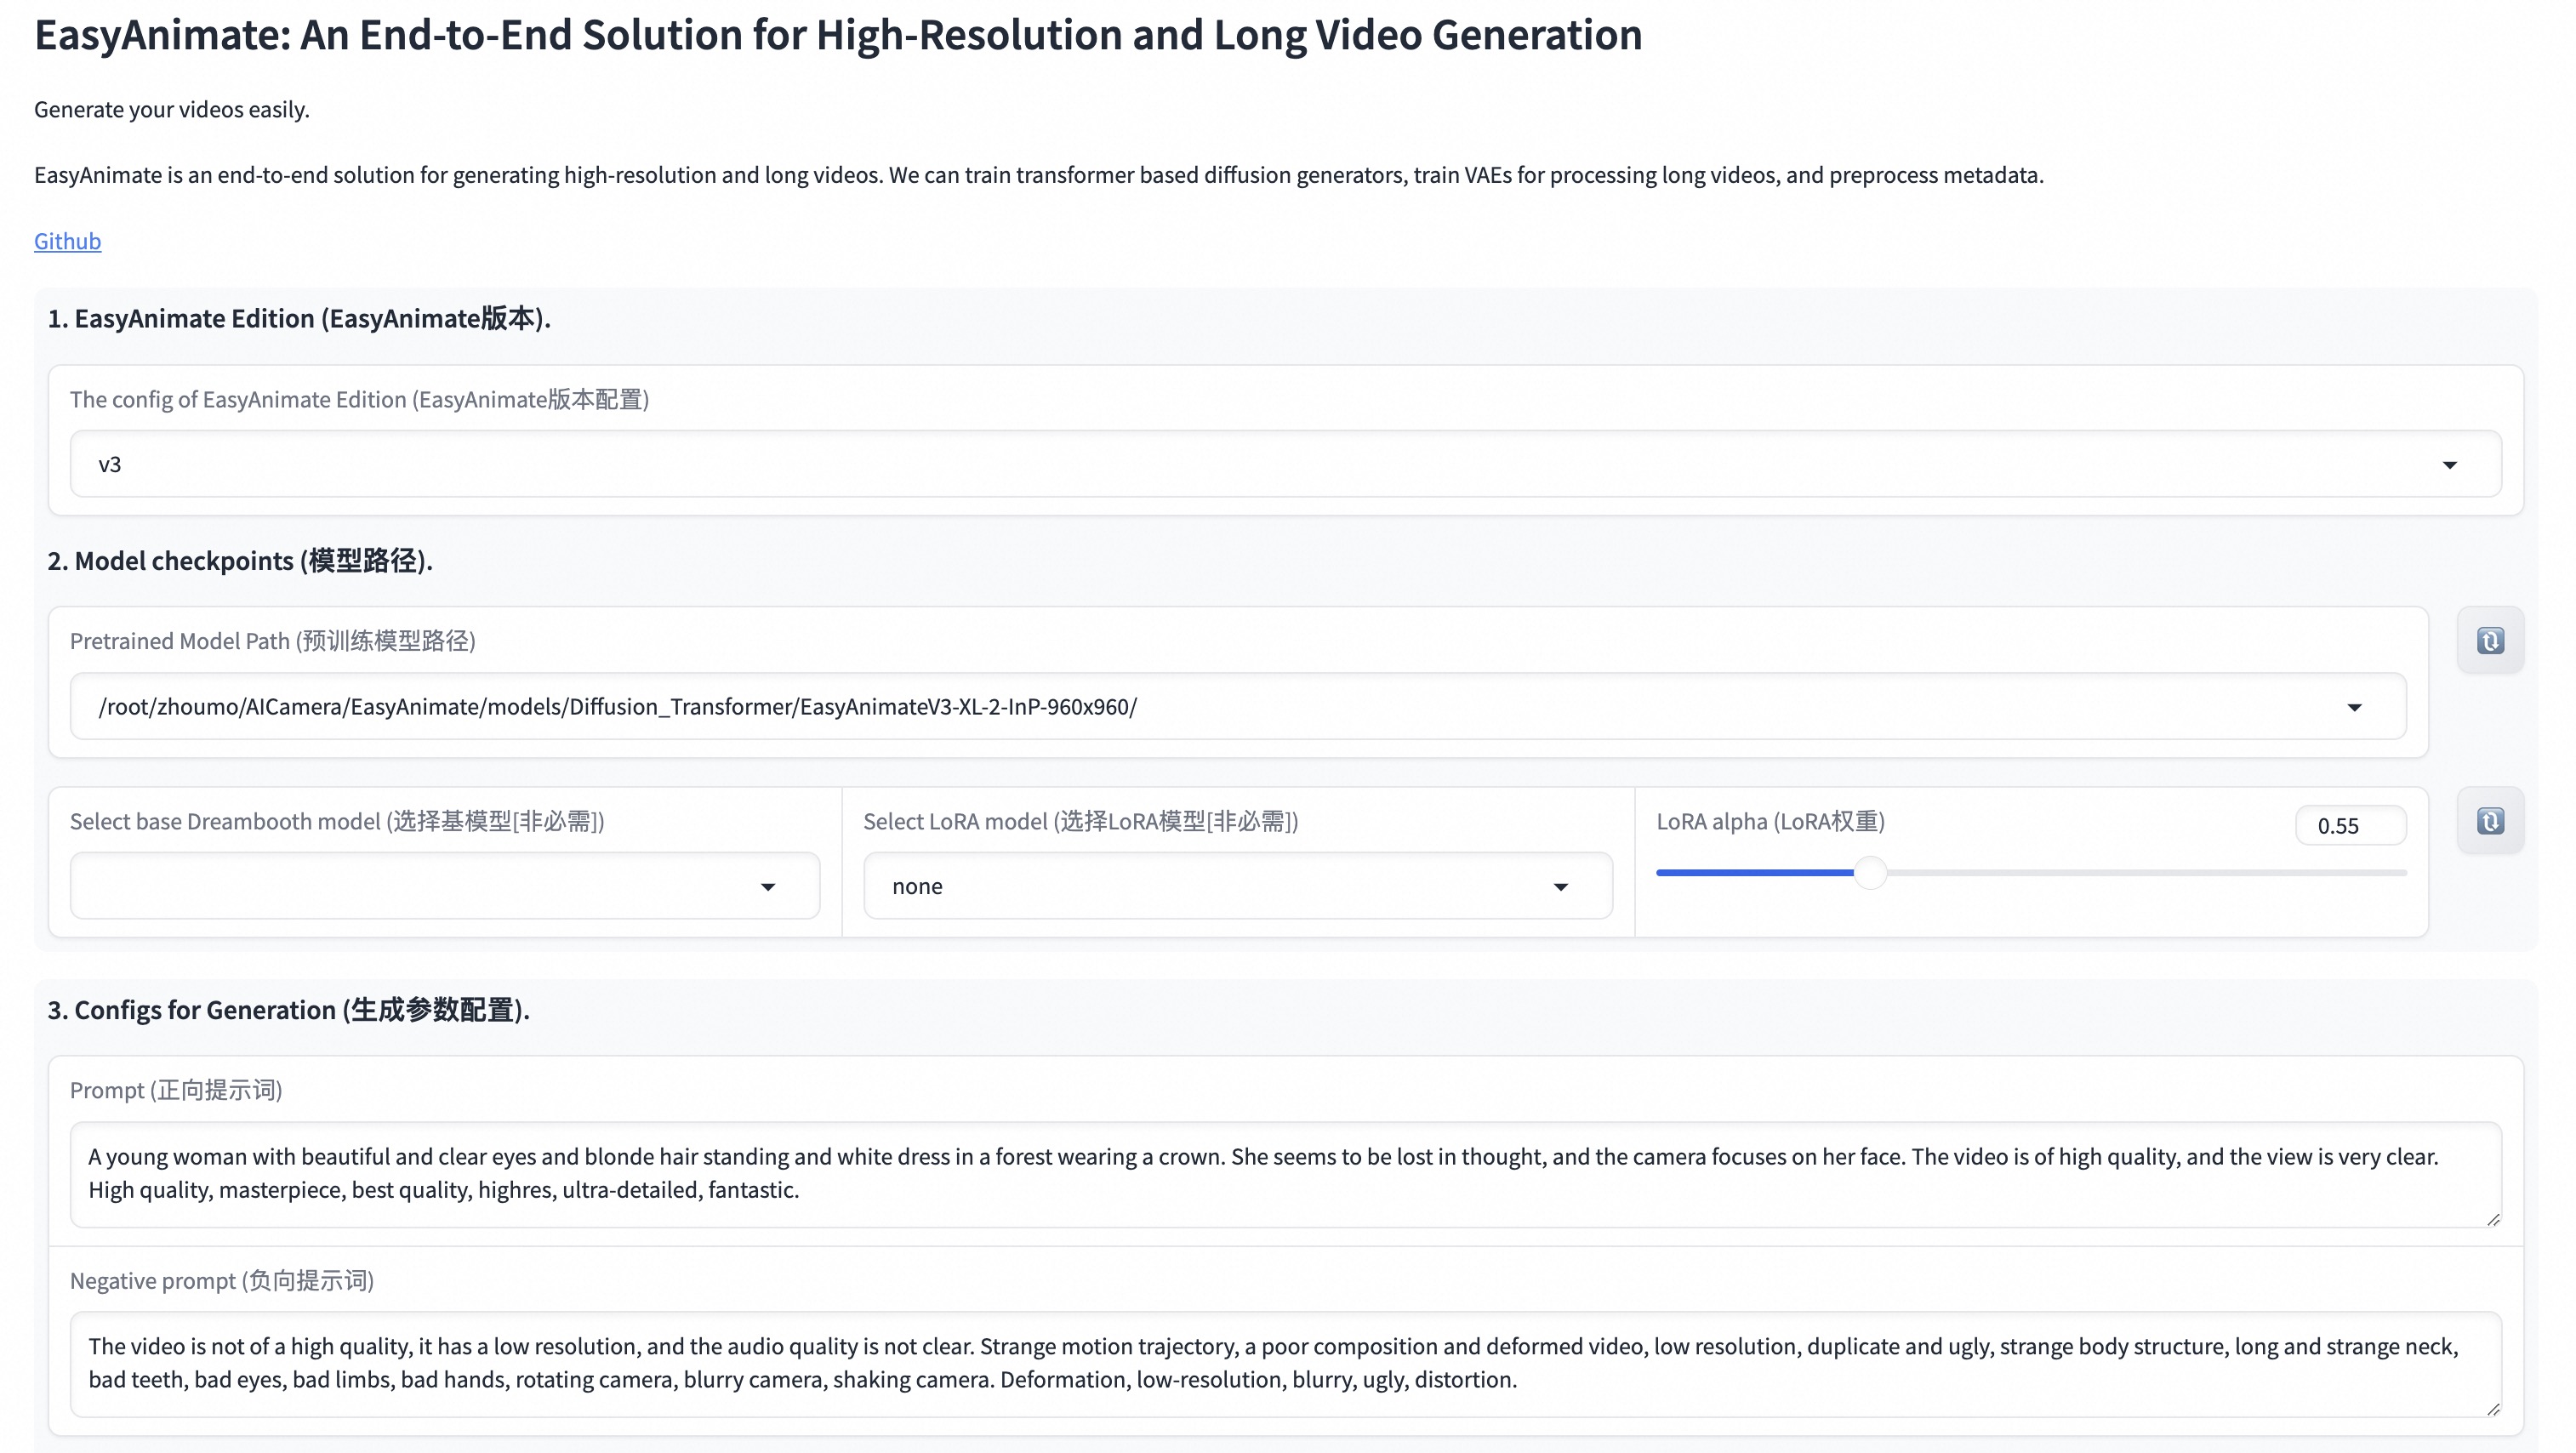
私たちのUIインターフェースは次のとおりです:
|
||||
|
||||
|
||||
# クイックスタート
|
||||
### 1. クラウド使用: AliyunDSW/Docker
|
||||
#### a. AliyunDSWから
|
||||
DSWには無料のGPU時間があり、ユーザーは一度申請でき、申請後3ヶ月間有効です。
|
||||
|
||||
Aliyunは[Freetier](https://free.aliyun.com/?product=9602825&crowd=enterprise&spm=5176.28055625.J_5831864660.1.e939154aRgha4e&scm=20140722.M_9974135.P_110.MO_1806-ID_9974135-MID_9974135-CID_30683-ST_8512-V_1)で無料のGPU時間を提供しており、取得してAliyun PAI-DSWで使用し、5分以内にEasyAnimateを開始できます!
|
||||
|
||||
[](https://gallery.pai-ml.com/#/preview/deepLearning/cv/easyanimate)
|
||||
|
||||
#### b. ComfyUIから
|
||||
私たちのComfyUIは次のとおりです。詳細は[ComfyUI README](comfyui/README.md)を参照してください。
|
||||
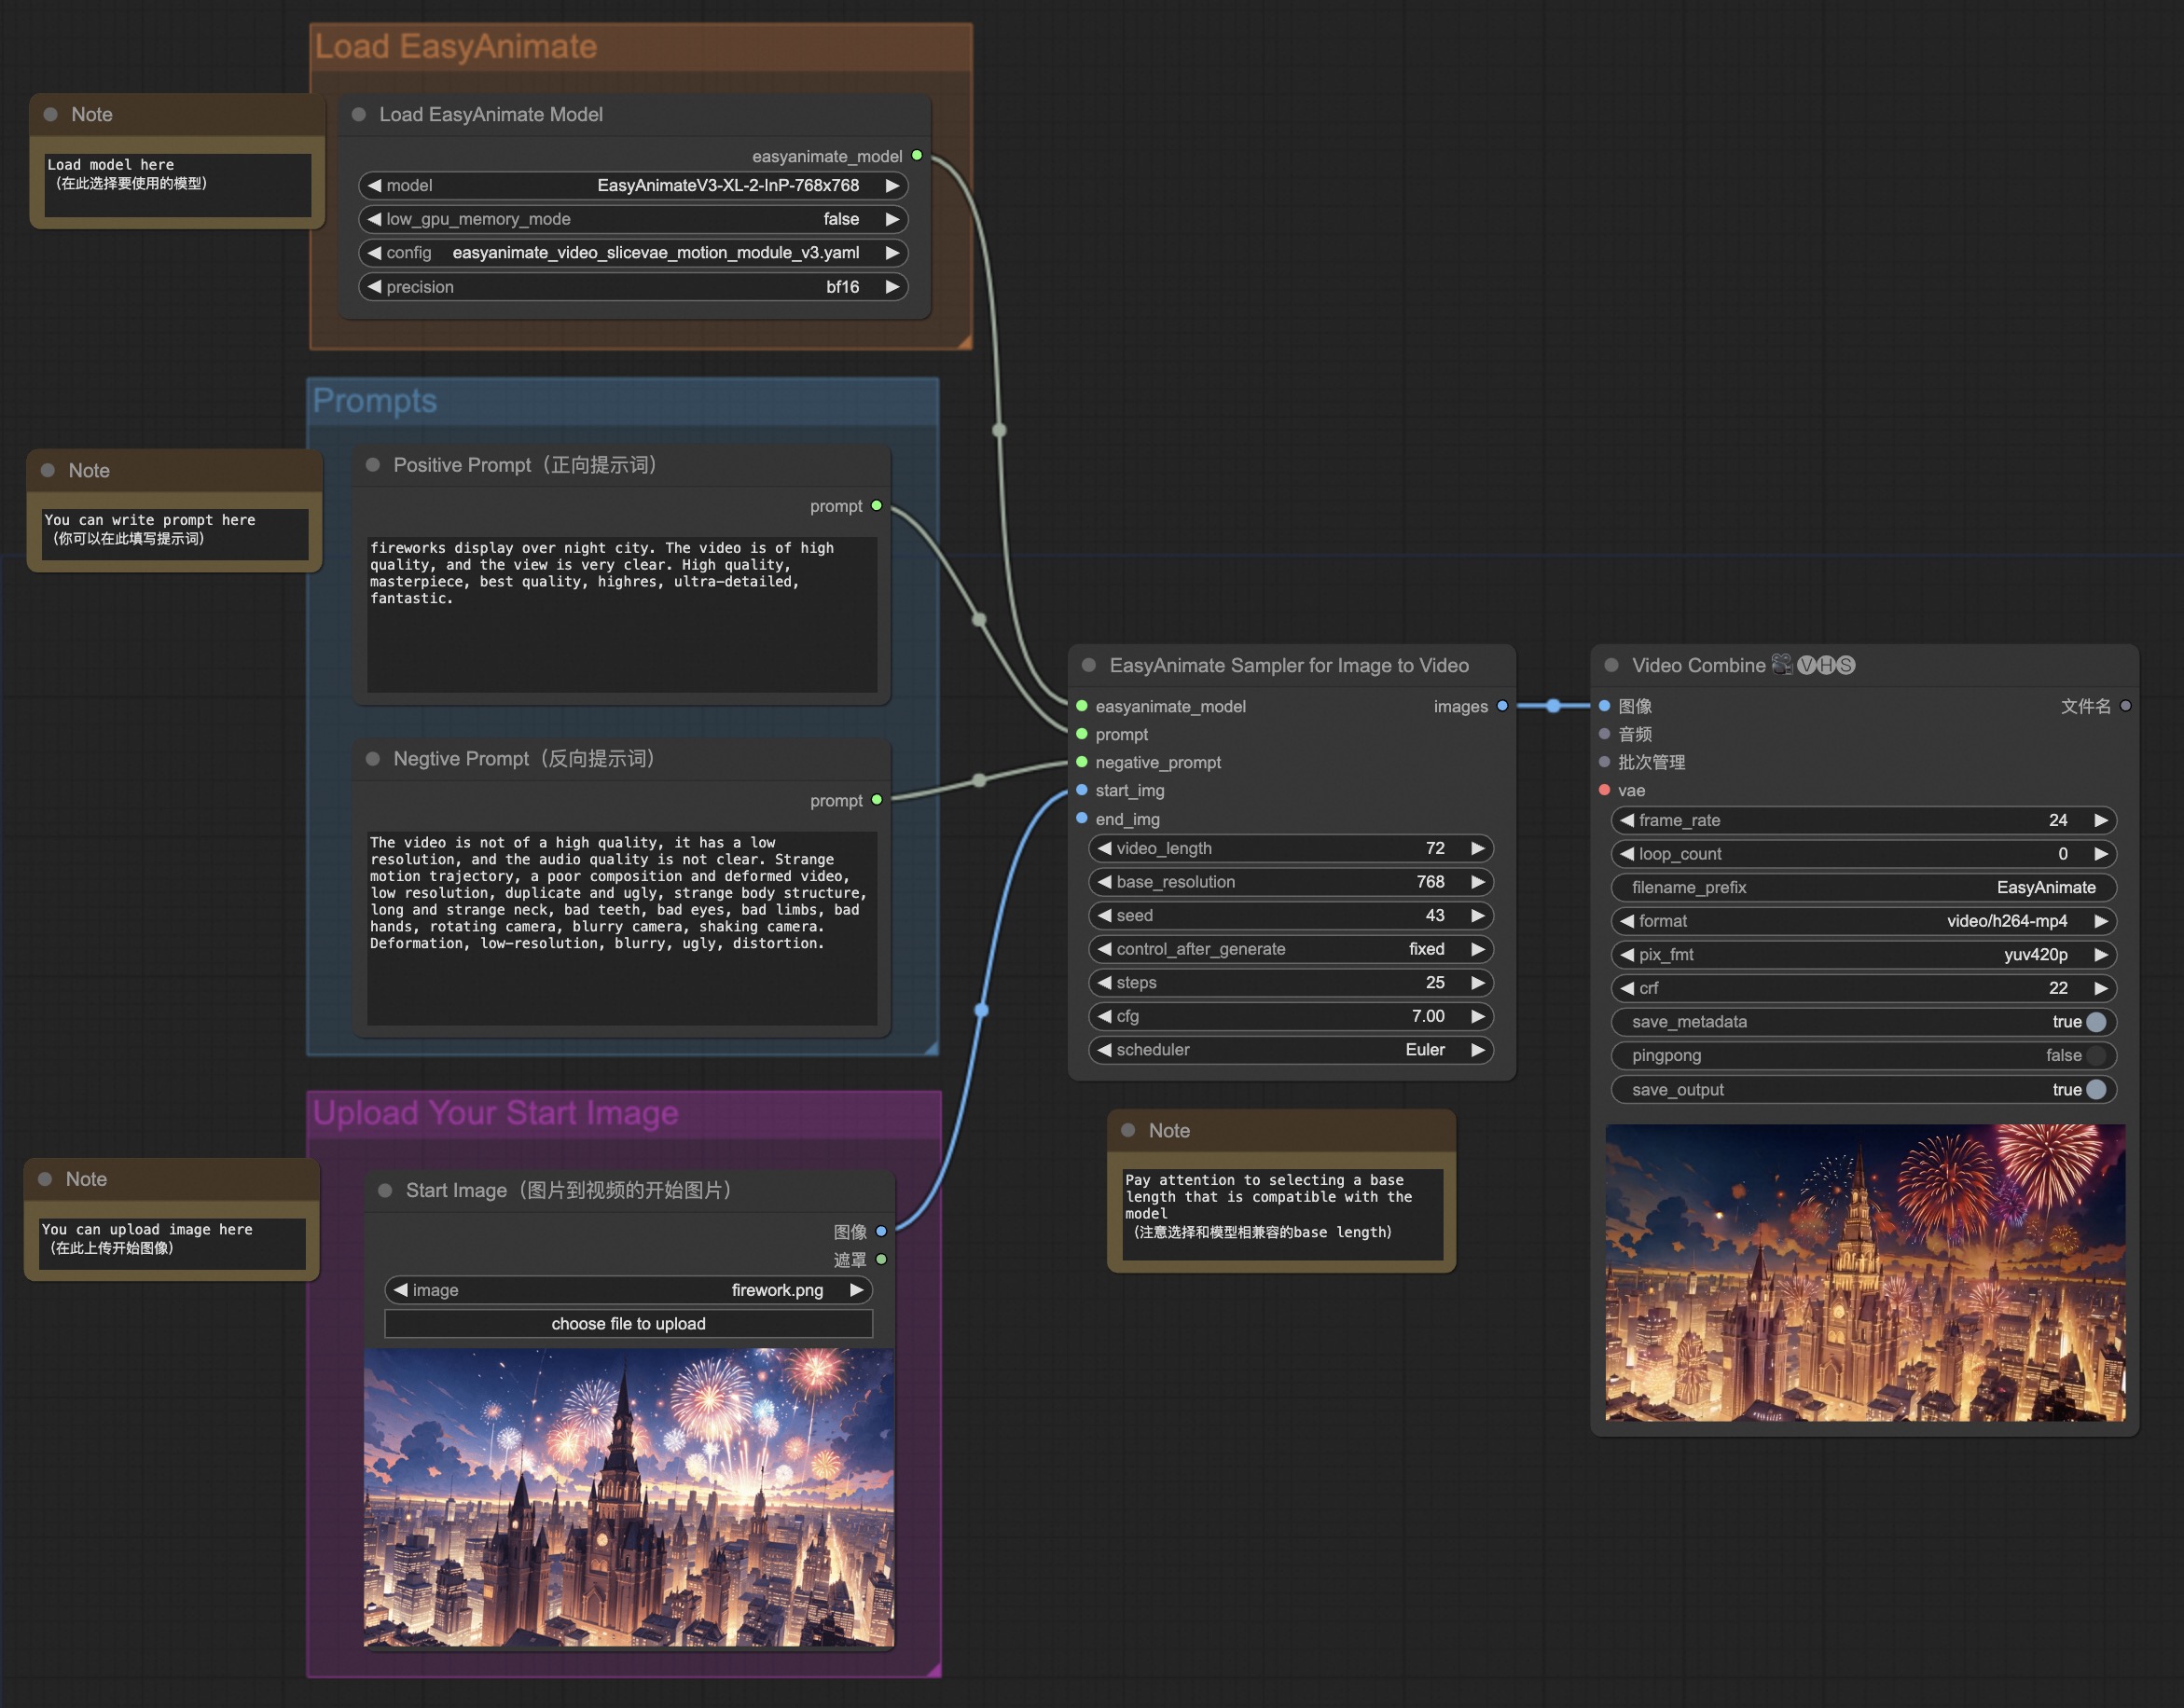
|
||||
|
||||
#### c. Dockerから
|
||||
Dockerを使用している場合は、マシンにグラフィックスカードドライバとCUDA環境が正しくインストールされていることを確認してください。
|
||||
|
||||
次のコマンドを実行します:
|
||||
```
|
||||
# イメージをプル
|
||||
docker pull mybigpai-public-registry.cn-beijing.cr.aliyuncs.com/easycv/torch_cuda:easyanimate
|
||||
|
||||
# イメージに入る
|
||||
docker run -it -p 7860:7860 --network host --gpus all --security-opt seccomp:unconfined --shm-size 200g mybigpai-public-registry.cn-beijing.cr.aliyuncs.com/easycv/torch_cuda:easyanimate
|
||||
|
||||
# コードをクローン
|
||||
git clone https://github.com/aigc-apps/EasyAnimate.git
|
||||
|
||||
# EasyAnimateのディレクトリに入る
|
||||
cd EasyAnimate
|
||||
|
||||
# 重みをダウンロード
|
||||
mkdir models/Diffusion_Transformer
|
||||
mkdir models/Motion_Module
|
||||
mkdir models/Personalized_Model
|
||||
|
||||
# EasyAnimateV5モデルをダウンロードするには、hugginfaceリンクまたはmodelscopeリンクを使用してください。
|
||||
# I2Vモデル
|
||||
# https://huggingface.co/alibaba-pai/EasyAnimateV5-12b-zh-InP
|
||||
# https://modelscope.cn/models/PAI/EasyAnimateV5-12b-zh-InP
|
||||
# T2Vモデル
|
||||
# https://huggingface.co/alibaba-pai/EasyAnimateV5-12b-zh
|
||||
# https://modelscope.cn/models/PAI/EasyAnimateV5-12b-zh
|
||||
```
|
||||
|
||||
### 2. ローカルインストール: 環境チェック/ダウンロード/インストール
|
||||
#### a. 環境チェック
|
||||
次の環境でEasyAnimateの実行を確認しました:
|
||||
|
||||
Windowsの詳細:
|
||||
- OS: Windows 10
|
||||
- python: python3.10 & python3.11
|
||||
- pytorch: torch2.2.0
|
||||
- CUDA: 11.8 & 12.1
|
||||
- CUDNN: 8+
|
||||
- GPU: Nvidia-3060 12G
|
||||
|
||||
Linuxの詳細:
|
||||
- OS: Ubuntu 20.04, CentOS
|
||||
- python: python3.10 & python3.11
|
||||
- pytorch: torch2.2.0
|
||||
- CUDA: 11.8 & 12.1
|
||||
- CUDNN: 8+
|
||||
- GPU:Nvidia-V100 16G & Nvidia-A10 24G & Nvidia-A100 40G & Nvidia-A100 80G
|
||||
|
||||
ディスクに約60GBの空き容量が必要です(重みを保存するため)、確認してください!
|
||||
|
||||
#### b. 重み
|
||||
[重み](#model-zoo)を指定されたパスに配置することをお勧めします:
|
||||
|
||||
EasyAnimateV5:
|
||||
```
|
||||
📦 models/
|
||||
├── 📂 Diffusion_Transformer/
|
||||
│ ├── 📂 EasyAnimateV5-12b-zh-InP/
|
||||
│ └── 📂 EasyAnimateV5-12b-zh/
|
||||
├── 📂 Personalized_Model/
|
||||
│ └── あなたのトレーニング済みのトランスフォーマーモデル / あなたのトレーニング済みのLoraモデル(UIロード用)
|
||||
```
|
||||
|
||||
# ビデオ結果
|
||||
表示されている結果はすべて画像からの生成に基づいています。
|
||||
|
||||
### EasyAnimateV5-12b-zh-InP
|
||||
|
||||
#### I2V
|
||||
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;">
|
||||
<tr>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/bb393b7c-ba33-494c-ab06-b314adea9fc1" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/cb0d0253-919d-4dd6-9dc1-5cd94443c7f1" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/09ed361f-c0c5-4025-aad7-71fe1a1a52b1" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/9f42848d-34eb-473f-97ea-a5ebd0268106" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
</tr>
|
||||
</table>
|
||||
|
||||
|
||||
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;">
|
||||
<tr>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/903fda91-a0bd-48ee-bf64-fff4e4d96f17" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/407c6628-9688-44b6-b12d-77de10fbbe95" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/ccf30ec1-91d2-4d82-9ce0-fcc585fc2f21" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/5dfe0f92-7d0d-43e0-b7df-0ff7b325663c" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
</tr>
|
||||
</table>
|
||||
|
||||
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;">
|
||||
<tr>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/2b542b85-be19-4537-9607-9d28ea7e932e" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/c1662745-752d-4ad2-92bc-fe53734347b2" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/8bec3d66-50a3-4af5-a381-be2c865825a0" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/bcec22f4-732c-446f-958c-2ebbfd8f94be" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
</tr>
|
||||
</table>
|
||||
|
||||
#### T2V
|
||||
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;">
|
||||
<tr>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/eccb0797-4feb-48e9-91d3-5769ce30142b" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/76b3db64-9c7a-4d38-8854-dba940240ceb" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/0b8fab66-8de7-44ff-bd43-8f701bad6bb7" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/9fbddf5f-7fcd-4cc6-9d7c-3bdf1d4ce59e" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
</tr>
|
||||
</table>
|
||||
|
||||
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;">
|
||||
<tr>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/19c1742b-e417-45ac-97d6-8bf3a80d8e13" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/641e56c8-a3d9-489d-a3a6-42c50a9aeca1" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/2b16be76-518b-44c6-a69b-5c49d76df365" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/e7d9c0fc-136f-405c-9fab-629389e196be" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
</tr>
|
||||
</table>
|
||||
|
||||
### EasyAnimateV5-12b-zh-Control
|
||||
|
||||
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;">
|
||||
<tr>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/53002ce2-dd18-4d4f-8135-b6f68364cabd" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/fce43c0b-81fa-4ab2-9ca7-78d786f520e6" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/b208b92c-5add-4ece-a200-3dbbe47b93c3" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<tr>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/3aec95d5-d240-49fb-a9e9-914446c7a4cf" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/60fa063b-5c1f-485f-b663-09bd6669de3f" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
<td>
|
||||
<video src="https://github.com/user-attachments/assets/4adde728-8397-42f3-8a2a-23f7b39e9a1e" width="100%" controls autoplay loop></video>
|
||||
</td>
|
||||
</tr>
|
||||
</table>
|
||||
|
||||
|
||||
# 使い方
|
||||
|
||||
<h3 id="video-gen">1. 推論 </h3>
|
||||
|
||||
#### a. Pythonコードを使用する
|
||||
- ステップ1:対応する[重み](#model-zoo)をダウンロードし、modelsフォルダに配置します。
|
||||
- ステップ2:predict_t2v.pyファイルでprompt、neg_prompt、guidance_scale、およびseedを変更します。
|
||||
- ステップ3:predict_t2v.pyファイルを実行し、生成された結果を待ちます。結果はsamples/easyanimate-videosフォルダに保存されます。
|
||||
- ステップ4:他のバックボーンとLoraを組み合わせたい場合は、状況に応じてpredict_t2v.pyおよびLora_pathを変更します。
|
||||
|
||||
#### b. WebUIを使用する
|
||||
- ステップ1:対応する[重み](#model-zoo)をダウンロードし、modelsフォルダに配置します。
|
||||
- ステップ2:app.pyファイルを実行してグラフページに入ります。
|
||||
- ステップ3:ページに基づいて生成モデルを選択し、prompt、neg_prompt、guidance_scale、およびseedを入力し、生成をクリックして生成結果を待ちます。結果はsamplesフォルダに保存されます。
|
||||
|
||||
#### c. ComfyUIから
|
||||
詳細は[ComfyUI README](comfyui/README.md)を参照してください。
|
||||
|
||||
#### d. GPUメモリ節約スキーム
|
||||
|
||||
EasyAnimateV5のパラメータが大きいため、メモリを節約するためにGPUメモリ節約スキームを検討する必要があります。各予測ファイルには、`GPU_memory_mode`オプションがあり、`model_cpu_offload`、`model_cpu_offload_and_qfloat8`、および`sequential_cpu_offload`から選択できます。
|
||||
|
||||
- `model_cpu_offload`は、使用後にモデル全体がCPUにオフロードされることを示し、一部のGPUメモリを節約します。
|
||||
- `model_cpu_offload_and_qfloat8`は、使用後にモデル全体がCPUにオフロードされ、トランスフォーマーモデルがfloat8に量子化され、さらに多くのGPUメモリを節約します。
|
||||
- `sequential_cpu_offload`は、使用後にモデルの各層がCPUにオフロードされることを意味し、速度は遅くなりますが、大量のGPUメモリを節約します。
|
||||
|
||||
### 2. モデルトレーニング
|
||||
完全なEasyAnimateトレーニングパイプラインには、データ前処理、Video VAEトレーニング、およびVideo DiTトレーニングが含まれる必要があります。これらの中で、Video VAEトレーニングはオプションです。すでにトレーニング済みのVideo VAEを提供しているためです。
|
||||
|
||||
<h4 id="data-preprocess">a. データ前処理</h4>
|
||||
|
||||
画像データを使用してLoraモデルをトレーニングする簡単なデモを提供しています。詳細は[wiki](https://github.com/aigc-apps/EasyAnimate/wiki/Training-Lora)を参照してください。
|
||||
|
||||
長時間動画のセグメンテーション、クリーニング、および説明のための完全なデータ前処理リンクは、ビデオキャプションセクションの[README](./easyanimate/video_caption/README.md)を参照してください。
|
||||
|
||||
テキストから画像および動画生成モデルをトレーニングする場合は、データセットを次の形式で配置する必要があります。
|
||||
|
||||
```
|
||||
📦 project/
|
||||
├── 📂 datasets/
|
||||
│ ├── 📂 internal_datasets/
|
||||
│ ├── 📂 train/
|
||||
│ │ ├── 📄 00000001.mp4
|
||||
│ │ ├── 📄 00000002.jpg
|
||||
│ │ └── 📄 .....
|
||||
│ └── 📄 json_of_internal_datasets.json
|
||||
```
|
||||
|
||||
json_of_internal_datasets.jsonは標準のJSONファイルです。json内のfile_pathは相対パスとして設定できます。以下のように:
|
||||
```json
|
||||
[
|
||||
{
|
||||
"file_path": "train/00000001.mp4",
|
||||
"text": "A group of young men in suits and sunglasses are walking down a city street.",
|
||||
"type": "video"
|
||||
},
|
||||
{
|
||||
"file_path": "train/00000002.jpg",
|
||||
"text": "A group of young men in suits and sunglasses are walking down a city street.",
|
||||
"type": "image"
|
||||
},
|
||||
.....
|
||||
]
|
||||
```
|
||||
|
||||
パスを絶対パスとして設定することもできます:
|
||||
```json
|
||||
[
|
||||
{
|
||||
"file_path": "/mnt/data/videos/00000001.mp4",
|
||||
"text": "A group of young men in suits and sunglasses are walking down a city street.",
|
||||
"type": "video"
|
||||
},
|
||||
{
|
||||
"file_path": "/mnt/data/train/00000001.jpg",
|
||||
"text": "A group of young men in suits and sunglasses are walking down a city street.",
|
||||
"type": "image"
|
||||
},
|
||||
.....
|
||||
]
|
||||
```
|
||||
|
||||
<h4 id="vae-train">b. Video VAEトレーニング(オプション)</h4>
|
||||
|
||||
Video VAEトレーニングはオプションです。すでにトレーニング済みのVideo VAEを提供しているためです。
|
||||
Video VAEをトレーニングする場合は、ビデオVAEセクションの[README](easyanimate/vae/README.md)を参照してください。
|
||||
|
||||
<h4 id="dit-train">c. Video DiTトレーニング </h4>
|
||||
|
||||
データ前処理時にデータ形式が相対パスの場合、```scripts/train.sh```を次のように設定します。
|
||||
```
|
||||
export DATASET_NAME="datasets/internal_datasets/"
|
||||
export DATASET_META_NAME="datasets/internal_datasets/json_of_internal_datasets.json"
|
||||
```
|
||||
|
||||
データ前処理時にデータ形式が絶対パスの場合、```scripts/train.sh```を次のように設定します。
|
||||
```
|
||||
export DATASET_NAME=""
|
||||
export DATASET_META_NAME="/mnt/data/json_of_internal_datasets.json"
|
||||
```
|
||||
|
||||
次に、scripts/train.shを実行します。
|
||||
```sh
|
||||
sh scripts/train.sh
|
||||
```
|
||||
|
||||
一部のパラメータの設定の詳細については、[Readme Train](scripts/README_TRAIN.md)および[Readme Lora](scripts/README_TRAIN_LORA.md)を参照してください。
|
||||
|
||||
<details>
|
||||
<summary>(Obsolete) EasyAnimateV1:</summary>
|
||||
EasyAnimateV1をトレーニングする場合は、gitブランチv1に切り替えてください。
|
||||
</details>
|
||||
|
||||
# モデルズー
|
||||
|
||||
EasyAnimateV5:
|
||||
|
||||
| 名前 | 種類 | ストレージスペース | Hugging Face | Model Scope | 説明 |
|
||||
|--|--|--|--|--|--|
|
||||
| EasyAnimateV5-12b-zh-InP | EasyAnimateV5 | 34 GB | [🤗Link](https://huggingface.co/alibaba-pai/EasyAnimateV5-12b-zh-InP) | [😄Link](https://modelscope.cn/models/PAI/EasyAnimateV5-12b-zh-InP) | 公式の画像から動画への重み。複数の解像度(512、768、1024)での動画予測をサポートし、49フレーム、毎秒8フレームでトレーニングされ、中国語と英語のバイリンガル予測をサポートします。 |
|
||||
| EasyAnimateV5-12b-zh-Control | EasyAnimateV5 | 34 GB | [🤗Link](https://huggingface.co/alibaba-pai/EasyAnimateV5-12b-zh-Control) | [😄Link](https://modelscope.cn/models/PAI/EasyAnimateV5-12b-zh-Control) | 公式の動画制御重み。Canny、Depth、Pose、MLSDなどのさまざまな制御条件をサポートします。複数の解像度(512、768、1024)での動画予測をサポートし、49フレーム、毎秒8フレームでトレーニングされ、中国語と英語のバイリンガル予測をサポートします。 |
|
||||
| EasyAnimateV5-12b-zh | EasyAnimateV5 | 34 GB | [🤗Link](https://huggingface.co/alibaba-pai/EasyAnimateV5-12b-zh) | [😄Link](https://modelscope.cn/models/PAI/EasyAnimateV5-12b-zh) | 公式のテキストから動画への重み。複数の解像度(512、768、1024)での動画予測をサポートし、49フレーム、毎秒8フレームでトレーニングされ、中国語と英語のバイリンガル予測をサポートします。 |
|
||||
|
||||
<details>
|
||||
<summary>(Obsolete) EasyAnimateV4:</summary>
|
||||
|
||||
| 名前 | 種類 | ストレージスペース | URL | Hugging Face | 説明 |
|
||||
|--|--|--|--|--|--|
|
||||
| EasyAnimateV4-XL-2-InP.tar.gz | EasyAnimateV4 | 解凍前: 8.9 GB / 解凍後: 14.0 GB | [ダウンロード](https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/easyanimate/Diffusion_Transformer/EasyAnimateV4-XL-2-InP.tar.gz) | [🤗Link](https://huggingface.co/alibaba-pai/EasyAnimateV4-XL-2-InP)| 公式のグラフ生成動画モデル。複数の解像度(512、768、1024、1280)での動画予測をサポートし、144フレーム、毎秒24フレームでトレーニングされています。 |
|
||||
</details>
|
||||
|
||||
<details>
|
||||
<summary>(Obsolete) EasyAnimateV3:</summary>
|
||||
|
||||
| 名前 | 種類 | ストレージスペース | URL | Hugging Face | 説明 |
|
||||
|--|--|--|--|--|--|
|
||||
| EasyAnimateV3-XL-2-InP-512x512.tar | EasyAnimateV3 | 18.2GB | [ダウンロード](https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/easyanimate/Diffusion_Transformer/EasyAnimateV3-XL-2-InP-512x512.tar) | [🤗Link](https://huggingface.co/alibaba-pai/EasyAnimateV3-XL-2-InP-512x512) | EasyAnimateV3公式の512x512テキストおよび画像から動画への重み。144フレーム、毎秒24フレームでトレーニングされています。 |
|
||||
| EasyAnimateV3-XL-2-InP-768x768.tar | EasyAnimateV3 | 18.2GB | [ダウンロード](https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/easyanimate/Diffusion_Transformer/EasyAnimateV3-XL-2-InP-768x768.tar) | [🤗Link](https://huggingface.co/alibaba-pai/EasyAnimateV3-XL-2-InP-768x768) | EasyAnimateV3公式の768x768テキストおよび画像から動画への重み。144フレーム、毎秒24フレームでトレーニングされています。 |
|
||||
| EasyAnimateV3-XL-2-InP-960x960.tar | EasyAnimateV3 | 18.2GB | [ダウンロード](https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/easyanimate/Diffusion_Transformer/EasyAnimateV3-XL-2-InP-960x960.tar) | [🤗Link](https://huggingface.co/alibaba-pai/EasyAnimateV3-XL-2-InP-960x960) | EasyAnimateV3公式の960x960テキストおよび画像から動画への重み。144フレーム、毎秒24フレームでトレーニングされています。 |
|
||||
</details>
|
||||
|
||||
<details>
|
||||
<summary>(Obsolete) EasyAnimateV2:</summary>
|
||||
|
||||
| 名前 | 種類 | ストレージスペース | URL | Hugging Face | 説明 |
|
||||
|--|--|--|--|--|--|
|
||||
| EasyAnimateV2-XL-2-512x512.tar | EasyAnimateV2 | 16.2GB | [ダウンロード](https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/easyanimate/Diffusion_Transformer/EasyAnimateV2-XL-2-512x512.tar) | [🤗Link](https://huggingface.co/alibaba-pai/EasyAnimateV2-XL-2-512x512) | EasyAnimateV2公式の512x512解像度の重み。144フレーム、毎秒24フレームでトレーニングされています。 |
|
||||
| EasyAnimateV2-XL-2-768x768.tar | EasyAnimateV2 | 16.2GB | [ダウンロード](https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/easyanimate/Diffusion_Transformer/EasyAnimateV2-XL-2-768x768.tar) | [🤗Link](https://huggingface.co/alibaba-pai/EasyAnimateV2-XL-2-768x768) | EasyAnimateV2公式の768x768解像度の重み。144フレーム、毎秒24フレームでトレーニングされています。 |
|
||||
| easyanimatev2_minimalism_lora.safetensors | Lora of Pixart | 485.1MB | [ダウンロード](https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/easyanimate/Personalized_Model/easyanimatev2_minimalism_lora.safetensors) | - | 特定のタイプの画像でトレーニングされたLora。画像は[URL](https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/easyanimate/asset/v2/Minimalism.zip)からダウンロードできます。 |
|
||||
</details>
|
||||
|
||||
<details>
|
||||
<summary>(Obsolete) EasyAnimateV1:</summary>
|
||||
|
||||
### 1、モーション重み
|
||||
| 名前 | 種類 | ストレージスペース | URL | 説明 |
|
||||
|--|--|--|--|--|
|
||||
| easyanimate_v1_mm.safetensors | モーションモジュール | 4.1GB | [ダウンロード](https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/easyanimate/Motion_Module/easyanimate_v1_mm.safetensors) | 80フレーム、毎秒12フレームでトレーニングされています。 |
|
||||
|
||||
### 2、その他の重み
|
||||
| 名前 | 種類 | ストレージスペース | URL | 説明 |
|
||||
|--|--|--|--|--|
|
||||
| PixArt-XL-2-512x512.tar | Pixart | 11.4GB | [ダウンロード](https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/easyanimate/Diffusion_Transformer/PixArt-XL-2-512x512.tar)| Pixart-Alpha公式の重み。 |
|
||||
| easyanimate_portrait.safetensors | Pixartのチェックポイント | 2.3GB | [ダウンロード](https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/easyanimate/Personalized_Model/easyanimate_portrait.safetensors) | 内部のポートレートデータセットでトレーニングされています。 |
|
||||
| easyanimate_portrait_lora.safetensors | PixartのLora | 654.0MB | [ダウンロード](https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/easyanimate/Personalized_Model/easyanimate_portrait_lora.safetensors)| 内部のポートレートデータセットでトレーニングされています。 |
|
||||
</details>
|
||||
|
||||
# TODOリスト
|
||||
- より大きなパラメータを持つモデルをサポートします。
|
||||
|
||||
# お問い合わせ
|
||||
1. Dingdingを使用してグループ77450006752を検索するか、スキャンして参加します。
|
||||
2. WeChatグループに参加するには画像をスキャンするか、期限切れの場合はこの学生を友達として追加して招待します。
|
||||
|
||||
<img src="https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/easyanimate/asset/group/dd.png" alt="ding group" width="30%"/>
|
||||
<img src="https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/easyanimate/asset/group/wechat.jpg" alt="Wechat group" width="30%"/>
|
||||
<img src="https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/easyanimate/asset/group/person.jpg" alt="Person" width="30%"/>
|
||||
|
||||
|
||||
# 参考文献
|
||||
- magvit: https://github.com/google-research/magvit
|
||||
- PixArt: https://github.com/PixArt-alpha/PixArt-alpha
|
||||
- Open-Sora-Plan: https://github.com/PKU-YuanGroup/Open-Sora-Plan
|
||||
- Open-Sora: https://github.com/hpcaitech/Open-Sora
|
||||
- Animatediff: https://github.com/guoyww/AnimateDiff
|
||||
- ComfyUI-EasyAnimateWrapper: https://github.com/kijai/ComfyUI-EasyAnimateWrapper
|
||||
- HunYuan DiT: https://github.com/tencent/HunyuanDiT
|
||||
|
||||
# ライセンス
|
||||
このプロジェクトは[Apache License (Version 2.0)](https://github.com/modelscope/modelscope/blob/master/LICENSE)の下でライセンスされています。
|
||||
+1
-1
@@ -11,7 +11,7 @@
|
||||
[](https://huggingface.co/spaces/alibaba-pai/EasyAnimate)
|
||||
[](https://discord.gg/UzkpB4Bn)
|
||||
|
||||
[English](./README.md) | 简体中文
|
||||
[English](./README.md) | 简体中文 | [日本語](./README_ja.md)
|
||||
|
||||
# 目录
|
||||
- [目录](#目录)
|
||||
|
||||
Reference in New Issue
Block a user