Compare commits
| Author | SHA1 | Date | |
|---|---|---|---|
 jiangzeyinzi |
c4b4d88e75 | ||
|
jiangzeyinzi
|
043222de49 | ||
|
皓童
|
d7dbdc5292 | ||
|
mcj
|
711c10a68c | ||
|
皓童
|
448cdba522 | ||
|
jiangzeyinzi
|
adda36e39d | ||
|
jiangzeyinzi
|
1da1864993 | ||
|
Great
|
5eac362325 | ||
|
Great
|
9ae3bca43d | ||
|
jiangzeyinzi
|
ca034ef765 | ||
|
皓童
|
2a29446d45 | ||
|
maochaojie
|
cd33b4ab15 | ||
|
maochaojie
|
7d7943fed3 | ||
|
jiangzeyinzi
|
d48b2f110f | ||
|
Great
|
82486adf38 | ||
|
maochaojie
|
a683061c6f | ||
|
mcj
|
4ec0492897 | ||
|
LouieStark
|
aac85fa94f | ||
|
LouieStark
|
3f267aaea2 | ||
|
LouieStark
|
53357f95d6 | ||
|
mcj
|
02c0ba9757 | ||
|
LouieStark
|
cef93bdbfe | ||
|
jiangzeyinzi
|
82132ff3a1 | ||
|
LouieStark
|
b886400e06 | ||
|
mcj
|
73984c4f9e | ||
|
LouieStark
|
f98adabeb3 | ||
|
jiangzeyinzi
|
edb46a615c | ||
|
LouieStark
|
fe3e11b49e | ||
|
LouieStark
|
e6b43f19f6 | ||
|
jiangzeyinzi
|
d9b207cf5b | ||
|
LouieStark
|
986349deac | ||
|
LouieStark
|
3f047be43c | ||
|
LouieStark
|
e8d8e63cba | ||
|
jiangzeyinzi
|
eac03e9856 | ||
|
jiangzeyinzi
|
379b94ab4f | ||
|
jiangzeyinzi
|
342c6b8a15 | ||
|
jiangzeyinzi
|
4ddcb08c7b | ||
|
jiangzeyinzi
|
b2169a1597 | ||
|
jiangzeyinzi
|
cffd54a02a | ||
|
zeyinzi.jzyz
|
0bba2c319d | ||
|
LouieStark
|
7d6451efad | ||
|
LouieStark
|
a5decd17aa | ||
|
jiangzeyinzi
|
8a14866562 | ||
|
jiangzeyinzi
|
5a94f6c4a2 | ||
|
Great
|
4ad0f6038c | ||
|
Great
|
4f56623627 | ||
|
jiangzeyinzi
|
30afc0a1de | ||
|
Great
|
aeabef75b4 | ||
|
jiangzeyinzi
|
9376149415 |
@@ -9,12 +9,12 @@
|
||||
*.bin
|
||||
*.idea
|
||||
*.csv
|
||||
cache
|
||||
build
|
||||
dist
|
||||
dev
|
||||
scepter.egg-info
|
||||
.readthedocs.yml
|
||||
1.9
|
||||
#MANIFEST.in
|
||||
*resources
|
||||
*.ipynb_checkpoints*
|
||||
*.vscode
|
||||
|
||||

|
After Width: | Height: | Size: 74 KiB |

|
After Width: | Height: | Size: 36 KiB |

|
After Width: | Height: | Size: 44 KiB |

|
After Width: | Height: | Size: 140 KiB |

|
After Width: | Height: | Size: 99 KiB |

|
After Width: | Height: | Size: 97 KiB |

|
After Width: | Height: | Size: 48 KiB |

|
After Width: | Height: | Size: 56 KiB |

|
After Width: | Height: | Size: 88 KiB |

|
After Width: | Height: | Size: 97 KiB |

|
After Width: | Height: | Size: 62 KiB |

|
After Width: | Height: | Size: 53 KiB |

|
After Width: | Height: | Size: 378 KiB |
@@ -0,0 +1,163 @@
|
||||
{
|
||||
"last_node_id": 4,
|
||||
"last_link_id": 3,
|
||||
"nodes": [
|
||||
{
|
||||
"id": 2,
|
||||
"type": "PreviewImage",
|
||||
"pos": {
|
||||
"0": 937,
|
||||
"1": 243
|
||||
},
|
||||
"size": {
|
||||
"0": 284.03680419921875,
|
||||
"1": 246
|
||||
},
|
||||
"flags": {
|
||||
"collapsed": false
|
||||
},
|
||||
"order": 2,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "images",
|
||||
"type": "IMAGE",
|
||||
"link": 1
|
||||
}
|
||||
],
|
||||
"outputs": [],
|
||||
"properties": {
|
||||
"Node name for S&R": "PreviewImage"
|
||||
},
|
||||
"widgets_values": []
|
||||
},
|
||||
{
|
||||
"id": 4,
|
||||
"type": "ParameterNode",
|
||||
"pos": {
|
||||
"0": 0,
|
||||
"1": 244
|
||||
},
|
||||
"size": {
|
||||
"0": 311.9849853515625,
|
||||
"1": 236.4765625
|
||||
},
|
||||
"flags": {},
|
||||
"order": 0,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
3
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ParameterNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"ddim",
|
||||
50,
|
||||
5,
|
||||
0.5,
|
||||
"trailing",
|
||||
1024,
|
||||
1024,
|
||||
2024
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 1,
|
||||
"type": "ModelNode",
|
||||
"pos": {
|
||||
"0": 430,
|
||||
"1": 243
|
||||
},
|
||||
"size": {
|
||||
"0": 400,
|
||||
"1": 234
|
||||
},
|
||||
"flags": {},
|
||||
"order": 1,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "parameters",
|
||||
"type": "CONDITIONING",
|
||||
"link": 3,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "mantras",
|
||||
"type": "CONDITIONING",
|
||||
"link": null,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "tuners",
|
||||
"type": "CONDITIONING",
|
||||
"link": null,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "controls",
|
||||
"type": "CONDITIONING",
|
||||
"link": null,
|
||||
"shape": 7
|
||||
}
|
||||
],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "IMAGE",
|
||||
"type": "IMAGE",
|
||||
"links": [
|
||||
1
|
||||
],
|
||||
"slot_index": 0
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ModelNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"SD_XL1.0",
|
||||
"ModelScope",
|
||||
"a cat",
|
||||
""
|
||||
]
|
||||
}
|
||||
],
|
||||
"links": [
|
||||
[
|
||||
1,
|
||||
1,
|
||||
0,
|
||||
2,
|
||||
0,
|
||||
"IMAGE"
|
||||
],
|
||||
[
|
||||
3,
|
||||
4,
|
||||
0,
|
||||
1,
|
||||
0,
|
||||
"CONDITIONING"
|
||||
]
|
||||
],
|
||||
"groups": [],
|
||||
"config": {},
|
||||
"extra": {
|
||||
"ds": {
|
||||
"scale": 0.9229599817706423,
|
||||
"offset": [
|
||||
128.91466506592707,
|
||||
43.07074577975898
|
||||
]
|
||||
}
|
||||
},
|
||||
"version": 0.4
|
||||
}
|
||||

|
After Width: | Height: | Size: 291 KiB |
@@ -0,0 +1,202 @@
|
||||
{
|
||||
"last_node_id": 5,
|
||||
"last_link_id": 4,
|
||||
"nodes": [
|
||||
{
|
||||
"id": 2,
|
||||
"type": "PreviewImage",
|
||||
"pos": {
|
||||
"0": 937,
|
||||
"1": 243
|
||||
},
|
||||
"size": {
|
||||
"0": 284.03680419921875,
|
||||
"1": 246
|
||||
},
|
||||
"flags": {
|
||||
"collapsed": false
|
||||
},
|
||||
"order": 3,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "images",
|
||||
"type": "IMAGE",
|
||||
"link": 1
|
||||
}
|
||||
],
|
||||
"outputs": [],
|
||||
"properties": {
|
||||
"Node name for S&R": "PreviewImage"
|
||||
},
|
||||
"widgets_values": []
|
||||
},
|
||||
{
|
||||
"id": 4,
|
||||
"type": "ParameterNode",
|
||||
"pos": {
|
||||
"0": 0,
|
||||
"1": 244
|
||||
},
|
||||
"size": {
|
||||
"0": 311.9849853515625,
|
||||
"1": 236.4765625
|
||||
},
|
||||
"flags": {},
|
||||
"order": 0,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
3
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ParameterNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"ddim",
|
||||
50,
|
||||
5,
|
||||
0.5,
|
||||
"trailing",
|
||||
1024,
|
||||
1024,
|
||||
2024
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 1,
|
||||
"type": "ModelNode",
|
||||
"pos": {
|
||||
"0": 430,
|
||||
"1": 243
|
||||
},
|
||||
"size": {
|
||||
"0": 400,
|
||||
"1": 234
|
||||
},
|
||||
"flags": {},
|
||||
"order": 2,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "parameters",
|
||||
"type": "CONDITIONING",
|
||||
"link": 3,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "mantras",
|
||||
"type": "CONDITIONING",
|
||||
"link": 4,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "tuners",
|
||||
"type": "CONDITIONING",
|
||||
"link": null,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "controls",
|
||||
"type": "CONDITIONING",
|
||||
"link": null,
|
||||
"shape": 7
|
||||
}
|
||||
],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "IMAGE",
|
||||
"type": "IMAGE",
|
||||
"links": [
|
||||
1
|
||||
],
|
||||
"slot_index": 0
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ModelNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"SD_XL1.0",
|
||||
"ModelScope",
|
||||
"a cat",
|
||||
""
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 5,
|
||||
"type": "MantrasNode",
|
||||
"pos": {
|
||||
"0": 3,
|
||||
"1": 547
|
||||
},
|
||||
"size": {
|
||||
"0": 315,
|
||||
"1": 58
|
||||
},
|
||||
"flags": {},
|
||||
"order": 1,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
4
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "MantrasNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"Flat 2D Art"
|
||||
]
|
||||
}
|
||||
],
|
||||
"links": [
|
||||
[
|
||||
1,
|
||||
1,
|
||||
0,
|
||||
2,
|
||||
0,
|
||||
"IMAGE"
|
||||
],
|
||||
[
|
||||
3,
|
||||
4,
|
||||
0,
|
||||
1,
|
||||
0,
|
||||
"CONDITIONING"
|
||||
],
|
||||
[
|
||||
4,
|
||||
5,
|
||||
0,
|
||||
1,
|
||||
1,
|
||||
"CONDITIONING"
|
||||
]
|
||||
],
|
||||
"groups": [],
|
||||
"config": {},
|
||||
"extra": {
|
||||
"ds": {
|
||||
"scale": 1.0152559799477068,
|
||||
"offset": [
|
||||
58.35814123566077,
|
||||
-65.12749162217047
|
||||
]
|
||||
}
|
||||
},
|
||||
"version": 0.4
|
||||
}
|
||||

|
After Width: | Height: | Size: 230 KiB |
@@ -0,0 +1,242 @@
|
||||
{
|
||||
"last_node_id": 6,
|
||||
"last_link_id": 5,
|
||||
"nodes": [
|
||||
{
|
||||
"id": 2,
|
||||
"type": "PreviewImage",
|
||||
"pos": {
|
||||
"0": 937,
|
||||
"1": 243
|
||||
},
|
||||
"size": {
|
||||
"0": 284.03680419921875,
|
||||
"1": 246
|
||||
},
|
||||
"flags": {
|
||||
"collapsed": false
|
||||
},
|
||||
"order": 4,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "images",
|
||||
"type": "IMAGE",
|
||||
"link": 1
|
||||
}
|
||||
],
|
||||
"outputs": [],
|
||||
"properties": {
|
||||
"Node name for S&R": "PreviewImage"
|
||||
},
|
||||
"widgets_values": []
|
||||
},
|
||||
{
|
||||
"id": 4,
|
||||
"type": "ParameterNode",
|
||||
"pos": {
|
||||
"0": 0,
|
||||
"1": 244
|
||||
},
|
||||
"size": {
|
||||
"0": 311.9849853515625,
|
||||
"1": 236.4765625
|
||||
},
|
||||
"flags": {},
|
||||
"order": 0,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
3
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ParameterNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"ddim",
|
||||
50,
|
||||
5,
|
||||
0.5,
|
||||
"trailing",
|
||||
1024,
|
||||
1024,
|
||||
2024
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 5,
|
||||
"type": "MantrasNode",
|
||||
"pos": {
|
||||
"0": 3,
|
||||
"1": 547
|
||||
},
|
||||
"size": {
|
||||
"0": 315,
|
||||
"1": 58
|
||||
},
|
||||
"flags": {},
|
||||
"order": 1,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
4
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "MantrasNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"Flat 2D Art"
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 1,
|
||||
"type": "ModelNode",
|
||||
"pos": {
|
||||
"0": 430,
|
||||
"1": 243
|
||||
},
|
||||
"size": {
|
||||
"0": 400,
|
||||
"1": 234
|
||||
},
|
||||
"flags": {},
|
||||
"order": 3,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "parameters",
|
||||
"type": "CONDITIONING",
|
||||
"link": 3,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "mantras",
|
||||
"type": "CONDITIONING",
|
||||
"link": 4,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "tuners",
|
||||
"type": "CONDITIONING",
|
||||
"link": 5,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "controls",
|
||||
"type": "CONDITIONING",
|
||||
"link": null,
|
||||
"shape": 7
|
||||
}
|
||||
],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "IMAGE",
|
||||
"type": "IMAGE",
|
||||
"links": [
|
||||
1
|
||||
],
|
||||
"slot_index": 0
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ModelNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"SD_XL1.0",
|
||||
"ModelScope",
|
||||
"a cat",
|
||||
""
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 6,
|
||||
"type": "TunerNode",
|
||||
"pos": {
|
||||
"0": 8,
|
||||
"1": 680
|
||||
},
|
||||
"size": {
|
||||
"0": 315,
|
||||
"1": 82
|
||||
},
|
||||
"flags": {},
|
||||
"order": 2,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
5
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "TunerNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"SD_XL1.0_Pencil Sketch Drawing",
|
||||
1
|
||||
]
|
||||
}
|
||||
],
|
||||
"links": [
|
||||
[
|
||||
1,
|
||||
1,
|
||||
0,
|
||||
2,
|
||||
0,
|
||||
"IMAGE"
|
||||
],
|
||||
[
|
||||
3,
|
||||
4,
|
||||
0,
|
||||
1,
|
||||
0,
|
||||
"CONDITIONING"
|
||||
],
|
||||
[
|
||||
4,
|
||||
5,
|
||||
0,
|
||||
1,
|
||||
1,
|
||||
"CONDITIONING"
|
||||
],
|
||||
[
|
||||
5,
|
||||
6,
|
||||
0,
|
||||
1,
|
||||
2,
|
||||
"CONDITIONING"
|
||||
]
|
||||
],
|
||||
"groups": [],
|
||||
"config": {},
|
||||
"extra": {
|
||||
"ds": {
|
||||
"scale": 0.6934334949441366,
|
||||
"offset": [
|
||||
450.0923948318967,
|
||||
30.783653239467935
|
||||
]
|
||||
}
|
||||
},
|
||||
"version": 0.4
|
||||
}
|
||||

|
After Width: | Height: | Size: 355 KiB |
@@ -0,0 +1,366 @@
|
||||
{
|
||||
"last_node_id": 11,
|
||||
"last_link_id": 9,
|
||||
"nodes": [
|
||||
{
|
||||
"id": 1,
|
||||
"type": "ModelNode",
|
||||
"pos": {
|
||||
"0": 439,
|
||||
"1": 123
|
||||
},
|
||||
"size": {
|
||||
"0": 400,
|
||||
"1": 234
|
||||
},
|
||||
"flags": {},
|
||||
"order": 6,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "parameters",
|
||||
"type": "CONDITIONING",
|
||||
"link": 3,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "mantras",
|
||||
"type": "CONDITIONING",
|
||||
"link": 4,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "tuners",
|
||||
"type": "CONDITIONING",
|
||||
"link": 5,
|
||||
"shape": 7
|
||||
},
|
||||
{
|
||||
"name": "controls",
|
||||
"type": "CONDITIONING",
|
||||
"link": 6,
|
||||
"shape": 7
|
||||
}
|
||||
],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "IMAGE",
|
||||
"type": "IMAGE",
|
||||
"links": [
|
||||
1
|
||||
],
|
||||
"slot_index": 0
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ModelNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"SD_XL1.0",
|
||||
"ModelScope",
|
||||
"a cat",
|
||||
""
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 5,
|
||||
"type": "MantrasNode",
|
||||
"pos": {
|
||||
"0": 13,
|
||||
"1": 336
|
||||
},
|
||||
"size": {
|
||||
"0": 315,
|
||||
"1": 58
|
||||
},
|
||||
"flags": {},
|
||||
"order": 0,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
4
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "MantrasNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"Flat 2D Art"
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 6,
|
||||
"type": "TunerNode",
|
||||
"pos": {
|
||||
"0": 12,
|
||||
"1": 455
|
||||
},
|
||||
"size": {
|
||||
"0": 315,
|
||||
"1": 82
|
||||
},
|
||||
"flags": {},
|
||||
"order": 1,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
5
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "TunerNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"SD_XL1.0_Pencil Sketch Drawing",
|
||||
1
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 11,
|
||||
"type": "NoteNode",
|
||||
"pos": {
|
||||
"0": 845,
|
||||
"1": 506
|
||||
},
|
||||
"size": {
|
||||
"0": 398.3059387207031,
|
||||
"1": 210.83267211914062
|
||||
},
|
||||
"flags": {},
|
||||
"order": 2,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [],
|
||||
"properties": {
|
||||
"Node name for S&R": "NoteNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"This is a sample for quickly setting up ComfyUI using the Scepter open-source library:\n\n1) The first run involves downloading the models. By default, we will automatically pull models from ModelScope. The initial download may take some time, and you can also adjust the model source to change the model address.\n\n2) Currently, it supports various base models, basic settings for some inference hyperparameters, mantra settings, tuning model settings, and conditional generation node.\n\n3) In the future, we will gradually integrate interesting features to enrich the use cases.\n\n"
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 8,
|
||||
"type": "LoadImage",
|
||||
"pos": {
|
||||
"0": 471,
|
||||
"1": 451
|
||||
},
|
||||
"size": {
|
||||
"0": 315,
|
||||
"1": 314
|
||||
},
|
||||
"flags": {},
|
||||
"order": 3,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "IMAGE",
|
||||
"type": "IMAGE",
|
||||
"links": [
|
||||
7
|
||||
]
|
||||
},
|
||||
{
|
||||
"name": "MASK",
|
||||
"type": "MASK",
|
||||
"links": null
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "LoadImage"
|
||||
},
|
||||
"widgets_values": [
|
||||
"cat.jpg",
|
||||
"image"
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 7,
|
||||
"type": "ControlNode",
|
||||
"pos": {
|
||||
"0": 15,
|
||||
"1": 600
|
||||
},
|
||||
"size": {
|
||||
"0": 330,
|
||||
"1": 198
|
||||
},
|
||||
"flags": {},
|
||||
"order": 5,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "source_image",
|
||||
"type": "IMAGE",
|
||||
"link": 7
|
||||
}
|
||||
],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
6
|
||||
]
|
||||
},
|
||||
{
|
||||
"name": "Control Image",
|
||||
"type": "IMAGE",
|
||||
"links": [],
|
||||
"slot_index": 1
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ControlNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"SD_XL1.0_color",
|
||||
"Color",
|
||||
"CenterCrop",
|
||||
1,
|
||||
1024,
|
||||
1024
|
||||
]
|
||||
},
|
||||
{
|
||||
"id": 2,
|
||||
"type": "PreviewImage",
|
||||
"pos": {
|
||||
"0": 959,
|
||||
"1": 121
|
||||
},
|
||||
"size": {
|
||||
"0": 284.03680419921875,
|
||||
"1": 246
|
||||
},
|
||||
"flags": {
|
||||
"collapsed": false
|
||||
},
|
||||
"order": 7,
|
||||
"mode": 0,
|
||||
"inputs": [
|
||||
{
|
||||
"name": "images",
|
||||
"type": "IMAGE",
|
||||
"link": 1
|
||||
}
|
||||
],
|
||||
"outputs": [],
|
||||
"properties": {
|
||||
"Node name for S&R": "PreviewImage"
|
||||
},
|
||||
"widgets_values": []
|
||||
},
|
||||
{
|
||||
"id": 4,
|
||||
"type": "ParameterNode",
|
||||
"pos": {
|
||||
"0": 13,
|
||||
"1": 43
|
||||
},
|
||||
"size": {
|
||||
"0": 311.9849853515625,
|
||||
"1": 236.4765625
|
||||
},
|
||||
"flags": {},
|
||||
"order": 4,
|
||||
"mode": 0,
|
||||
"inputs": [],
|
||||
"outputs": [
|
||||
{
|
||||
"name": "Result",
|
||||
"type": "CONDITIONING",
|
||||
"links": [
|
||||
3
|
||||
]
|
||||
}
|
||||
],
|
||||
"properties": {
|
||||
"Node name for S&R": "ParameterNode"
|
||||
},
|
||||
"widgets_values": [
|
||||
"ddim",
|
||||
50,
|
||||
5,
|
||||
0.5,
|
||||
"trailing",
|
||||
1024,
|
||||
1024,
|
||||
2024
|
||||
]
|
||||
}
|
||||
],
|
||||
"links": [
|
||||
[
|
||||
1,
|
||||
1,
|
||||
0,
|
||||
2,
|
||||
0,
|
||||
"IMAGE"
|
||||
],
|
||||
[
|
||||
3,
|
||||
4,
|
||||
0,
|
||||
1,
|
||||
0,
|
||||
"CONDITIONING"
|
||||
],
|
||||
[
|
||||
4,
|
||||
5,
|
||||
0,
|
||||
1,
|
||||
1,
|
||||
"CONDITIONING"
|
||||
],
|
||||
[
|
||||
5,
|
||||
6,
|
||||
0,
|
||||
1,
|
||||
2,
|
||||
"CONDITIONING"
|
||||
],
|
||||
[
|
||||
6,
|
||||
7,
|
||||
0,
|
||||
1,
|
||||
3,
|
||||
"CONDITIONING"
|
||||
],
|
||||
[
|
||||
7,
|
||||
8,
|
||||
0,
|
||||
7,
|
||||
0,
|
||||
"IMAGE"
|
||||
]
|
||||
],
|
||||
"groups": [],
|
||||
"config": {},
|
||||
"extra": {
|
||||
"ds": {
|
||||
"scale": 0.7627768444385667,
|
||||
"offset": [
|
||||
254.62860058494985,
|
||||
87.05734194144193
|
||||
]
|
||||
}
|
||||
},
|
||||
"version": 0.4
|
||||
}
|
||||

|
After Width: | Height: | Size: 634 KiB |
@@ -0,0 +1,184 @@
|
||||
<p align="center">
|
||||
|
||||
<h2 align="center"><img src="https://raw.githubusercontent.com/ali-vilab/ACE/refs/heads/main/assets/figures/icon.png" height=16> : All-round Creator and Editor Following <br> Instructions via Diffusion Transformer</h2>
|
||||
|
||||
<p align="center">
|
||||
<a href="https://arxiv.org/abs/2410.00086"><img src='https://img.shields.io/badge/arXiv-ACE-red' alt='Paper PDF'></a>
|
||||
<a href='https://ali-vilab.github.io/ace-page'><img src='https://img.shields.io/badge/Project_Page-ACE-blue' alt='Project Page'></a>
|
||||
<a href='https://github.com/modelscope/scepter'><img src='https://img.shields.io/badge/Scepter-ACE-green'></a>
|
||||
<a href='https://huggingface.co/spaces/scepter-studio/ACE-Chat'><img src='https://img.shields.io/badge/%F0%9F%A4%97%20Hugging%20Face-Space-orange'></a>
|
||||
<a href='https://huggingface.co/scepter-studio/ACE-0.6B-512px'><img src='https://img.shields.io/badge/%F0%9F%A4%97%20Hugging%20Face-Model-orange'></a>
|
||||
<a href='https://www.modelscope.cn/models/iic/ACE-0.6B-512px'><img src='https://img.shields.io/badge/ModelScope-Model-purple'></a>
|
||||
<br>
|
||||
<strong>Zhen Han*</strong>
|
||||
·
|
||||
<strong>Zeyinzi Jiang*</strong>
|
||||
·
|
||||
<strong>Yulin Pan*</strong>
|
||||
·
|
||||
<strong>Jingfeng Zhang*</strong>
|
||||
·
|
||||
<strong>Chaojie Mao*</strong>
|
||||
<br>
|
||||
<strong>Chenwei Xie</strong>
|
||||
·
|
||||
<strong>Yu Liu</strong>
|
||||
·
|
||||
<strong>Jingren Zhou</strong>
|
||||
<br>
|
||||
Tongyi Lab, Alibaba Group
|
||||
</p>
|
||||
<table align="center">
|
||||
<tr>
|
||||
<td>
|
||||
<img src="https://raw.githubusercontent.com/ali-vilab/ACE/refs/heads/main/assets/figures/teaser.png">
|
||||
</td>
|
||||
</tr>
|
||||
</table>
|
||||
|
||||
|
||||
## 🚀 Installation
|
||||
Install the necessary packages with `pip`:
|
||||
```bash
|
||||
pip install -r requirements.txt
|
||||
```
|
||||
|
||||
## 🔥 ACE Models
|
||||
| **Model** | **Status** |
|
||||
|:----------------:|:---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------:|
|
||||
| ACE-0.6B-512px | [](https://huggingface.co/spaces/scepter-studio/ACE-Chat)<br>[](https://www.modelscope.cn/models/iic/ACE-0.6B-512px) [](https://huggingface.co/scepter-studio/ACE-0.6B-512px) |
|
||||
| ACE-0.6B-1024px | [](https://huggingface.co/spaces/scepter-studio/ACE-Refiner-Chat)<br>[](https://www.modelscope.cn/models/iic/ACE-0.6B-1024px) [](https://huggingface.co/scepter-studio/ACE-0.6B-1024px) | |
|
||||
## 🖼 Model Performance Visualization
|
||||
|
||||
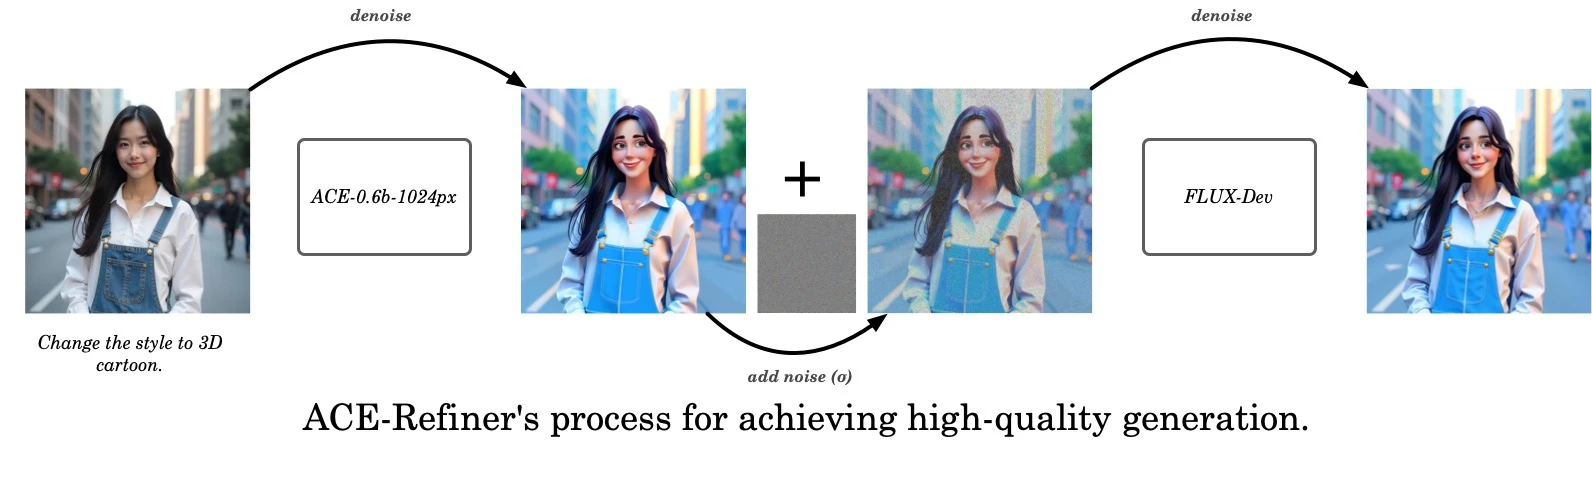
The current model's parameters scale of ACE is 0.6B, which imposes certain limitations on the quality of image generation. [FLUX.1-Dev](https://huggingface.co/black-forest-labs/FLUX.1-dev), on the other hand,
|
||||
has a significant advantage in text-to-image generation quality. By using SDEdit, we can effectively leverage the generative capabilities of FLUX to further enhance the image results generated by ACE. Based on the above considerations, we have designed the ACE-Refiner pipeline, as shown in the diagram below.
|
||||
|
||||
|
||||
|
||||
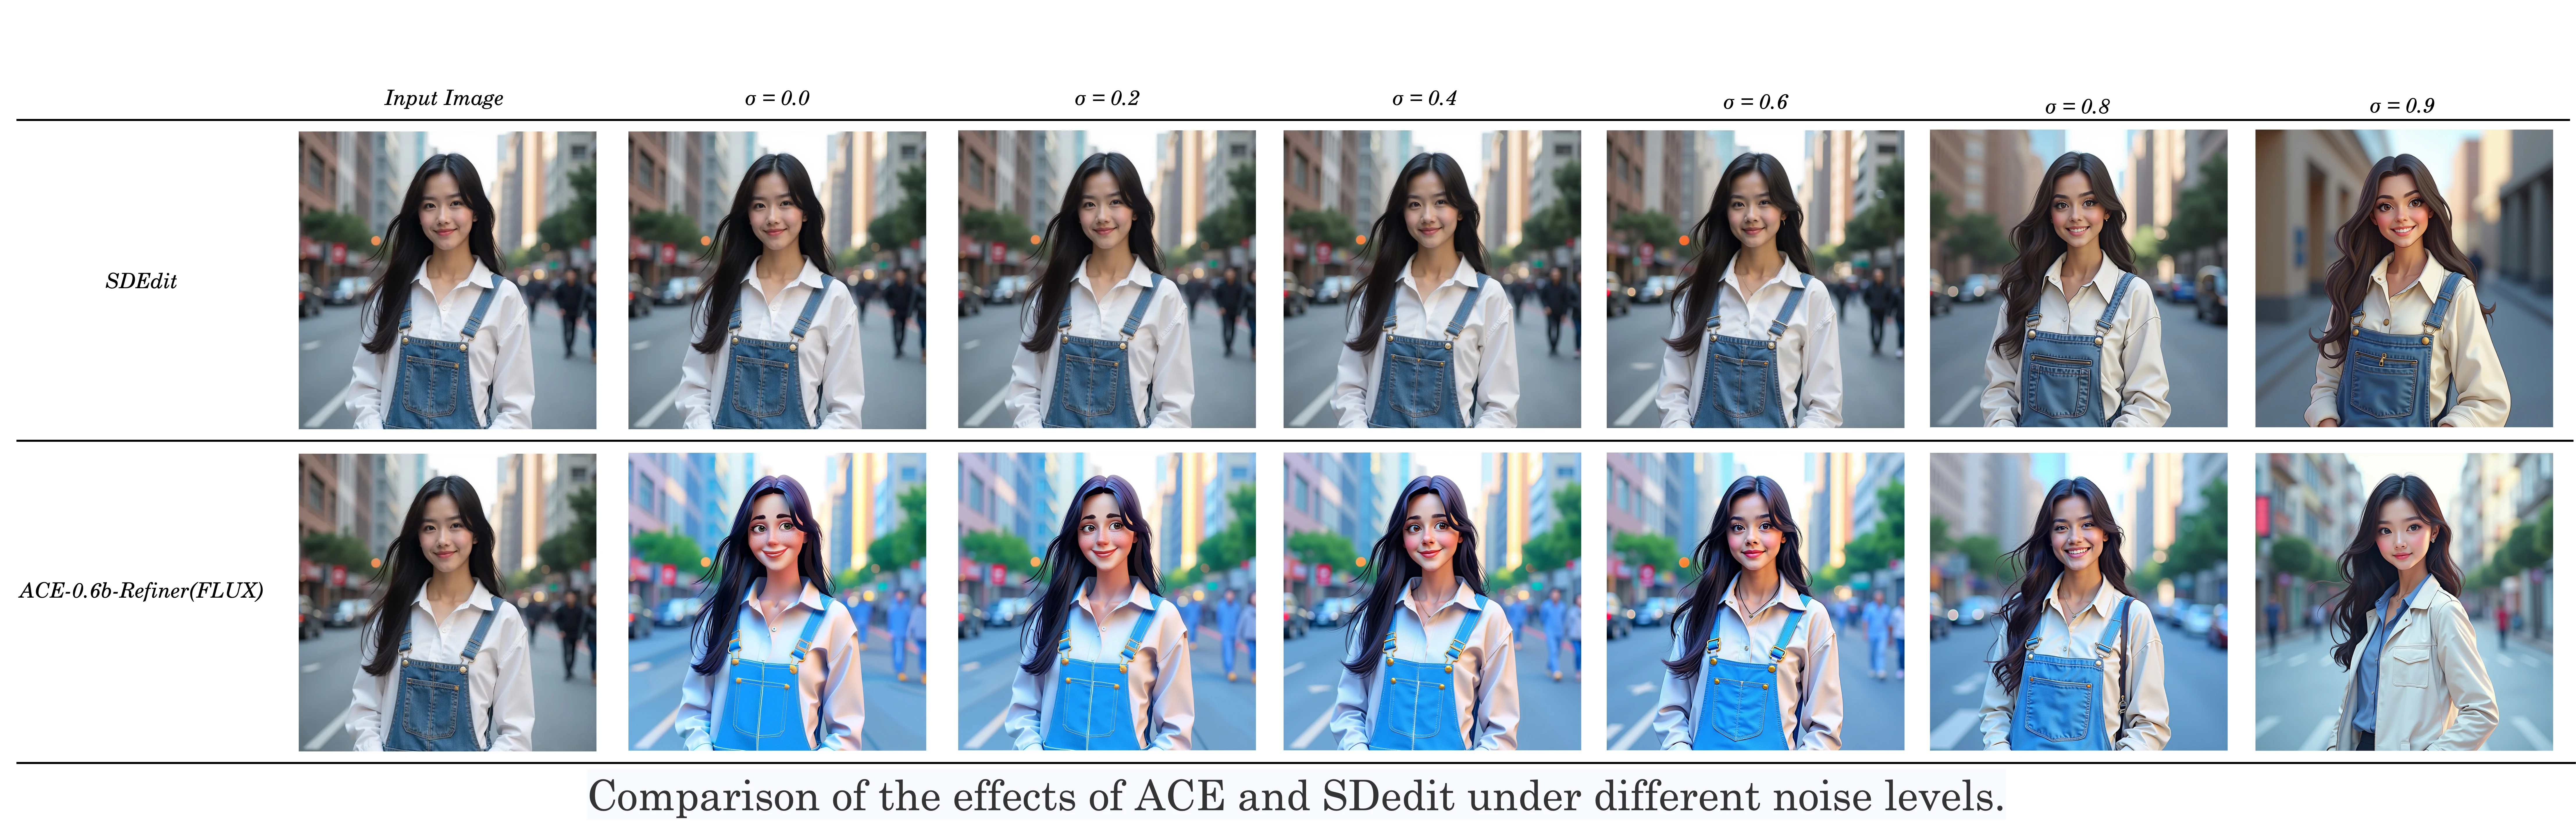
As shown in the figure below, when the strength
|
||||
σ of the generated image is high, the generated image will suffer from fidelity loss compared to the original image. Conversely, lower
|
||||
σ does not significantly improve the image quality. Therefore, users can make a trade-off between fidelity to the generated result and the image quality based on their own needs.
|
||||
Users can set the value of "REFINER_SCALE" in the configuration file `config/inference_config/models/ace_0.6b_1024_refiner.yaml`.
|
||||
We recommend that users use the advance options in the [webui-demo](#-chat-bot-) for effect verification.
|
||||
|
||||
|
||||
|
||||
|
||||
We compared the generation and editing performance of different models on several tasks, as shown as following.
|
||||
|
||||
|
||||
|
||||
## 🔥 Training
|
||||
|
||||
We offer a demonstration training YAML that enables the end-to-end training of ACE using a toy dataset. For a comprehensive overview of the hyperparameter configurations, please consult `config/ace_0.6b_512_train.yaml`.
|
||||
|
||||
### Prepare datasets
|
||||
|
||||
Please find the dataset class located in `modules/data/dataset/dataset.py`,
|
||||
designed to facilitate end-to-end training using an open-source toy dataset.
|
||||
Download a dataset zip file from [modelscope](https://www.modelscope.cn/models/iic/scepter/resolve/master/datasets/hed_pair.zip), and then extract its contents into the `cache/datasets/` directory.
|
||||
|
||||
Should you wish to prepare your own datasets, we recommend consulting `modules/data/dataset/dataset.py` for detailed guidance on the required data format.
|
||||
|
||||
### Prepare initial weight
|
||||
The ACE checkpoint has been uploaded to both ModelScope and HuggingFace platforms:
|
||||
* [ModelScope](https://www.modelscope.cn/models/iic/ACE-0.6B-512px)
|
||||
* [HuggingFace](https://huggingface.co/scepter-studio/ACE-0.6B-512px)
|
||||
|
||||
In the provided training YAML configuration, we have designated the Modelscope URL as the default checkpoint URL. Should you wish to transition to Hugging Face, you can effortlessly achieve this by modifying the PRETRAINED_MODEL value within the YAML file (replace the prefix "ms://iic" to "hf://scepter-studio").
|
||||
|
||||
|
||||
### Start training
|
||||
|
||||
You can easily start training procedure by executing the following command:
|
||||
```bash
|
||||
# ACE-0.6B-512px
|
||||
PYTHONPATH=. python tools/run_train.py --cfg config/ace_0.6b_512_train.yaml
|
||||
# ACE-0.6B-1024px
|
||||
PYTHONPATH=. python tools/run_train.py --cfg config/ace_0.6b_1024_train.yaml
|
||||
```
|
||||
|
||||
## 🚀 Inference
|
||||
|
||||
We provide a simple inference demo that allows users to generate images from text descriptions.
|
||||
```bash
|
||||
PYTHONPATH=. python tools/run_inference.py --cfg config/inference_config/models/ace_0.6b_512.yaml --instruction "make the boy cry, his eyes filled with tears" --seed 199999 --input_image examples/input_images/example0.webp
|
||||
```
|
||||
We recommend runing the examples for quick testing. Running the following command will run the example inference and the results will be saved in `examples/output_images/`.
|
||||
```bash
|
||||
PYTHONPATH=. python tools/run_inference.py --cfg config/inference_config/models/ace_0.6b_512.yaml
|
||||
```
|
||||
|
||||
## 💬 Chat Bot
|
||||
We have developed an chatbot UI utilizing Gradio, designed to transform user input in natural language into visually stunning images that align semantically with the provided instructions. Users can effortlessly initiate the chatbot app by executing the following command:
|
||||
```bash
|
||||
python chatbot/run_gradio.py --cfg chatbot/config/chatbot_ui.yaml --server_port 2024
|
||||
```
|
||||
|
||||
<table align="center">
|
||||
<tr>
|
||||
<td>
|
||||
<img src="https://raw.githubusercontent.com/ali-vilab/ACE/refs/heads/main/assets/videos/demo_chat.gif">
|
||||
</td>
|
||||
</tr>
|
||||
</table>
|
||||
|
||||
## ⚙️️ ComfyUI Workflow
|
||||
|
||||
|
||||
|
||||
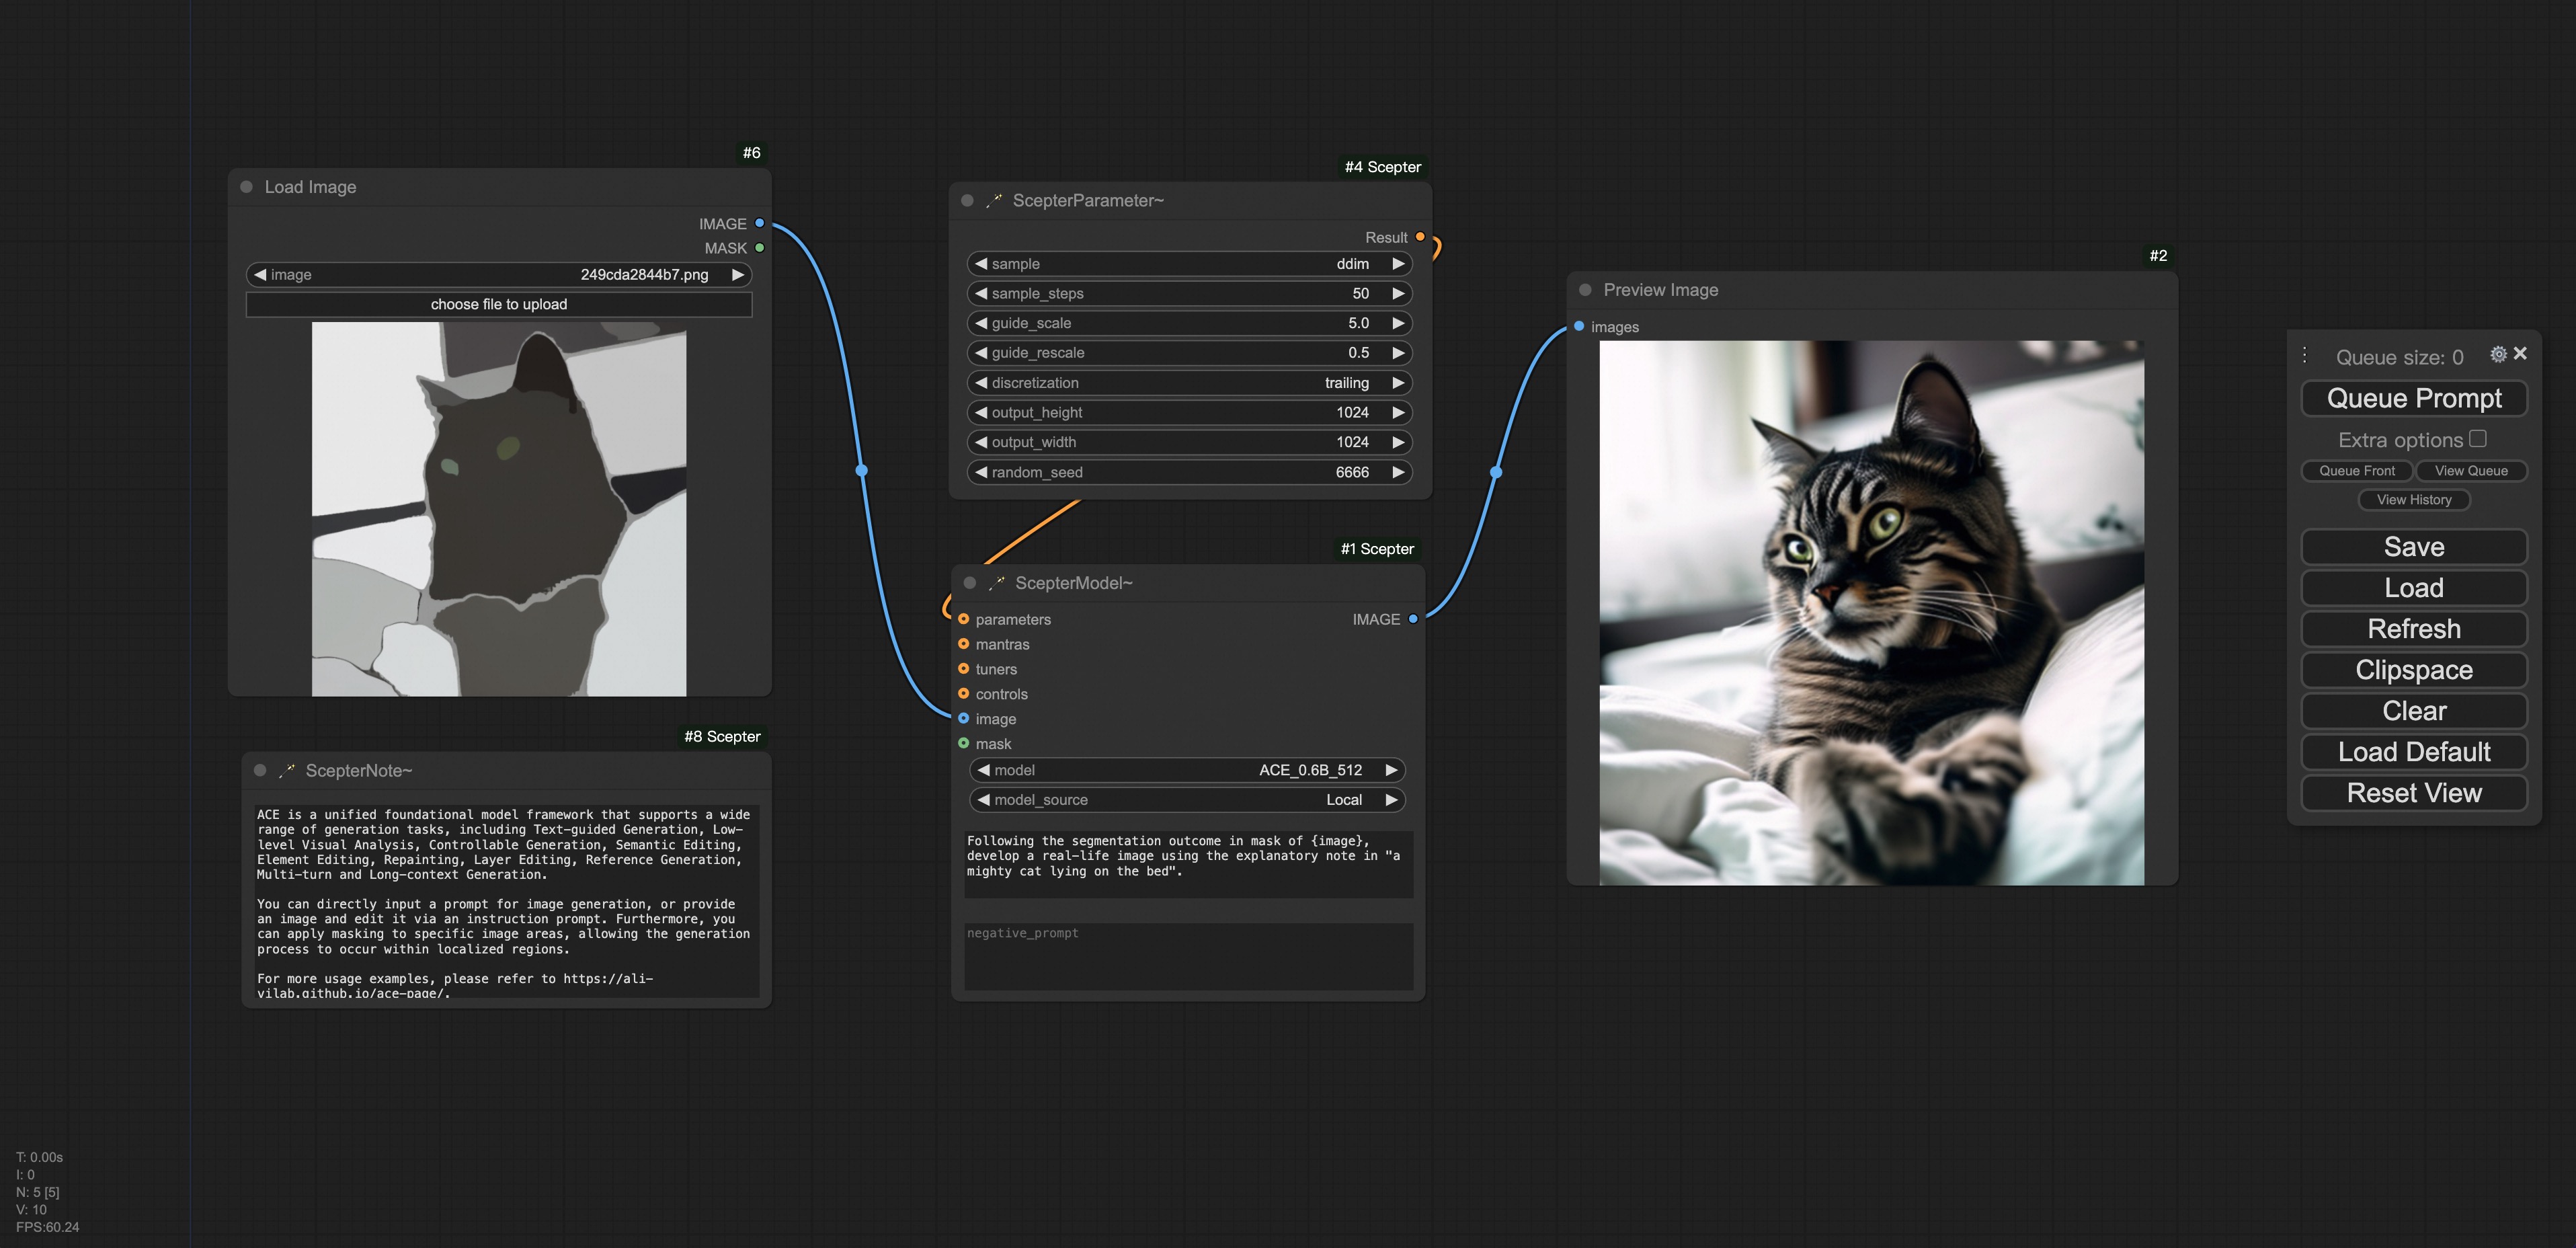
We support the use of ACE in the ComfyUI Workflow through the following methods:
|
||||
|
||||
1) Automatic installation directly via the ComfyUI Manager by searching for the **ComfyUI-Scepter** node.
|
||||
2) Manually install by moving custom_nodes from Scepter to ComfyUI.
|
||||
```shell
|
||||
git clone https://github.com/modelscope/scepter.git
|
||||
cd path/to/scepter
|
||||
pip install -e .
|
||||
cp -r path/to/scepter/workflow/ path/to/ComfyUI/custom_nodes/ComfyUI-Scepter
|
||||
cd path/to/ComfyUI
|
||||
python main.py
|
||||
```
|
||||
|
||||
**Note**: You can use the nodes by dragging the sample images below into ComfyUI. Additionally, our nodes can automatically pull models from ModelScope or HuggingFace by selecting the *model_source* field, or you can place the already downloaded models in a local path.
|
||||
|
||||
<table><tbody>
|
||||
<tr>
|
||||
<th align="center" colspan="4">ACE Workflow Examples</th>
|
||||
</tr>
|
||||
<tr>
|
||||
<th align="center" colspan="1">Control</th>
|
||||
<th align="center" colspan="1">Semantic</th>
|
||||
<th align="center" colspan="1">Element</th>
|
||||
</tr>
|
||||
<tr>
|
||||
<td>
|
||||
<a href="https://raw.githubusercontent.com/ali-vilab/ACE/refs/heads/main/assets/comfyui/ace_control.png" target="_blank">
|
||||
<img src="https://raw.githubusercontent.com/ali-vilab/ACE/refs/heads/main/assets/comfyui/ace_control.png" width="200">
|
||||
</a>
|
||||
</td>
|
||||
<td>
|
||||
<a href="https://raw.githubusercontent.com/ali-vilab/ACE/refs/heads/main/assets/comfyui/ace_semantic.png" target="_blank">
|
||||
<img src="https://raw.githubusercontent.com/ali-vilab/ACE/refs/heads/main/assets/comfyui/ace_semantic.png" width="200">
|
||||
</a>
|
||||
</td>
|
||||
<td>
|
||||
<a href="https://raw.githubusercontent.com/ali-vilab/ACE/refs/heads/main/assets/comfyui/ace_element.png" target="_blank">
|
||||
<img src="https://raw.githubusercontent.com/ali-vilab/ACE/refs/heads/main/assets/comfyui/ace_element.png" width="200">
|
||||
</a>
|
||||
</td>
|
||||
</tr>
|
||||
</tbody>
|
||||
</table>
|
||||
|
||||
|
||||
## 📝 Citation
|
||||
|
||||
```bibtex
|
||||
@article{han2024ace,
|
||||
title={ACE: All-round Creator and Editor Following Instructions via Diffusion Transformer},
|
||||
author={Han, Zhen and Jiang, Zeyinzi and Pan, Yulin and Zhang, Jingfeng and Mao, Chaojie and Xie, Chenwei and Liu, Yu and Zhou, Jingren},
|
||||
journal={arXiv preprint arXiv:2410.00086},
|
||||
year={2024}
|
||||
}
|
||||
```
|
||||
@@ -0,0 +1,22 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
import os
|
||||
import shutil
|
||||
import subprocess
|
||||
import sys
|
||||
|
||||
if sys.argv[0] == 'install.py':
|
||||
sys.path.append('.') # for portable version
|
||||
|
||||
source_folder = os.path.join(os.path.dirname(__file__), "scepter/workflow")
|
||||
current_dir = os.path.dirname(__file__)
|
||||
destination_folder = os.path.join(os.path.dirname(current_dir), "ComfyUI-Scepter")
|
||||
|
||||
if not os.path.exists(destination_folder):
|
||||
shutil.copytree(source_folder, destination_folder)
|
||||
print(f"{os.path.abspath(source_folder)} copy to {os.path.abspath(destination_folder)} success!")
|
||||
else:
|
||||
print(f"{os.path.abspath(destination_folder)} exist.")
|
||||
|
||||
# pip install scepter
|
||||
subprocess.check_call([sys.executable, '-m', 'pip', 'install', 'scepter'])
|
||||
@@ -14,10 +14,16 @@ SCEPTER integrates popular community-driven implementations as well as proprieta
|
||||
SCEPTER offers 3 core components:
|
||||
- [Generative training and inference framework](#tutorials)
|
||||
- [Easy implementation of popular approaches](#currently-supported-approaches)
|
||||
- [Interactive user interface: SCEPTER Studio](#launch)
|
||||
- [Interactive user interface: SCEPTER Studio & Comfy UI](#launch)
|
||||
|
||||
|
||||
## 🎉 News
|
||||
- [🔥🔥🔥 2025.01]: We report ACE++, an instruction-based diffusion framework that tackles various image generation and editing tasks. The code and paper is available on [ACE++](https://ali-vilab.github.io/ACE_plus_page/).
|
||||
- [2024.11]: Supports video files, video annotation, caption translation in data management, and inference & training of the [CogVideoX](https://arxiv.org/abs/2408.06072).
|
||||
- [2024.10]: We are pleased to announce the release of the code for [ACE](https://arxiv.org/abs/2410.00086), supporting Customized Training / Comfy UI Workflow / gradio-based ChatBot Interface.
|
||||
- [2024.10]: Support for inference and tuning with [FLUX](https://huggingface.co/black-forest-labs/FLUX.1-dev), as well as for building [ComfyUI](https://github.com/comfyanonymous/ComfyUI) workflows using this framework.
|
||||
- [2024.09]: We introduce **ACE**, an **A**ll-round **C**reator and **E**ditor adept at executing a diverse array of image editing tasks tailored to your specifications. Built upon the cutting-edge Diffusion Transformer architecture, ACE has been extensively trained on a comprehensive dataset to seamlessly interpret and execute any natural language instruction. For further information, please consult the [project page](https://ali-vilab.github.io/ace-page/).
|
||||
- [2024.07]: Support the inference and training of open-source generative models based on the [DiT](https://arxiv.org/abs/2212.09748) architecture, such as [SD3](https://arxiv.org/pdf/2403.03206) and [PixArt](https://arxiv.org/abs/2310.00426).
|
||||
- [2024.05]: Introducing SCEPTER v1, supporting customized image edit tasks! Simply provide 10 image pairs, SCEPTER will tune an edit tuner for your own Image-to-Image tasks, like `Clay Style`, `De-Text`, `Segmentation`, etc.
|
||||
- [2024.04]: New [StyleBooth](https://ali-vilab.github.io/stylebooth-page/) demo on SCEPTER Studio for`Text-Based Style Editing`.
|
||||
- [2024.03]: We optimize the training UI and checkpoint management. New [LAR-Gen](https://arxiv.org/abs/2403.19534) model has been added on SCEPTER Studio, supporting `zoom-out`, `virtual try on`, `inpainting`.
|
||||
@@ -27,48 +33,105 @@ SCEPTER offers 3 core components:
|
||||
- [2023.12]: We propose [SCEdit](https://arxiv.org/abs/2312.11392), an efficient and controllable generation framework.
|
||||
- [2023.12]: We release [🪄SCEPTER](https://github.com/modelscope/scepter/) library.
|
||||
|
||||
[//]: # (## 🖼 Gallery for Recent Works)
|
||||
|
||||
## 🖼 Gallery for Recent Works
|
||||
[//]: # ()
|
||||
[//]: # (### FLUX Tuners)
|
||||
|
||||
### Edit Tuners
|
||||
[//]: # ()
|
||||
[//]: # (<table><tbody>)
|
||||
|
||||
Simply provide 10 image pairs, SCEPTER will tune an edit tuner for your own Image-to-Image tasks, like `Clay Style`, `De-Text`, `Segmentation`, etc.
|
||||
Try our official few-shot datasets: [De-Text](https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=datasets%2Fdetext.zip), [Image2Hed](https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=datasets%2Fhed_pair.zip), [Image2Depth](https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=datasets%2Fimage2depth.zip), [Depth2Image](https://www.modelscope.cn/api/v1/models/iic/scepter/repo?Revision=master&FilePath=datasets%2Fdepth2image.zip).
|
||||
[//]: # ( <tr>)
|
||||
|
||||
[//]: # ( <th align="center" colspan="3">Yarn Style</th>)
|
||||
|
||||
[//]: # ( <th align="center" colspan="3">Soft Watercolor Style</th>)
|
||||
|
||||
[//]: # ( </tr>)
|
||||
|
||||
[//]: # ( <tr>)
|
||||
|
||||
[//]: # ( <td><img src="asset/images/flux_tuner/flux_tuner_2_1.webp" width="200"></td>)
|
||||
|
||||
[//]: # ( <td><img src="asset/images/flux_tuner/flux_tuner_2_2.webp" width="200"></td>)
|
||||
|
||||
[//]: # ( <td><img src="asset/images/flux_tuner/flux_tuner_2_3.webp" width="200"></td>)
|
||||
|
||||
[//]: # ( <td><img src="asset/images/flux_tuner/flux_tuner_1_1.webp" width="200"></td>)
|
||||
|
||||
[//]: # ( <td><img src="asset/images/flux_tuner/flux_tuner_1_2.webp" width="200"></td>)
|
||||
|
||||
[//]: # ( <td><img src="asset/images/flux_tuner/flux_tuner_1_3.webp" width="200"></td>)
|
||||
|
||||
[//]: # ( </tr>)
|
||||
|
||||
[//]: # ( <tr>)
|
||||
|
||||
[//]: # ( <th align="center" colspan="3">Travel Style</th>)
|
||||
|
||||
[//]: # ( <th align="center" colspan="3">WuKong Style</th>)
|
||||
|
||||
[//]: # ( </tr>)
|
||||
|
||||
[//]: # ( <tr>)
|
||||
|
||||
[//]: # ( <td><img src="asset/images/flux_tuner/flux_tuner_3_1.webp" width="200"></td>)
|
||||
|
||||
[//]: # ( <td><img src="asset/images/flux_tuner/flux_tuner_3_2.webp" width="200"></td>)
|
||||
|
||||
[//]: # ( <td><img src="asset/images/flux_tuner/flux_tuner_3_3.webp" width="200"></td>)
|
||||
|
||||
[//]: # ( <td><img src="asset/images/flux_tuner/flux_tuner_4_1.webp" width="200"></td>)
|
||||
|
||||
[//]: # ( <td><img src="asset/images/flux_tuner/flux_tuner_4_2.webp" width="200"></td>)
|
||||
|
||||
[//]: # ( <td><img src="asset/images/flux_tuner/flux_tuner_4_3.webp" width="200"></td>)
|
||||
|
||||
[//]: # ( </tr>)
|
||||
|
||||
[//]: # (</tbody>)
|
||||
|
||||
[//]: # (</table>)
|
||||
|
||||
### ComfyUI Workflow
|
||||
|
||||

|
||||
|
||||
<table><tbody>
|
||||
<tr>
|
||||
<th align="center" colspan="4">Clay Style<br>Prompt: "Convert this image into clay style"</th>
|
||||
<th align="center" colspan="4">Example Workflow Case</th>
|
||||
</tr>
|
||||
<tr>
|
||||
<td><img src="asset/images/edit_tuner/vermeer.jpeg" width="300"></td>
|
||||
<td><img src="asset/images/edit_tuner/clay_vermeer.jpeg" width="300"></td>
|
||||
<td><img src="asset/images/edit_tuner/cat_512.jpg" width="300"></td>
|
||||
<td><img src="asset/images/edit_tuner/clay_cat.jpeg" width="300"></td>
|
||||
<th align="center" colspan="1">Base</th>
|
||||
<th align="center" colspan="1">+Mantra</th>
|
||||
<th align="center" colspan="1">+Tuner</th>
|
||||
<th align="center" colspan="1">+Control</th>
|
||||
</tr>
|
||||
<tr>
|
||||
<th align="center" colspan="2">De-Text<br>Prompt: "Remove the texts"</th>
|
||||
<th align="center" colspan="2">Image2Hed<br>Prompt: "Convert to an edge map"</th>
|
||||
</tr>
|
||||
<tr>
|
||||
<td><img src="asset/images/edit_tuner/text.jpg" width="300"></td>
|
||||
<td><img src="asset/images/edit_tuner/detext.jpeg" width="300"></td>
|
||||
<td><img src="asset/images/edit_tuner/cat_512.jpg" width="300"></td>
|
||||
<td><img src="asset/images/edit_tuner/hed.jpeg" width="300"></td>
|
||||
</tr>
|
||||
<tr>
|
||||
<th align="center" colspan="2">Image2Depth<br>Prompt: "Calculate the depth map"</th>
|
||||
<th align="center" colspan="2">Depth2Image<br>Prompt: "Convert depth map into color image"</th>
|
||||
</tr>
|
||||
<tr>
|
||||
<td><img src="asset/images/edit_tuner/house.jpg" width="300"></td>
|
||||
<td><img src="asset/images/edit_tuner/image2depth.jpeg" width="300"></td>
|
||||
<td><img src="asset/images/edit_tuner/depth.jpg" width="300"></td>
|
||||
<td><img src="asset/images/edit_tuner/depth2image.jpeg" width="300"></td>
|
||||
<td>
|
||||
<a href="asset/workflow/sdxl_base.json" target="_blank">
|
||||
<img src="asset/workflow/sdxl_base.jpg" width="200">
|
||||
</a>
|
||||
</td>
|
||||
<td>
|
||||
<a href="asset/workflow/sdxl_base_mantra.json" target="_blank">
|
||||
<img src="asset/workflow/sdxl_base_mantra.jpg" width="200">
|
||||
</a>
|
||||
</td>
|
||||
<td>
|
||||
<a href="asset/workflow/sdxl_base_mantra_tuner.json" target="_blank">
|
||||
<img src="asset/workflow/sdxl_base_mantra_tuner.jpg" width="200">
|
||||
</a>
|
||||
</td>
|
||||
<td>
|
||||
<a href="asset/workflow/sdxl_base_mantra_tuner_control.json" target="_blank">
|
||||
<img src="asset/workflow/sdxl_base_mantra_tuner_control.jpg" width="200">
|
||||
</a>
|
||||
</td>
|
||||
</tr>
|
||||
</tbody>
|
||||
</table>
|
||||
Note: Left image is input and right image is output.
|
||||
|
||||
|
||||
## 🛠️ Installation
|
||||
|
||||
@@ -102,16 +165,19 @@ pip install scepter
|
||||
|
||||
### Currently supported approaches
|
||||
|
||||
| Tasks | Methods | Links |
|
||||
|:----------------------------:|:--------------------------------------------:|:------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
|
||||
| Text-to-image generation | SD v1.5 | [](https://huggingface.co/runwayml/stable-diffusion-v1-5) |
|
||||
| Text-to-image generation | SD v2.1 | [](https://huggingface.co/runwayml/stable-diffusion-v1-5) |
|
||||
| Text-to-image generation | SD-XL | [](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0) |
|
||||
| Efficient Tuning | LoRA | [](https://arxiv.org/abs/2106.09685) |
|
||||
| Efficient Tuning | Res-Tuning(NeurIPS23) | [](https://arxiv.org/abs/2310.19859) [](https://res-tuning.github.io/) |
|
||||
| Controllable image synthesis | [🌟SCEdit(CVPR24)](docs/en/tasks/scedit.md) | [](https://arxiv.org/abs/2312.11392) [](https://scedit.github.io/) |
|
||||
| Image editing | [🌟LAR-Gen](docs/en/tasks/largen.md) | [](https://arxiv.org/abs/2403.19534) [](https://ali-vilab.github.io/largen-page/) |
|
||||
| Image editing | [🌟StyleBooth](docs/en/tasks/stylebooth.md) | [](https://arxiv.org/abs/2404.12154) [](https://ali-vilab.github.io/stylebooth-page/) |
|
||||
| Tasks | Methods | Links |
|
||||
|:----------------------------:|:------------------------------------------------:|:------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
|
||||
| Text-to-image Generation | SD v1.5 | [](https://huggingface.co/runwayml/stable-diffusion-v1-5) |
|
||||
| Text-to-image Generation | SD v2.1 | [](https://huggingface.co/runwayml/stable-diffusion-v1-5) |
|
||||
| Text-to-image Generation | SD-XL | [](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0) |
|
||||
| Text-to-image Generation | FLUX | [](https://huggingface.co/black-forest-labs/FLUX.1-dev) |
|
||||
| Efficient Tuning | LoRA | [](https://arxiv.org/abs/2106.09685) |
|
||||
| Efficient Tuning | Res-Tuning(NeurIPS23) | [](https://arxiv.org/abs/2310.19859) [](https://res-tuning.github.io/) |
|
||||
| Controllable Image Synthesis | [🌟SCEdit(CVPR24)](docs/en/tasks/scedit.md) | [](https://arxiv.org/abs/2312.11392) [](https://scedit.github.io/) |
|
||||
| Image Editing | [🌟LAR-Gen](docs/en/tasks/largen.md) | [](https://arxiv.org/abs/2403.19534) [](https://ali-vilab.github.io/largen-page/) |
|
||||
| Image Editing | [🌟StyleBooth](docs/en/tasks/stylebooth.md) | [](https://arxiv.org/abs/2404.12154) [](https://ali-vilab.github.io/stylebooth-page/) |
|
||||
| Image Generation and Editing | [🌟ACE](https://ali-vilab.github.io/ace-page/) | [](https://arxiv.org/abs/2410.00086) [](https://ali-vilab.github.io/ace-page/) [](https://huggingface.co/spaces/scepter-studio/ACE-Chat) <br> [](https://www.modelscope.cn/models/iic/ACE-0.6B-512px) [](https://huggingface.co/scepter-studio/ACE-0.6B-512px) |
|
||||
| Image Generation and Editing | [🌟ACE++](https://ali-vilab.github.io/ACE_plus_page/) | [](https://arxiv.org/abs/2501.02487) [](https://ali-vilab.github.io/ACE_plus_page/) [](https://huggingface.co/spaces/scepter-studio/ACE-Plus) <br> [](https://www.modelscope.cn/models/iic/ACE_Plus/summary) [](https://huggingface.co/ali-vilab/ACE_Plus/tree/main) |
|
||||
|
||||
|
||||
## 🖥️ SCEPTER Studio
|
||||
@@ -145,6 +211,24 @@ Therefore, subsequent startups will become much faster (about one minute) as dow
|
||||
We deploy a work studio on Modelscope that includes only the inference tab, please refer to [ms_scepter_studio](https://www.modelscope.cn/studios/iic/scepter_studio/summary) and [hf_scepter_studio](https://huggingface.co/spaces/modelscope/scepter_studio)
|
||||
|
||||
|
||||
|
||||
## ⚙️️ ComfyUI Workflow
|
||||
|
||||
We support the use of all models in the ComfyUI Workflow through the following methods:
|
||||
|
||||
1) Automatic installation directly via the ComfyUI Manager by searching for the **ComfyUI-Scepter** node.
|
||||
2) Manually install by moving custom_nodes from Scepter to ComfyUI.
|
||||
```shell
|
||||
git clone https://github.com/modelscope/scepter.git
|
||||
cd path/to/scepter
|
||||
pip install -e .
|
||||
cp -r path/to/scepter/workflow/ path/to/ComfyUI/custom_nodes/ComfyUI-Scepter
|
||||
cd path/to/ComfyUI
|
||||
python main.py
|
||||
```
|
||||
|
||||
**Note**: You can use the nodes by dragging the sample images into ComfyUI. Additionally, our nodes can automatically pull models from ModelScope or HuggingFace by selecting the *model_source* field, or you can place the already downloaded models in a local path.
|
||||
|
||||
## 🔍 Learn More
|
||||
|
||||
- [Alibaba TongYi Vision Intelligence Lab](https://github.com/ali-vilab)
|
||||
@@ -177,4 +261,4 @@ This project is licensed under the [Apache License (Version 2.0)](https://github
|
||||
|
||||
|
||||
## Acknowledgement
|
||||
Thanks to [Stability-AI](https://github.com/Stability-AI), [SWIFT library](https://github.com/modelscope/swift/) and [Fooocus](https://github.com/lllyasviel/Fooocus) for their awesome work.
|
||||
Thanks to [Stability-AI](https://github.com/Stability-AI), [SWIFT library](https://github.com/modelscope/swift/), [Fooocus](https://github.com/lllyasviel/Fooocus) and [ComfyUI](https://github.com/comfyanonymous/ComfyUI) for their awesome work.
|
||||
|
||||
@@ -2,8 +2,8 @@ albumentations
|
||||
beautifulsoup4
|
||||
bezier
|
||||
einops
|
||||
modelscope==1.14.0
|
||||
ms-swift>=2.0.1
|
||||
modelscope[framework]
|
||||
ms-swift
|
||||
numpy
|
||||
open_clip_torch
|
||||
opencv-python
|
||||
@@ -12,5 +12,7 @@ oss2>=2.15.0
|
||||
pycocotools
|
||||
pyyaml>=5.3.1
|
||||
scikit-image
|
||||
scikit-learn
|
||||
sentencepiece
|
||||
torchsde
|
||||
transformers
|
||||
|
||||
@@ -1,4 +1,5 @@
|
||||
git+https://github.com/cocodataset/panopticapi.git
|
||||
torch==2.0.1
|
||||
torchvision==0.15.2
|
||||
xformers==0.0.21
|
||||
torch==2.4.1
|
||||
torchvision==.19.1
|
||||
flash-attn==2.5.8
|
||||
xformers==0.0.28
|
||||
@@ -1,5 +1,6 @@
|
||||
bitsandbytes
|
||||
gradio
|
||||
gradio_imageslider
|
||||
imagehash
|
||||
psutil
|
||||
tiktoken
|
||||
|
||||
@@ -1,18 +1,28 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
import os
|
||||
from typing import TYPE_CHECKING
|
||||
from scepter.modules.utils.import_utils import LazyImportModule
|
||||
|
||||
import scepter
|
||||
from scepter.modules import data, model, opt, solver, transform, utils
|
||||
from scepter.tools.helper import get_module_list as module_list
|
||||
from scepter.tools.helper import \
|
||||
get_module_object_config as configures_by_objects
|
||||
from scepter.tools.helper import get_module_objects as objects_by_module
|
||||
from scepter.version import __version__, version_info
|
||||
|
||||
dirname = os.path.dirname(scepter.__file__)
|
||||
if TYPE_CHECKING:
|
||||
from scepter.modules import data, model, opt, solver, transform, utils
|
||||
from scepter.tools.helper import get_module_list as module_list
|
||||
from scepter.tools.helper import \
|
||||
get_module_object_config as configures_by_objects
|
||||
from scepter.tools.helper import get_module_objects as objects_by_module
|
||||
from scepter.version import __version__, version_info
|
||||
else:
|
||||
_import_structure = {
|
||||
'modules': ['data', 'model', 'opt', 'solver', 'transform', 'utils'],
|
||||
'helper': ['get_module_list', 'get_module_object_config', 'get_module_objects'],
|
||||
'version': ['__version__', 'version_info']
|
||||
}
|
||||
|
||||
__all__ = [
|
||||
utils, transform, data, model, solver, version_info, opt, '__version__',
|
||||
'dirname'
|
||||
]
|
||||
import sys
|
||||
sys.modules[__name__] = LazyImportModule(
|
||||
__name__,
|
||||
globals()['__file__'],
|
||||
_import_structure,
|
||||
module_spec=__spec__,
|
||||
extra_objects={},
|
||||
)
|
||||
|
||||
@@ -0,0 +1,161 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 2024
|
||||
#
|
||||
SOLVER:
|
||||
NAME: ACESolver
|
||||
RESUME_FROM:
|
||||
LOAD_MODEL_ONLY: True
|
||||
USE_FSDP: False
|
||||
SHARDING_STRATEGY:
|
||||
USE_AMP: True
|
||||
DTYPE: float16
|
||||
CHANNELS_LAST: True
|
||||
MAX_STEPS: 500
|
||||
MAX_EPOCHS: -1
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 50
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/ace_0.6b_1024
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
- NAME: "HuggingfaceFs"
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
- NAME: "LocalFs"
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
- NAME: "ModelscopeFs"
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionACE
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
SCALE_FACTOR: 0.18215
|
||||
SIZE_FACTOR: 8
|
||||
DECODER_BIAS: 0.5
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: True
|
||||
EVAL_EMA: False
|
||||
TEXT_IDENTIFIER: [ '{image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
USE_TEXT_POS_EMBEDDINGS: True
|
||||
#
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: eps
|
||||
MIN_SNR_GAMMA:
|
||||
NOISE_SCHEDULER:
|
||||
NAME: LinearScheduler
|
||||
NUM_TIMESTEPS: 1000
|
||||
BETA_MIN: 0.0001
|
||||
BETA_MAX: 0.02
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: ACE
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/dit/ace_0.6b_1024px.pth
|
||||
IGNORE_KEYS: [ ]
|
||||
PATCH_SIZE: 2
|
||||
IN_CHANNELS: 4
|
||||
HIDDEN_SIZE: 1152
|
||||
DEPTH: 28
|
||||
NUM_HEADS: 16
|
||||
MLP_RATIO: 4.0
|
||||
PRED_SIGMA: True
|
||||
DROP_PATH: 0.0
|
||||
WINDOW_DIZE: 0
|
||||
Y_CHANNELS: 4096
|
||||
MAX_SEQ_LEN: 4096
|
||||
QK_NORM: True
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
ATTENTION_BACKEND: flash_attn
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKL
|
||||
EMBED_DIM: 4
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/vae/vae.bin
|
||||
IGNORE_KEYS: []
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/text_encoder/t5-v1_1-xxl/
|
||||
TOKENIZER_PATH: ms://iic/ACE-0.6B-1024px@models/tokenizer/t5-v1_1-xxl
|
||||
LENGTH: 120
|
||||
T5_DTYPE: bfloat16
|
||||
ADDED_IDENTIFIER: [ '{image}', '{caption}', '{mask}', '{ref_image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
CLEAN: whitespace
|
||||
USE_GRAD: False
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 20
|
||||
GUIDE_SCALE: 4.5
|
||||
GUIDE_RESCALE: 0.5
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 1e-7
|
||||
EPS: 1e-10
|
||||
WEIGHT_DECAY: 5e-4
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: ImageTextPairMSDatasetForACE
|
||||
MODE: train
|
||||
MS_DATASET_NAME: cache/datasets/hed_pair
|
||||
MS_DATASET_NAMESPACE: ""
|
||||
MS_DATASET_SPLIT: "train"
|
||||
MS_DATASET_SUBNAME: ""
|
||||
PROMPT_PREFIX: ""
|
||||
REPLACE_STYLE: False
|
||||
MAX_SEQ_LEN: 4096
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 1
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
-
|
||||
NAME: BackwardHook
|
||||
PRIORITY: 0
|
||||
-
|
||||
NAME: LogHook
|
||||
LOG_INTERVAL: 50
|
||||
-
|
||||
NAME: CheckpointHook
|
||||
INTERVAL: 100
|
||||
-
|
||||
NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
@@ -0,0 +1,161 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 2024
|
||||
#
|
||||
SOLVER:
|
||||
NAME: ACESolver
|
||||
RESUME_FROM:
|
||||
LOAD_MODEL_ONLY: True
|
||||
USE_FSDP: False
|
||||
SHARDING_STRATEGY:
|
||||
USE_AMP: True
|
||||
DTYPE: float16
|
||||
CHANNELS_LAST: True
|
||||
MAX_STEPS: 500
|
||||
MAX_EPOCHS: -1
|
||||
NUM_FOLDS: 1
|
||||
ACCU_STEP: 1
|
||||
EVAL_INTERVAL: 50
|
||||
RESCALE_LR: False
|
||||
#
|
||||
WORK_DIR: ./cache/save_data/ace_0.6b_512
|
||||
LOG_FILE: std_log.txt
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
- NAME: "HuggingfaceFs"
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
- NAME: "LocalFs"
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
- NAME: "ModelscopeFs"
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionACE
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
SCALE_FACTOR: 0.18215
|
||||
SIZE_FACTOR: 8
|
||||
DECODER_BIAS: 0.5
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: True
|
||||
EVAL_EMA: False
|
||||
TEXT_IDENTIFIER: [ '{image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
USE_TEXT_POS_EMBEDDINGS: True
|
||||
#
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: eps
|
||||
MIN_SNR_GAMMA:
|
||||
NOISE_SCHEDULER:
|
||||
NAME: LinearScheduler
|
||||
NUM_TIMESTEPS: 1000
|
||||
BETA_MIN: 0.0001
|
||||
BETA_MAX: 0.02
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: ACE
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-512px@models/dit/ace_0.6b_512px.pth
|
||||
IGNORE_KEYS: [ ]
|
||||
PATCH_SIZE: 2
|
||||
IN_CHANNELS: 4
|
||||
HIDDEN_SIZE: 1152
|
||||
DEPTH: 28
|
||||
NUM_HEADS: 16
|
||||
MLP_RATIO: 4.0
|
||||
PRED_SIGMA: True
|
||||
DROP_PATH: 0.0
|
||||
WINDOW_DIZE: 0
|
||||
Y_CHANNELS: 4096
|
||||
MAX_SEQ_LEN: 1024
|
||||
QK_NORM: True
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
ATTENTION_BACKEND: flash_attn
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKL
|
||||
EMBED_DIM: 4
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-512px@models/vae/vae.bin
|
||||
IGNORE_KEYS: []
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-512px@models/text_encoder/t5-v1_1-xxl/
|
||||
TOKENIZER_PATH: ms://iic/ACE-0.6B-512px@models/tokenizer/t5-v1_1-xxl
|
||||
LENGTH: 120
|
||||
T5_DTYPE: bfloat16
|
||||
ADDED_IDENTIFIER: [ '{image}', '{caption}', '{mask}', '{ref_image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
CLEAN: whitespace
|
||||
USE_GRAD: False
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 20
|
||||
GUIDE_SCALE: 4.5
|
||||
GUIDE_RESCALE: 0.5
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 1e-7
|
||||
EPS: 1e-10
|
||||
WEIGHT_DECAY: 5e-4
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: ImageTextPairMSDatasetForACE
|
||||
MODE: train
|
||||
MS_DATASET_NAME: cache/datasets/hed_pair
|
||||
MS_DATASET_NAMESPACE: ""
|
||||
MS_DATASET_SPLIT: "train"
|
||||
MS_DATASET_SUBNAME: ""
|
||||
PROMPT_PREFIX: ""
|
||||
REPLACE_STYLE: False
|
||||
MAX_SEQ_LEN: 1024
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 1
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
-
|
||||
NAME: BackwardHook
|
||||
PRIORITY: 0
|
||||
-
|
||||
NAME: LogHook
|
||||
LOG_INTERVAL: 50
|
||||
-
|
||||
NAME: CheckpointHook
|
||||
INTERVAL: 100
|
||||
-
|
||||
NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
@@ -0,0 +1,277 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 42
|
||||
TENSOR_PARALLEL_SIZE: 1
|
||||
PIPELINE_PARALLEL_SIZE: 1
|
||||
SYS_ENVS:
|
||||
TORCH_CUDNN_V8_API_ENABLED: '1'
|
||||
TOKENIZERS_PARALLELISM: 'false'
|
||||
TF_CPP_MIN_LOG_LEVEL: '3'
|
||||
PYTORCH_CUDA_ALLOC_CONF: 'expandable_segments:True'
|
||||
#
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionVideoSolver
|
||||
MAX_STEPS: 2000
|
||||
USE_AMP: True
|
||||
DTYPE: bfloat16
|
||||
USE_FAIRSCALE: False
|
||||
USE_FSDP: True
|
||||
LOAD_MODEL_ONLY: False
|
||||
ENABLE_GRADSCALER: False
|
||||
USE_SCALER: False
|
||||
RESUME_FROM:
|
||||
WORK_DIR: ./cache/save_data/dit_cogvideox1.5_5b_i2v_lora
|
||||
LOG_FILE: std_log.txt
|
||||
EVAL_INTERVAL: 100
|
||||
LOG_TRAIN_NUM: 4
|
||||
FPS: 16
|
||||
SHARDING_STRATEGY: full_shard
|
||||
FSDP_REDUCE_DTYPE: float32
|
||||
FSDP_BUFFER_DTYPE: float32
|
||||
FSDP_SHARD_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
SAVE_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
TRAIN_MODULES: ['model']
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
- NAME: SwiftLoRA
|
||||
R: 64
|
||||
LORA_ALPHA: 64
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "model.*(.to_k|.to_q|.to_v|.to_out.0)$"
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionCogVideoX
|
||||
PRETRAINED_MODEL:
|
||||
PARAMETERIZATION: v
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA: 3.0
|
||||
ZERO_TERMINAL_SNR: True
|
||||
SCALE_FACTOR_SPATIAL: 8
|
||||
SCALE_FACTOR_TEMPORAL: 4
|
||||
SCALING_FACTOR_IMAGE: 0.7
|
||||
NOISED_IMAGE_DROPOUT: 0.05
|
||||
INVERT_SCALE_LATENTS: True
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: v
|
||||
USE_DYNAMIC_CFG: False
|
||||
NOISE_SCHEDULER:
|
||||
NAME: ScaledLinearScheduler
|
||||
BETA_MIN: 0.00085
|
||||
BETA_MAX: 0.012
|
||||
SNR_SHIFT_SCALE: 1.0
|
||||
RESCALE_BETAS_ZERO_SNR: True
|
||||
DIFFUSION_SAMPLERS:
|
||||
NAME: DDIMSampler
|
||||
DISCRETIZATION_TYPE: trailing
|
||||
ETA: 0.0
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: CogVideoXTransformer3DModel
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: # 5b-I2V diff
|
||||
- ms://ZhipuAI/CogVideoX1.5-5B-I2V@transformer/diffusion_pytorch_model-00001-of-00003.safetensors
|
||||
- ms://ZhipuAI/CogVideoX1.5-5B-I2V@transformer/diffusion_pytorch_model-00002-of-00003.safetensors
|
||||
- ms://ZhipuAI/CogVideoX1.5-5B-I2V@transformer/diffusion_pytorch_model-00003-of-00003.safetensors
|
||||
NUM_ATTENTION_HEADS: 48
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
IN_CHANNELS: 32
|
||||
LATENT_CHANNELS: 16
|
||||
OUT_CHANNELS: 16
|
||||
FLIP_SIN_TO_COS: True
|
||||
FREQ_SHIFT: 0
|
||||
TIME_EMBED_DIM: 512
|
||||
TEXT_EMBED_DIM: 4096
|
||||
OFS_EMBED_DIM: 512 # v1.5 diff
|
||||
NUM_LAYERS: 42
|
||||
DROPOUT: 0.0
|
||||
ATTENTION_BIAS: True
|
||||
SAMPLE_WIDTH: 300
|
||||
SAMPLE_HEIGHT: 300
|
||||
SAMPLE_FRAMES: 81
|
||||
PATCH_SIZE: 2
|
||||
PATCH_SIZE_T: 2 # v1.5 diff
|
||||
PATCH_BIAS: False # v1.5 diff
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
MAX_TEXT_SEQ_LENGTH: 224
|
||||
ACTIVATION_FN: "gelu-approximate"
|
||||
TIMESTEP_ACTIVATION_FN: "silu"
|
||||
NORM_ELEMENTWISE_AFFINE: True
|
||||
NORM_EPS: 1e-5
|
||||
SPATIAL_INTERPOLATION_SCALE: 1.875
|
||||
TEMPORAL_INTERPOLATION_SCALE: 1.0
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: True
|
||||
USE_LEARNED_POSITIONAL_EMBEDDINGS: False
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://ZhipuAI/CogVideoX1.5-5B-I2V@vae/diffusion_pytorch_model.safetensors
|
||||
SAMPLE_HEIGHT: 768
|
||||
SAMPLE_WIDTH: 1360
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
LENGTH: 224
|
||||
CLEAN:
|
||||
USE_GRAD: False
|
||||
T5_DTYPE: bfloat16
|
||||
#
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
SEED: 42
|
||||
GUIDE_SCALE: 6.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
NUM_FRAMES: 81
|
||||
IMAGE_SIZE: [768, 1360]
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: Adam
|
||||
LEARNING_RATE: 1e-3
|
||||
BETAS: [ 0.9, 0.95 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 0.0
|
||||
AMSGRAD: False
|
||||
#
|
||||
# LR_SCHEDULER:
|
||||
# NAME: StepAnnealingLR
|
||||
# WARMUP_STEPS: 200
|
||||
# TOTAL_STEPS: 2000
|
||||
# DECAY_MODE: 'cosine'
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: VideoGenDataset
|
||||
MODE: train
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 0
|
||||
NUM_FRAMES: 85
|
||||
FPS: 16
|
||||
HEIGHT: 768
|
||||
WIDTH: 1360
|
||||
PROMPT_PREFIX: 'DISNEY '
|
||||
DATA_TYPE: 'i2v'
|
||||
SAMPLER:
|
||||
NAME: MixtureOfSamplers
|
||||
SUB_SAMPLERS:
|
||||
- NAME: MultiLevelBatchSampler
|
||||
PROB: 1.0
|
||||
FIELDS: [ "video_path", "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PATH_PREFIX: cache/datasets/Disney-VideoGeneration-Dataset/
|
||||
INDEX_FILE: cache/datasets/Disney-VideoGeneration-Dataset/index.jsonl
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ "video", "image", "prompt" ]
|
||||
META_KEYS: [ ]
|
||||
#
|
||||
# EVAL_DATA:
|
||||
# NAME: Text2ImageDataset
|
||||
# MODE: eval
|
||||
# PROMPT_FILE:
|
||||
# PROMPT_DATA: [ "A cat running.#;#asset/images/edit_tuner/cat_512.jpg" ]
|
||||
# FIELDS: [ "prompt", "img_path" ]
|
||||
# DELIMITER: '#;#'
|
||||
# PROMPT_PREFIX: ''
|
||||
# PIN_MEMORY: True
|
||||
# BATCH_SIZE: 1
|
||||
# USE_NUM: 8
|
||||
# NUM_WORKERS: 0
|
||||
# IMAGE_SIZE: [768, 1360]
|
||||
# TRANSFORMS:
|
||||
# - NAME: LoadImageFromFileList
|
||||
# FILE_KEYS: [ 'img_path' ]
|
||||
# RGB_ORDER: RGB
|
||||
# BACKEND: pillow
|
||||
# - NAME: FlexibleResize
|
||||
# INTERPOLATION: bilinear
|
||||
# SIZE: [768, 1360]
|
||||
# INPUT_KEY: [ 'img' ]
|
||||
# OUTPUT_KEY: [ 'img' ]
|
||||
# BACKEND: pillow
|
||||
# - NAME: FlexibleCenterCrop
|
||||
# SIZE: [768, 1360]
|
||||
# INPUT_KEY: [ 'img' ]
|
||||
# OUTPUT_KEY: [ 'img' ]
|
||||
# BACKEND: pillow
|
||||
# - NAME: ImageToTensor
|
||||
# INPUT_KEY: [ 'img' ]
|
||||
# OUTPUT_KEY: [ 'img' ]
|
||||
# BACKEND: pillow
|
||||
# - NAME: Normalize
|
||||
# MEAN: [ 0.5, 0.5, 0.5 ]
|
||||
# STD: [ 0.5, 0.5, 0.5 ]
|
||||
# INPUT_KEY: [ 'img' ]
|
||||
# OUTPUT_KEY: [ 'image' ]
|
||||
# BACKEND: torchvision
|
||||
# - NAME: Select
|
||||
# KEYS: [ 'image', 'prompt' ]
|
||||
# META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
- NAME: BackwardHook
|
||||
PRIORITY: 10
|
||||
- NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
PRIORITY: 20
|
||||
- NAME: CheckpointHook
|
||||
INTERVAL: 1000
|
||||
PRIORITY: 40
|
||||
#
|
||||
# EVAL_HOOKS:
|
||||
# - NAME: ProbeDataHook
|
||||
# PROB_INTERVAL: 100
|
||||
# PRIORITY: 0
|
||||
@@ -0,0 +1,248 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 42
|
||||
TENSOR_PARALLEL_SIZE: 1
|
||||
PIPELINE_PARALLEL_SIZE: 1
|
||||
SYS_ENVS:
|
||||
TORCH_CUDNN_V8_API_ENABLED: '1'
|
||||
TOKENIZERS_PARALLELISM: 'false'
|
||||
TF_CPP_MIN_LOG_LEVEL: '3'
|
||||
PYTORCH_CUDA_ALLOC_CONF: 'expandable_segments:True'
|
||||
#
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionVideoSolver
|
||||
MAX_STEPS: 2000
|
||||
USE_AMP: True
|
||||
DTYPE: bfloat16
|
||||
USE_FAIRSCALE: False
|
||||
USE_FSDP: True
|
||||
LOAD_MODEL_ONLY: False
|
||||
ENABLE_GRADSCALER: False
|
||||
USE_SCALER: False
|
||||
RESUME_FROM:
|
||||
WORK_DIR: ./cache/save_data/dit_cogvideox1.5_5b_lora
|
||||
LOG_FILE: std_log.txt
|
||||
EVAL_INTERVAL: 100
|
||||
LOG_TRAIN_NUM: 4
|
||||
FPS: 16
|
||||
SHARDING_STRATEGY: full_shard
|
||||
FSDP_REDUCE_DTYPE: float32
|
||||
FSDP_BUFFER_DTYPE: float32
|
||||
FSDP_SHARD_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
SAVE_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
TRAIN_MODULES: ['model']
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
- NAME: SwiftLoRA
|
||||
R: 64
|
||||
LORA_ALPHA: 64
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "model.*(.to_k|.to_q|.to_v|.to_out.0)$"
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionCogVideoX
|
||||
PRETRAINED_MODEL:
|
||||
PARAMETERIZATION: v
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA: 3.0
|
||||
ZERO_TERMINAL_SNR: True
|
||||
SCALE_FACTOR_SPATIAL: 8
|
||||
SCALE_FACTOR_TEMPORAL: 4
|
||||
SCALING_FACTOR_IMAGE: 0.7
|
||||
INVERT_SCALE_LATENTS: True
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: v
|
||||
USE_DYNAMIC_CFG: False
|
||||
NOISE_SCHEDULER:
|
||||
NAME: ScaledLinearScheduler
|
||||
BETA_MIN: 0.00085
|
||||
BETA_MAX: 0.012
|
||||
SNR_SHIFT_SCALE: 1.0
|
||||
RESCALE_BETAS_ZERO_SNR: True
|
||||
DIFFUSION_SAMPLERS:
|
||||
NAME: DDIMSampler
|
||||
DISCRETIZATION_TYPE: trailing
|
||||
ETA: 0.0
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: CogVideoXTransformer3DModel
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL:
|
||||
- ms://ZhipuAI/CogVideoX1.5-5B@transformer/diffusion_pytorch_model-00001-of-00003.safetensors
|
||||
- ms://ZhipuAI/CogVideoX1.5-5B@transformer/diffusion_pytorch_model-00002-of-00003.safetensors
|
||||
- ms://ZhipuAI/CogVideoX1.5-5B@transformer/diffusion_pytorch_model-00003-of-00003.safetensors
|
||||
NUM_ATTENTION_HEADS: 48
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 16
|
||||
FLIP_SIN_TO_COS: True
|
||||
FREQ_SHIFT: 0
|
||||
TIME_EMBED_DIM: 512
|
||||
TEXT_EMBED_DIM: 4096
|
||||
NUM_LAYERS: 42
|
||||
DROPOUT: 0.0
|
||||
ATTENTION_BIAS: True
|
||||
SAMPLE_WIDTH: 300
|
||||
SAMPLE_HEIGHT: 300
|
||||
SAMPLE_FRAMES: 81
|
||||
PATCH_SIZE: 2
|
||||
PATCH_SIZE_T: 2 # v1.5 diff
|
||||
PATCH_BIAS: False # v1.5 diff
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
MAX_TEXT_SEQ_LENGTH: 224
|
||||
ACTIVATION_FN: "gelu-approximate"
|
||||
TIMESTEP_ACTIVATION_FN: "silu"
|
||||
NORM_ELEMENTWISE_AFFINE: True
|
||||
NORM_EPS: 1e-5
|
||||
SPATIAL_INTERPOLATION_SCALE: 1.875
|
||||
TEMPORAL_INTERPOLATION_SCALE: 1.0
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: True
|
||||
USE_LEARNED_POSITIONAL_EMBEDDINGS: False
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://ZhipuAI/CogVideoX1.5-5B@vae/diffusion_pytorch_model.safetensors
|
||||
SAMPLE_HEIGHT: 768
|
||||
SAMPLE_WIDTH: 1360
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
LENGTH: 224
|
||||
CLEAN:
|
||||
USE_GRAD: False
|
||||
T5_DTYPE: bfloat16
|
||||
#
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
SEED: 42
|
||||
GUIDE_SCALE: 6.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
NUM_FRAMES: 81
|
||||
IMAGE_SIZE: [768, 1360]
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: Adam
|
||||
LEARNING_RATE: 1e-3
|
||||
BETAS: [ 0.9, 0.95 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 0.0
|
||||
AMSGRAD: False
|
||||
#
|
||||
# LR_SCHEDULER:
|
||||
# NAME: StepAnnealingLR
|
||||
# WARMUP_STEPS: 200
|
||||
# TOTAL_STEPS: 2000
|
||||
# DECAY_MODE: 'cosine'
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: VideoGenDataset
|
||||
MODE: train
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 0
|
||||
NUM_FRAMES: 85
|
||||
FPS: 16
|
||||
HEIGHT: 768
|
||||
WIDTH: 1360
|
||||
PROMPT_PREFIX: 'DISNEY '
|
||||
SAMPLER:
|
||||
NAME: MixtureOfSamplers
|
||||
SUB_SAMPLERS:
|
||||
- NAME: MultiLevelBatchSampler
|
||||
PROB: 1.0
|
||||
FIELDS: [ "video_path", "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PATH_PREFIX: cache/datasets/Disney-VideoGeneration-Dataset/
|
||||
INDEX_FILE: cache/datasets/Disney-VideoGeneration-Dataset/index.jsonl
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'video', "prompt" ]
|
||||
META_KEYS: [ ]
|
||||
#
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "A girl riding a bike." ]
|
||||
IMAGE_SIZE: [ 768, 1360 ]
|
||||
FIELDS: [ "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: 'DISNEY ' # ''
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
USE_NUM: 8
|
||||
NUM_WORKERS: 0
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'index', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
- NAME: BackwardHook
|
||||
PRIORITY: 10
|
||||
- NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
PRIORITY: 20
|
||||
- NAME: CheckpointHook
|
||||
INTERVAL: 1000
|
||||
PRIORITY: 40
|
||||
#
|
||||
EVAL_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
@@ -0,0 +1,239 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 42
|
||||
TENSOR_PARALLEL_SIZE: 1
|
||||
PIPELINE_PARALLEL_SIZE: 1
|
||||
SYS_ENVS:
|
||||
TORCH_CUDNN_V8_API_ENABLED: '1'
|
||||
TOKENIZERS_PARALLELISM: 'false'
|
||||
TF_CPP_MIN_LOG_LEVEL: '3'
|
||||
PYTORCH_CUDA_ALLOC_CONF: 'expandable_segments:True'
|
||||
#
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionVideoSolver
|
||||
MAX_STEPS: 2000
|
||||
USE_AMP: True
|
||||
DTYPE: bfloat16
|
||||
USE_FAIRSCALE: False
|
||||
USE_FSDP: True
|
||||
LOAD_MODEL_ONLY: False
|
||||
RESUME_FROM:
|
||||
WORK_DIR: ./cache/save_data/dit_cogvideox_2b_lora
|
||||
LOG_FILE: std_log.txt
|
||||
EVAL_INTERVAL: 100
|
||||
LOG_TRAIN_NUM: 4
|
||||
ENABLE_GRADSCALER: False
|
||||
USE_SCALER: False
|
||||
FPS: 8
|
||||
SHARDING_STRATEGY: full_shard
|
||||
FSDP_REDUCE_DTYPE: float32
|
||||
FSDP_BUFFER_DTYPE: float32
|
||||
FSDP_SHARD_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
SAVE_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
TRAIN_MODULES: ['model']
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
- NAME: SwiftLoRA
|
||||
R: 64
|
||||
LORA_ALPHA: 64
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "model.*(.to_k|.to_q|.to_v|.to_out.0)$"
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionCogVideoX
|
||||
PRETRAINED_MODEL:
|
||||
PARAMETERIZATION: v
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA: 3.0
|
||||
ZERO_TERMINAL_SNR: True
|
||||
SCALE_FACTOR_SPATIAL: 8
|
||||
SCALE_FACTOR_TEMPORAL: 4
|
||||
SCALING_FACTOR_IMAGE: 1.15258426
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: v
|
||||
NOISE_SCHEDULER:
|
||||
NAME: ScaledLinearScheduler
|
||||
BETA_MIN: 0.00085
|
||||
BETA_MAX: 0.012
|
||||
SNR_SHIFT_SCALE: 3.0
|
||||
RESCALE_BETAS_ZERO_SNR: True
|
||||
DIFFUSION_SAMPLERS:
|
||||
NAME: DDIMSampler
|
||||
DISCRETIZATION_TYPE: trailing
|
||||
ETA: 0.0
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: CogVideoXTransformer3DModel
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-2b@transformer/diffusion_pytorch_model.safetensors
|
||||
NUM_ATTENTION_HEADS: 30
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 16
|
||||
FLIP_SIN_TO_COS: True
|
||||
FREQ_SHIFT: 0
|
||||
TIME_EMBED_DIM: 512
|
||||
TEXT_EMBED_DIM: 4096
|
||||
NUM_LAYERS: 30
|
||||
DROPOUT: 0.0
|
||||
ATTENTION_BIAS: True
|
||||
SAMPLE_WIDTH: 90
|
||||
SAMPLE_HEIGHT: 60
|
||||
SAMPLE_FRAMES: 49
|
||||
PATCH_SIZE: 2
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
MAX_TEXT_SEQ_LENGTH: 226
|
||||
ACTIVATION_FN: "gelu-approximate"
|
||||
TIMESTEP_ACTIVATION_FN: "silu"
|
||||
NORM_ELEMENTWISE_AFFINE: True
|
||||
NORM_EPS: 1e-5
|
||||
SPATIAL_INTERPOLATION_SCALE: 1.875
|
||||
TEMPORAL_INTERPOLATION_SCALE: 1.0
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: False
|
||||
USE_LEARNED_POSITIONAL_EMBEDDINGS: False
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-2b@vae/diffusion_pytorch_model.safetensors
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
LENGTH: 226
|
||||
CLEAN:
|
||||
USE_GRAD: False
|
||||
#
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
SEED: 42
|
||||
GUIDE_SCALE: 6.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
NUM_FRAMES: 49
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: Adam
|
||||
LEARNING_RATE: 1e-3
|
||||
BETAS: [ 0.9, 0.95 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 0.0
|
||||
AMSGRAD: False
|
||||
#
|
||||
# LR_SCHEDULER:
|
||||
# NAME: StepAnnealingLR
|
||||
# WARMUP_STEPS: 200
|
||||
# TOTAL_STEPS: 2000
|
||||
# DECAY_MODE: 'cosine'
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: VideoGenDataset
|
||||
MODE: train
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
NUM_FRAMES: 49
|
||||
FPS: 8
|
||||
HEIGHT: 480
|
||||
WIDTH: 720
|
||||
PROMPT_PREFIX: 'DISNEY '
|
||||
SAMPLER:
|
||||
NAME: MixtureOfSamplers
|
||||
SUB_SAMPLERS:
|
||||
- NAME: MultiLevelBatchSampler
|
||||
PROB: 1.0
|
||||
FIELDS: [ "video_path", "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PATH_PREFIX: cache/datasets/Disney-VideoGeneration-Dataset/
|
||||
INDEX_FILE: cache/datasets/Disney-VideoGeneration-Dataset/index.jsonl
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'video', "prompt" ]
|
||||
META_KEYS: [ ]
|
||||
#
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "A girl riding a bike.", "A panda, dressed in a small, red jacket and a tiny hat, sits on a wooden stool in a serene bamboo forest. The panda's fluffy paws strum a miniature acoustic guitar, producing soft, melodic tunes. Nearby, a few other pandas gather, watching curiously and some clapping in rhythm. Sunlight filters through the tall bamboo, casting a gentle glow on the scene. The panda's face is expressive, showing concentration and joy as it plays. The background includes a small, flowing stream and vibrant green foliage, enhancing the peaceful and magical atmosphere of this unique musical performance." ]
|
||||
IMAGE_SIZE: [ 480, 720 ]
|
||||
FIELDS: [ "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: 'DISNEY '
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
USE_NUM: 8
|
||||
NUM_WORKERS: 4
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'index', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
- NAME: BackwardHook
|
||||
PRIORITY: 10
|
||||
- NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
PRIORITY: 20
|
||||
- NAME: CheckpointHook
|
||||
INTERVAL: 1000
|
||||
PRIORITY: 40
|
||||
#
|
||||
EVAL_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
@@ -0,0 +1,270 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 42
|
||||
TENSOR_PARALLEL_SIZE: 1
|
||||
PIPELINE_PARALLEL_SIZE: 1
|
||||
SYS_ENVS:
|
||||
TORCH_CUDNN_V8_API_ENABLED: '1'
|
||||
TOKENIZERS_PARALLELISM: 'false'
|
||||
TF_CPP_MIN_LOG_LEVEL: '3'
|
||||
PYTORCH_CUDA_ALLOC_CONF: 'expandable_segments:True'
|
||||
#
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionVideoSolver
|
||||
MAX_STEPS: 2000
|
||||
USE_AMP: True
|
||||
DTYPE: bfloat16
|
||||
USE_FAIRSCALE: False
|
||||
USE_FSDP: True
|
||||
LOAD_MODEL_ONLY: False
|
||||
ENABLE_GRADSCALER: False
|
||||
USE_SCALER: False
|
||||
RESUME_FROM:
|
||||
WORK_DIR: ./cache/save_data/dit_cogvideox_5b_i2v_lora
|
||||
LOG_FILE: std_log.txt
|
||||
EVAL_INTERVAL: 100
|
||||
LOG_TRAIN_NUM: 4
|
||||
FPS: 8
|
||||
SHARDING_STRATEGY: full_shard
|
||||
FSDP_REDUCE_DTYPE: float32
|
||||
FSDP_BUFFER_DTYPE: float32
|
||||
FSDP_SHARD_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
SAVE_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
TRAIN_MODULES: ['model']
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
- NAME: SwiftLoRA
|
||||
R: 64
|
||||
LORA_ALPHA: 64
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "model.*(.to_k|.to_q|.to_v|.to_out.0)$"
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionCogVideoX
|
||||
PRETRAINED_MODEL:
|
||||
PARAMETERIZATION: v
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA: 3.0
|
||||
ZERO_TERMINAL_SNR: True
|
||||
SCALE_FACTOR_SPATIAL: 8
|
||||
SCALE_FACTOR_TEMPORAL: 4
|
||||
SCALING_FACTOR_IMAGE: 0.7 # 5b diff
|
||||
NOISED_IMAGE_DROPOUT: 0.05
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: v
|
||||
NOISE_SCHEDULER:
|
||||
NAME: ScaledLinearScheduler
|
||||
BETA_MIN: 0.00085
|
||||
BETA_MAX: 0.012
|
||||
SNR_SHIFT_SCALE: 1.0 # 5b diff
|
||||
RESCALE_BETAS_ZERO_SNR: True
|
||||
DIFFUSION_SAMPLERS:
|
||||
NAME: DDIMSampler
|
||||
DISCRETIZATION_TYPE: trailing
|
||||
ETA: 0.0
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: CogVideoXTransformer3DModel
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: # 5b-I2V diff
|
||||
- ms://AI-ModelScope/CogVideoX-5b-I2V@transformer/diffusion_pytorch_model-00001-of-00003.safetensors
|
||||
- ms://AI-ModelScope/CogVideoX-5b-I2V@transformer/diffusion_pytorch_model-00002-of-00003.safetensors
|
||||
- ms://AI-ModelScope/CogVideoX-5b-I2V@transformer/diffusion_pytorch_model-00003-of-00003.safetensors
|
||||
NUM_ATTENTION_HEADS: 48 # 5b diff
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
IN_CHANNELS: 32 # 5b-I2V diff
|
||||
LATENT_CHANNELS: 16
|
||||
OUT_CHANNELS: 16
|
||||
FLIP_SIN_TO_COS: True
|
||||
FREQ_SHIFT: 0
|
||||
TIME_EMBED_DIM: 512
|
||||
TEXT_EMBED_DIM: 4096
|
||||
NUM_LAYERS: 42 # 5b diff
|
||||
DROPOUT: 0.0
|
||||
ATTENTION_BIAS: True
|
||||
SAMPLE_WIDTH: 90
|
||||
SAMPLE_HEIGHT: 60
|
||||
SAMPLE_FRAMES: 49
|
||||
PATCH_SIZE: 2
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
MAX_TEXT_SEQ_LENGTH: 226
|
||||
ACTIVATION_FN: "gelu-approximate"
|
||||
TIMESTEP_ACTIVATION_FN: "silu"
|
||||
NORM_ELEMENTWISE_AFFINE: True
|
||||
NORM_EPS: 1e-5
|
||||
SPATIAL_INTERPOLATION_SCALE: 1.875
|
||||
TEMPORAL_INTERPOLATION_SCALE: 1.0
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: True # 5b diff
|
||||
USE_LEARNED_POSITIONAL_EMBEDDINGS: True # 5b-I2V diff
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-5b-I2V@vae/diffusion_pytorch_model.safetensors # 5b diff
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
LENGTH: 226
|
||||
CLEAN:
|
||||
USE_GRAD: False
|
||||
#
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
SEED: 42
|
||||
GUIDE_SCALE: 6.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
NUM_FRAMES: 49
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: Adam
|
||||
LEARNING_RATE: 1e-3
|
||||
BETAS: [ 0.9, 0.95 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 0.0
|
||||
AMSGRAD: False
|
||||
#
|
||||
# LR_SCHEDULER:
|
||||
# NAME: StepAnnealingLR
|
||||
# WARMUP_STEPS: 200
|
||||
# TOTAL_STEPS: 2000
|
||||
# DECAY_MODE: 'cosine'
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: VideoGenDataset
|
||||
MODE: train
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 0
|
||||
NUM_FRAMES: 49
|
||||
FPS: 8
|
||||
HEIGHT: 480
|
||||
WIDTH: 720
|
||||
PROMPT_PREFIX: 'DISNEY '
|
||||
DATA_TYPE: 'i2v'
|
||||
SAMPLER:
|
||||
NAME: MixtureOfSamplers
|
||||
SUB_SAMPLERS:
|
||||
- NAME: MultiLevelBatchSampler
|
||||
PROB: 1.0
|
||||
FIELDS: [ "video_path", "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PATH_PREFIX: cache/datasets/Disney-VideoGeneration-Dataset/
|
||||
INDEX_FILE: cache/datasets/Disney-VideoGeneration-Dataset/index.jsonl
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ "video", "image", "prompt" ]
|
||||
META_KEYS: [ ]
|
||||
#
|
||||
# EVAL_DATA:
|
||||
# NAME: Text2ImageDataset
|
||||
# MODE: eval
|
||||
# PROMPT_FILE:
|
||||
# PROMPT_DATA: [ "A cat running.#;#asset/images/edit_tuner/cat_512.jpg" ]
|
||||
# FIELDS: [ "prompt", "img_path" ]
|
||||
# DELIMITER: '#;#'
|
||||
# PROMPT_PREFIX: ''
|
||||
# PIN_MEMORY: True
|
||||
# BATCH_SIZE: 1
|
||||
# USE_NUM: 8
|
||||
# NUM_WORKERS: 0
|
||||
# IMAGE_SIZE: [ 480, 720 ]
|
||||
# TRANSFORMS:
|
||||
# - NAME: LoadImageFromFileList
|
||||
# FILE_KEYS: [ 'img_path' ]
|
||||
# RGB_ORDER: RGB
|
||||
# BACKEND: pillow
|
||||
# - NAME: FlexibleResize
|
||||
# INTERPOLATION: bilinear
|
||||
# SIZE: [ 480, 720 ]
|
||||
# INPUT_KEY: [ 'img' ]
|
||||
# OUTPUT_KEY: [ 'img' ]
|
||||
# BACKEND: pillow
|
||||
# - NAME: FlexibleCenterCrop
|
||||
# SIZE: [ 480, 720 ]
|
||||
# INPUT_KEY: [ 'img' ]
|
||||
# OUTPUT_KEY: [ 'img' ]
|
||||
# BACKEND: pillow
|
||||
# - NAME: ImageToTensor
|
||||
# INPUT_KEY: [ 'img' ]
|
||||
# OUTPUT_KEY: [ 'img' ]
|
||||
# BACKEND: pillow
|
||||
# - NAME: Normalize
|
||||
# MEAN: [ 0.5, 0.5, 0.5 ]
|
||||
# STD: [ 0.5, 0.5, 0.5 ]
|
||||
# INPUT_KEY: [ 'img' ]
|
||||
# OUTPUT_KEY: [ 'image' ]
|
||||
# BACKEND: torchvision
|
||||
# - NAME: Select
|
||||
# KEYS: [ 'image', 'prompt' ]
|
||||
# META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
- NAME: BackwardHook
|
||||
PRIORITY: 10
|
||||
- NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
PRIORITY: 20
|
||||
- NAME: CheckpointHook
|
||||
INTERVAL: 1000
|
||||
PRIORITY: 40
|
||||
#
|
||||
# EVAL_HOOKS:
|
||||
# - NAME: ProbeDataHook
|
||||
# PROB_INTERVAL: 100
|
||||
# PRIORITY: 0
|
||||
@@ -0,0 +1,277 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 42
|
||||
TENSOR_PARALLEL_SIZE: 1
|
||||
PIPELINE_PARALLEL_SIZE: 1
|
||||
SYS_ENVS:
|
||||
TORCH_CUDNN_V8_API_ENABLED: '1'
|
||||
TOKENIZERS_PARALLELISM: 'false'
|
||||
TF_CPP_MIN_LOG_LEVEL: '3'
|
||||
PYTORCH_CUDA_ALLOC_CONF: 'expandable_segments:True'
|
||||
#
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionVideoSolver
|
||||
MAX_STEPS: 2000
|
||||
USE_AMP: True
|
||||
DTYPE: bfloat16
|
||||
USE_FAIRSCALE: False
|
||||
USE_FSDP: True
|
||||
LOAD_MODEL_ONLY: False
|
||||
ENABLE_GRADSCALER: False
|
||||
USE_SCALER: False
|
||||
RESUME_FROM:
|
||||
WORK_DIR: ./cache/save_data/dit_cogvideox_5b_lora
|
||||
LOG_FILE: std_log.txt
|
||||
EVAL_INTERVAL: 100
|
||||
LOG_TRAIN_NUM: 4
|
||||
FPS: 8
|
||||
SHARDING_STRATEGY: full_shard
|
||||
FSDP_REDUCE_DTYPE: float32
|
||||
FSDP_BUFFER_DTYPE: float32
|
||||
FSDP_SHARD_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
SAVE_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
TRAIN_MODULES: ['model']
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
- NAME: SwiftLoRA
|
||||
R: 64
|
||||
LORA_ALPHA: 64
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "model.*(.to_k|.to_q|.to_v|.to_out.0)$"
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionCogVideoX
|
||||
PRETRAINED_MODEL:
|
||||
PARAMETERIZATION: v
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA: 3.0
|
||||
ZERO_TERMINAL_SNR: True
|
||||
SCALE_FACTOR_SPATIAL: 8
|
||||
SCALE_FACTOR_TEMPORAL: 4
|
||||
SCALING_FACTOR_IMAGE: 0.7 # 5b diff
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: v
|
||||
NOISE_SCHEDULER:
|
||||
NAME: ScaledLinearScheduler
|
||||
BETA_MIN: 0.00085
|
||||
BETA_MAX: 0.012
|
||||
SNR_SHIFT_SCALE: 1.0 # 5b diff
|
||||
RESCALE_BETAS_ZERO_SNR: True
|
||||
DIFFUSION_SAMPLERS:
|
||||
NAME: DDIMSampler
|
||||
DISCRETIZATION_TYPE: trailing
|
||||
ETA: 0.0
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: CogVideoXTransformer3DModel
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: # 5b diff
|
||||
- ms://AI-ModelScope/CogVideoX-5b@transformer/diffusion_pytorch_model-00001-of-00002.safetensors
|
||||
- ms://AI-ModelScope/CogVideoX-5b@transformer/diffusion_pytorch_model-00002-of-00002.safetensors
|
||||
NUM_ATTENTION_HEADS: 48 # 5b diff
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 16
|
||||
FLIP_SIN_TO_COS: True
|
||||
FREQ_SHIFT: 0
|
||||
TIME_EMBED_DIM: 512
|
||||
TEXT_EMBED_DIM: 4096
|
||||
NUM_LAYERS: 42 # 5b diff
|
||||
DROPOUT: 0.0
|
||||
ATTENTION_BIAS: True
|
||||
SAMPLE_WIDTH: 90
|
||||
SAMPLE_HEIGHT: 60
|
||||
SAMPLE_FRAMES: 49
|
||||
PATCH_SIZE: 2
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
MAX_TEXT_SEQ_LENGTH: 226
|
||||
ACTIVATION_FN: "gelu-approximate"
|
||||
TIMESTEP_ACTIVATION_FN: "silu"
|
||||
NORM_ELEMENTWISE_AFFINE: True
|
||||
NORM_EPS: 1e-5
|
||||
SPATIAL_INTERPOLATION_SCALE: 1.875
|
||||
TEMPORAL_INTERPOLATION_SCALE: 1.0
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: True # 5b diff
|
||||
USE_LEARNED_POSITIONAL_EMBEDDINGS: False
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-5b@vae/diffusion_pytorch_model.safetensors # 5b diff
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
LENGTH: 226
|
||||
CLEAN:
|
||||
USE_GRAD: False
|
||||
#
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
SEED: 42
|
||||
GUIDE_SCALE: 6.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
NUM_FRAMES: 49
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: Adam
|
||||
LEARNING_RATE: 1e-3
|
||||
BETAS: [ 0.9, 0.95 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 0.0
|
||||
AMSGRAD: False
|
||||
#
|
||||
# LR_SCHEDULER:
|
||||
# NAME: StepAnnealingLR
|
||||
# WARMUP_STEPS: 200
|
||||
# TOTAL_STEPS: 2000
|
||||
# DECAY_MODE: 'cosine'
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: VideoGenDatasetOTF
|
||||
MODE: train
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
NUM_FRAMES: 49
|
||||
FPS: 8
|
||||
HEIGHT: 480
|
||||
WIDTH: 720
|
||||
PROMPT_PREFIX: 'DISNEY '
|
||||
DELIMITER: '#;#'
|
||||
FIELDS: [ 'video_path', 'prompt' ]
|
||||
PATH_PREFIX: cache/datasets/Disney-VideoGeneration-Dataset/
|
||||
DATA_FILE: cache/datasets/Disney-VideoGeneration-Dataset/index.jsonl
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'video', 'video_latent', "prompt" ]
|
||||
META_KEYS: [ ]
|
||||
MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-5b@vae/diffusion_pytorch_model.safetensors
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "A girl riding a bike.", "A panda, dressed in a small, red jacket and a tiny hat, sits on a wooden stool in a serene bamboo forest. The panda's fluffy paws strum a miniature acoustic guitar, producing soft, melodic tunes. Nearby, a few other pandas gather, watching curiously and some clapping in rhythm. Sunlight filters through the tall bamboo, casting a gentle glow on the scene. The panda's face is expressive, showing concentration and joy as it plays. The background includes a small, flowing stream and vibrant green foliage, enhancing the peaceful and magical atmosphere of this unique musical performance." ]
|
||||
IMAGE_SIZE: [ 480, 720 ]
|
||||
FIELDS: [ "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: 'DISNEY '
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
USE_NUM: 8
|
||||
NUM_WORKERS: 4
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'index', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
- NAME: BackwardHook
|
||||
PRIORITY: 10
|
||||
- NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
PRIORITY: 20
|
||||
- NAME: CheckpointHook
|
||||
INTERVAL: 1000
|
||||
PRIORITY: 40
|
||||
#
|
||||
EVAL_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
@@ -0,0 +1,246 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 166666
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionSolver
|
||||
MAX_STEPS: 100000
|
||||
USE_AMP: True
|
||||
DTYPE: bfloat16
|
||||
USE_FAIRSCALE: False
|
||||
USE_FSDP: True
|
||||
LOAD_MODEL_ONLY: False
|
||||
ENABLE_GRADSCALER: False
|
||||
USE_SCALER: False
|
||||
RESUME_FROM:
|
||||
WORK_DIR: ./cache/save_data/dit_flux_dev_1024_lora
|
||||
LOG_FILE: std_log.txt
|
||||
EVAL_INTERVAL: 100
|
||||
LOG_TRAIN_NUM: 16
|
||||
FSDP_REDUCE_DTYPE: float32
|
||||
FSDP_BUFFER_DTYPE: float32
|
||||
FSDP_SHARD_MODULES: [ 'model', 'cond_stage_model.t5_model' ] #
|
||||
SAVE_MODULES: [ 'model'] #
|
||||
TRAIN_MODULES: ['model']
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
FREEZE:
|
||||
TUNER:
|
||||
- NAME: SwiftLoRA
|
||||
R: 4
|
||||
LORA_ALPHA: 4
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "(model.double_blocks.*(.qkv|.proj|.img_mod.lin|.txt_mod.lin))|(model.single_blocks.*(.linear1|.linear2|.modulation.lin))$"
|
||||
##
|
||||
MODEL:
|
||||
NAME: LatentDiffusionFlux
|
||||
PARAMETERIZATION: rf
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA:
|
||||
ZERO_TERMINAL_SNR: False
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
NAME: DiffusionFluxRF
|
||||
PREDICTION_TYPE: raw
|
||||
NOISE_SCHEDULER:
|
||||
NAME: FlowMatchSigmaScheduler
|
||||
WEIGHTING_SCHEME: logit_normal
|
||||
SHIFT: 3.0
|
||||
LOGIT_MEAN: 0.0
|
||||
LOGIT_STD: 1.0
|
||||
MODE_SCALE: 1.29
|
||||
SAMPLER_SCHEDULER:
|
||||
NAME: FlowMatchFluxShiftScheduler
|
||||
SHIFT: False
|
||||
SIGMOID_SCALE: 1
|
||||
BASE_SHIFT: 0.5
|
||||
MAX_SHIFT: 1.15
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: Flux
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-dev@flux1-dev.safetensors
|
||||
IN_CHANNELS: 64
|
||||
HIDDEN_SIZE: 3072
|
||||
NUM_HEADS: 24
|
||||
AXES_DIM: [ 16, 56, 56 ]
|
||||
THETA: 10000
|
||||
VEC_IN_DIM: 768
|
||||
GUIDANCE_EMBED: True
|
||||
CONTEXT_IN_DIM: 4096
|
||||
MLP_RATIO: 4.0
|
||||
QKV_BIAS: True
|
||||
DEPTH: 19
|
||||
DEPTH_SINGLE_BLOCKS: 38
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLFlux
|
||||
EMBED_DIM: 16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-dev@ae.safetensors
|
||||
IGNORE_KEYS: [ ]
|
||||
BATCH_SIZE: 8
|
||||
USE_CONV: False
|
||||
SCALE_FACTOR: 0.3611
|
||||
SHIFT_FACTOR: 0.1159
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5PlusClipFluxEmbedder
|
||||
T5_MODEL:
|
||||
NAME: HFEmbedder
|
||||
HF_MODEL_CLS: T5EncoderModel
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-dev@text_encoder_2/
|
||||
HF_TOKENIZER_CLS: T5Tokenizer
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-dev@tokenizer_2/
|
||||
MAX_LENGTH: 512
|
||||
OUTPUT_KEY: last_hidden_state
|
||||
D_TYPE: bfloat16
|
||||
BATCH_INFER: False
|
||||
CLEAN: whitespace
|
||||
CLIP_MODEL:
|
||||
NAME: HFEmbedder
|
||||
HF_MODEL_CLS: CLIPTextModel
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-dev@text_encoder/
|
||||
HF_TOKENIZER_CLS: CLIPTokenizer
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-dev@tokenizer/
|
||||
MAX_LENGTH: 77
|
||||
OUTPUT_KEY: pooler_output
|
||||
D_TYPE: bfloat16
|
||||
BATCH_INFER: True
|
||||
CLEAN: whitespace
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLE_STEPS: 50
|
||||
SAMPLER: flow_euler
|
||||
SEED: 2024
|
||||
IMAGE_SIZE: [ 1024, 1024 ]
|
||||
GUIDE_SCALE: 3.5
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 4e-4
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
AMSGRAD: False
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: ImageTextPairMSDataset
|
||||
MODE: train
|
||||
MS_DATASET_NAME: style_custom_dataset
|
||||
MS_DATASET_NAMESPACE: damo
|
||||
MS_DATASET_SUBNAME: 3D
|
||||
PROMPT_PREFIX: ""
|
||||
MS_DATASET_SPLIT: train
|
||||
MS_REMAP_KEYS: { 'Image:FILE': 'Target:FILE' }
|
||||
REPLACE_STYLE: False
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
TRANSFORMS:
|
||||
- NAME: LoadImageFromFile
|
||||
RGB_ORDER: RGB
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleResize
|
||||
INTERPOLATION: bilinear
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleCenterCrop
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: ImageToTensor
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: Normalize
|
||||
MEAN: [ 0.5, 0.5, 0.5 ]
|
||||
STD: [ 0.5, 0.5, 0.5 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'image' ]
|
||||
BACKEND: torchvision
|
||||
- NAME: Select
|
||||
KEYS: [ 'image', 'prompt' ]
|
||||
META_KEYS: [ 'data_key' ]
|
||||
#
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "a boy wearing a jacket", "a dog running on the lawn" ]
|
||||
IMAGE_SIZE: [ 1024, 1024 ]
|
||||
FIELDS: [ "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: ''
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 2
|
||||
NUM_WORKERS: 4
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'index', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
- NAME: BackwardHook
|
||||
# GRADIENT_CLIP: 1.0
|
||||
PRIORITY: 10
|
||||
- NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
-
|
||||
NAME: TensorboardLogHook
|
||||
-
|
||||
NAME: CheckpointHook
|
||||
INTERVAL: 10000
|
||||
PRIORITY: 200
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
DISABLE_SNAPSHOT: True
|
||||
EVAL_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
@@ -0,0 +1,267 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 166666
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionSolver
|
||||
MAX_STEPS: 100000
|
||||
USE_AMP: True
|
||||
DTYPE: bfloat16
|
||||
USE_FAIRSCALE: False
|
||||
USE_FSDP: True
|
||||
LOAD_MODEL_ONLY: False
|
||||
ENABLE_GRADSCALER: False
|
||||
USE_SCALER: False
|
||||
RESUME_FROM:
|
||||
WORK_DIR: ./cache/save_data/dit_flux_schnell_1024_lora
|
||||
LOG_FILE: std_log.txt
|
||||
EVAL_INTERVAL: 100
|
||||
LOG_TRAIN_NUM: 16
|
||||
FSDP_REDUCE_DTYPE: float32
|
||||
FSDP_BUFFER_DTYPE: float32
|
||||
FSDP_SHARD_MODULES: [ 'model', 'cond_stage_model.t5_model' ] #
|
||||
SAVE_MODULES: [ 'model']
|
||||
TRAIN_MODULES: ['model']
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
FREEZE:
|
||||
TUNER:
|
||||
- NAME: SwiftLoRA
|
||||
R: 4
|
||||
LORA_ALPHA: 4
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "(model.double_blocks.*(.qkv|.proj|.img_mod.lin|.txt_mod.lin))|(model.single_blocks.*(.linear1|.linear2|.modulation.lin))$"
|
||||
##
|
||||
MODEL:
|
||||
NAME: LatentDiffusionFlux
|
||||
PARAMETERIZATION: rf
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA:
|
||||
ZERO_TERMINAL_SNR: False
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
NAME: DiffusionFluxRF
|
||||
PREDICTION_TYPE: raw
|
||||
NOISE_SCHEDULER:
|
||||
NAME: FlowMatchSigmaScheduler
|
||||
# WEIGHTING_SCHEME DESCRIPTION: The weighting scheme for sampling timesteps, choose from ['sigma_sqrt', 'logit_normal', 'mode', 'cosmap', 'none']. TYPE: str default: 'logit_normal'
|
||||
WEIGHTING_SCHEME: logit_normal
|
||||
SHIFT: 3.0
|
||||
# LOGIT_MEAN DESCRIPTION: The mean of the logit distribution for sampling timesteps. TYPE: float default: 0.0
|
||||
LOGIT_MEAN: 0.0
|
||||
# LOGIT_STD DESCRIPTION: The standard deviation of the logit distribution for sampling timesteps. TYPE: float default: 1.0
|
||||
LOGIT_STD: 1.0
|
||||
# MODE_SCALE DESCRIPTION: The scale factor for the mode of the logit distribution for sampling timesteps. TYPE: float default: 1.29
|
||||
MODE_SCALE: 1.29
|
||||
SAMPLER_SCHEDULER:
|
||||
# NAME DESCRIPTION: TYPE: default: 'FlowMatchFluxShiftScheduler'
|
||||
NAME: FlowMatchFluxShiftScheduler
|
||||
# SHIFT DESCRIPTION: Use timestamp shift or not, default is True. TYPE: bool default: True
|
||||
SHIFT: False
|
||||
# SIGMOID_SCALE DESCRIPTION: The scale of sigmoid function for sampling timesteps. TYPE: int default: 1
|
||||
SIGMOID_SCALE: 1
|
||||
# BASE_SHIFT DESCRIPTION: The base shift factor for the timestamp. TYPE: float default: 0.5
|
||||
BASE_SHIFT: 0.5
|
||||
# MAX_SHIFT DESCRIPTION: The max shift factor for the timestamp. TYPE: float default: 1.15
|
||||
MAX_SHIFT: 1.15
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'Flux'
|
||||
NAME: Flux
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-schnell@flux1-schnell.safetensors
|
||||
# IN_CHANNELS DESCRIPTION: model's input channels. TYPE: int default: 64
|
||||
IN_CHANNELS: 64
|
||||
# HIDDEN_SIZE DESCRIPTION: model's hidden size. TYPE: int default: 1024
|
||||
HIDDEN_SIZE: 3072
|
||||
# NUM_HEADS DESCRIPTION: number of heads in the transformer. TYPE: int default: 16
|
||||
NUM_HEADS: 24
|
||||
# AXES_DIM DESCRIPTION: dimensions of the axes of the positional encoding. TYPE: list default: [16, 56, 56]
|
||||
AXES_DIM: [ 16, 56, 56 ]
|
||||
# THETA DESCRIPTION: theta for positional encoding. TYPE: int default: 10000
|
||||
THETA: 10000
|
||||
# VEC_IN_DIM DESCRIPTION: dimension of the vector input. TYPE: int default: 768
|
||||
VEC_IN_DIM: 768
|
||||
# GUIDANCE_EMBED DESCRIPTION: whether to use guidance embedding. TYPE: bool default: False
|
||||
GUIDANCE_EMBED: False
|
||||
# CONTEXT_IN_DIM DESCRIPTION: dimension of the context input. TYPE: int default: 4096
|
||||
CONTEXT_IN_DIM: 4096
|
||||
# MLP_RATIO DESCRIPTION: ratio of mlp hidden size to hidden size. TYPE: float default: 4.0
|
||||
MLP_RATIO: 4.0
|
||||
# QKV_BIAS DESCRIPTION: whether to use bias in qkv projection. TYPE: bool default: True
|
||||
QKV_BIAS: True
|
||||
# DEPTH DESCRIPTION: number of transformer blocks. TYPE: int default: 19
|
||||
DEPTH: 19
|
||||
# DEPTH_SINGLE_BLOCKS DESCRIPTION: number of transformer blocks in the single stream block. TYPE: int default: 38
|
||||
DEPTH_SINGLE_BLOCKS: 38
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLFlux
|
||||
EMBED_DIM: 16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-schnell@ae.safetensors
|
||||
IGNORE_KEYS: [ ]
|
||||
BATCH_SIZE: 8
|
||||
USE_CONV: False
|
||||
SCALE_FACTOR: 0.3611
|
||||
SHIFT_FACTOR: 0.1159
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5PlusClipFluxEmbedder
|
||||
T5_MODEL:
|
||||
NAME: HFEmbedder
|
||||
HF_MODEL_CLS: T5EncoderModel
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-schnell@text_encoder_2/
|
||||
HF_TOKENIZER_CLS: T5Tokenizer
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-schnell@tokenizer_2/
|
||||
MAX_LENGTH: 256
|
||||
OUTPUT_KEY: last_hidden_state
|
||||
D_TYPE: bfloat16
|
||||
BATCH_INFER: False
|
||||
CLEAN: whitespace
|
||||
CLIP_MODEL:
|
||||
NAME: HFEmbedder
|
||||
HF_MODEL_CLS: CLIPTextModel
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-schnell@text_encoder/
|
||||
HF_TOKENIZER_CLS: CLIPTokenizer
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-schnell@tokenizer/
|
||||
MAX_LENGTH: 77
|
||||
OUTPUT_KEY: pooler_output
|
||||
D_TYPE: bfloat16
|
||||
BATCH_INFER: True
|
||||
CLEAN: whitespace
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLE_STEPS: 4
|
||||
SAMPLER: flow_euler
|
||||
SEED: 2024
|
||||
IMAGE_SIZE: [ 1024, 1024 ]
|
||||
GUIDE_SCALE: 3.5
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 4e-4
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
AMSGRAD: False
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: ImageTextPairMSDataset
|
||||
MODE: train
|
||||
MS_DATASET_NAME: style_custom_dataset
|
||||
MS_DATASET_NAMESPACE: damo
|
||||
MS_DATASET_SUBNAME: 3D
|
||||
PROMPT_PREFIX: ""
|
||||
MS_DATASET_SPLIT: train
|
||||
MS_REMAP_KEYS: { 'Image:FILE': 'Target:FILE' }
|
||||
REPLACE_STYLE: False
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
TRANSFORMS:
|
||||
- NAME: LoadImageFromFile
|
||||
RGB_ORDER: RGB
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleResize
|
||||
INTERPOLATION: bilinear
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleCenterCrop
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: ImageToTensor
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: Normalize
|
||||
MEAN: [ 0.5, 0.5, 0.5 ]
|
||||
STD: [ 0.5, 0.5, 0.5 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'image' ]
|
||||
BACKEND: torchvision
|
||||
- NAME: Select
|
||||
KEYS: [ 'image', 'prompt' ]
|
||||
META_KEYS: [ 'data_key' ]
|
||||
#
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "a boy wearing a jacket", "a dog running on the lawn" ]
|
||||
IMAGE_SIZE: [ 1024, 1024 ]
|
||||
FIELDS: [ "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: ''
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 2
|
||||
NUM_WORKERS: 4
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'index', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
- NAME: BackwardHook
|
||||
# GRADIENT_CLIP: 1.0
|
||||
PRIORITY: 10
|
||||
- NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
-
|
||||
NAME: TensorboardLogHook
|
||||
-
|
||||
NAME: CheckpointHook
|
||||
INTERVAL: 10000
|
||||
PRIORITY: 200
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
DISABLE_SNAPSHOT: True
|
||||
EVAL_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
@@ -168,13 +168,13 @@ SOLVER:
|
||||
RGB_ORDER: RGB
|
||||
BACKEND: pillow
|
||||
- NAME: Resize
|
||||
SIZE: 768
|
||||
SIZE: 512
|
||||
INTERPOLATION: bilinear
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: CenterCrop
|
||||
SIZE: 768
|
||||
SIZE: 512
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
@@ -216,13 +216,13 @@ SOLVER:
|
||||
RGB_ORDER: RGB
|
||||
BACKEND: pillow
|
||||
- NAME: Resize
|
||||
SIZE: 768
|
||||
SIZE: 512
|
||||
INTERPOLATION: bilinear
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: CenterCrop
|
||||
SIZE: 768
|
||||
SIZE: 512
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
|
||||
@@ -0,0 +1,25 @@
|
||||
WORK_DIR: chatbot
|
||||
FILE_SYSTEM:
|
||||
- NAME: LocalFs
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
- NAME: ModelscopeFs
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
- NAME: HuggingfaceFs
|
||||
TEMP_DIR: ./cache/cache_data
|
||||
#
|
||||
ENABLE_I2V: False
|
||||
SKIP_EXAMPLES: True
|
||||
#
|
||||
MODEL:
|
||||
EDIT_MODEL:
|
||||
MODEL_CFG_DIR: scepter/methods/studio/chatbot/models/
|
||||
I2V:
|
||||
MODEL_NAME: CogVideoX-5b-I2V
|
||||
MODEL_DIR: ms://ZhipuAI/CogVideoX-5b-I2V/
|
||||
CAPTIONER:
|
||||
MODEL_NAME: InternVL2-2B
|
||||
MODEL_DIR: ms://OpenGVLab/InternVL2-2B/
|
||||
PROMPT: '<image>\nThis image is the first frame of a video. Based on this image, please imagine what changes may occur in the next few seconds of the video. Please output brief description, such as "a dog running" or "a person turns to left". No more than 30 words.'
|
||||
ENHANCER:
|
||||
MODEL_NAME: Meta-Llama-3.1-8B-Instruct
|
||||
MODEL_DIR: ms://LLM-Research/Meta-Llama-3.1-8B-Instruct/
|
||||
@@ -0,0 +1,128 @@
|
||||
NAME: ACE_0.6B_1024
|
||||
IS_DEFAULT: False
|
||||
USE_DYNAMIC_MODEL: True
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
#
|
||||
INPUT:
|
||||
INPUT_IMAGE:
|
||||
INPUT_MASK:
|
||||
TASK:
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT: ""
|
||||
OUTPUT_HEIGHT: 1024
|
||||
OUTPUT_WIDTH: 1024
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
GUIDE_SCALE: 4.5
|
||||
GUIDE_RESCALE: 0.5
|
||||
SEED: -1
|
||||
TAR_INDEX: 0
|
||||
OUTPUT:
|
||||
LATENT:
|
||||
IMAGES:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: encode
|
||||
DTYPE: float16
|
||||
INPUT: ["IMAGE"]
|
||||
- NAME: decode
|
||||
DTYPE: float16
|
||||
INPUT: ["LATENT"]
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: forward
|
||||
DTYPE: float16
|
||||
INPUT: ["SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE"]
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: encode_list_of_list
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["PROMPT"]
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionACE
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
SCALE_FACTOR: 0.18215
|
||||
SIZE_FACTOR: 8
|
||||
DECODER_BIAS: 0.5
|
||||
DEFAULT_N_PROMPT: ""
|
||||
TEXT_IDENTIFIER: [ '{image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
USE_TEXT_POS_EMBEDDINGS: True
|
||||
#
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: eps
|
||||
MIN_SNR_GAMMA:
|
||||
NOISE_SCHEDULER:
|
||||
NAME: LinearScheduler
|
||||
NUM_TIMESTEPS: 1000
|
||||
BETA_MIN: 0.0001
|
||||
BETA_MAX: 0.02
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: ACE
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/dit/ace_0.6b_1024px.pth
|
||||
IGNORE_KEYS: [ ]
|
||||
PATCH_SIZE: 2
|
||||
IN_CHANNELS: 4
|
||||
HIDDEN_SIZE: 1152
|
||||
DEPTH: 28
|
||||
NUM_HEADS: 16
|
||||
MLP_RATIO: 4.0
|
||||
PRED_SIGMA: True
|
||||
DROP_PATH: 0.0
|
||||
WINDOW_DIZE: 0
|
||||
Y_CHANNELS: 4096
|
||||
MAX_SEQ_LEN: 4096
|
||||
QK_NORM: True
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
ATTENTION_BACKEND: flash_attn
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKL
|
||||
EMBED_DIM: 4
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/vae/vae.bin
|
||||
IGNORE_KEYS: []
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/text_encoder/t5-v1_1-xxl/
|
||||
TOKENIZER_PATH: ms://iic/ACE-0.6B-1024px@models/tokenizer/t5-v1_1-xxl
|
||||
LENGTH: 120
|
||||
T5_DTYPE: bfloat16
|
||||
ADDED_IDENTIFIER: [ '{image}', '{caption}', '{mask}', '{ref_image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
CLEAN: whitespace
|
||||
USE_GRAD: False
|
||||
@@ -0,0 +1,284 @@
|
||||
NAME: ACE_0.6B_1024_REFINER
|
||||
IS_DEFAULT: False
|
||||
USE_DYNAMIC_MODEL: True
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
#
|
||||
INPUT:
|
||||
INPUT_IMAGE:
|
||||
INPUT_MASK:
|
||||
TASK:
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT: ""
|
||||
OUTPUT_HEIGHT: 1024
|
||||
OUTPUT_WIDTH: 1024
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
GUIDE_SCALE: 4.5
|
||||
GUIDE_RESCALE: 0.5
|
||||
SEED: -1
|
||||
TAR_INDEX: 0
|
||||
REFINER_SCALE: 0.2
|
||||
USE_ACE: True
|
||||
#REFINER_PROMPT: "High Resolution, Sharpness, Clarity, Detail Enhancement, Noise Reduction, HD, 4k, Image Restoration, HDR"
|
||||
REFINER_PROMPT: "High Resolution, Sharpness, Clarity, Detail Enhancement, Noise Reduction, HD, 4k, Image Restoration, HDR"
|
||||
OUTPUT:
|
||||
LATENT:
|
||||
IMAGES:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: encode
|
||||
DTYPE: float16
|
||||
INPUT: ["IMAGE"]
|
||||
- NAME: decode
|
||||
DTYPE: float16
|
||||
INPUT: ["LATENT"]
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: forward
|
||||
DTYPE: float16
|
||||
INPUT: ["SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE"]
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: encode_list_of_list
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["PROMPT"]
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionACE
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
SCALE_FACTOR: 0.18215
|
||||
SIZE_FACTOR: 8
|
||||
DECODER_BIAS: 0.5
|
||||
DEFAULT_N_PROMPT: ""
|
||||
TEXT_IDENTIFIER: [ '{image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
USE_TEXT_POS_EMBEDDINGS: True
|
||||
#
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: eps
|
||||
MIN_SNR_GAMMA:
|
||||
NOISE_SCHEDULER:
|
||||
NAME: LinearScheduler
|
||||
NUM_TIMESTEPS: 1000
|
||||
BETA_MIN: 0.0001
|
||||
BETA_MAX: 0.02
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: ACE
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/dit/ace_0.6b_1024px.pth
|
||||
IGNORE_KEYS: [ ]
|
||||
PATCH_SIZE: 2
|
||||
IN_CHANNELS: 4
|
||||
HIDDEN_SIZE: 1152
|
||||
DEPTH: 28
|
||||
NUM_HEADS: 16
|
||||
MLP_RATIO: 4.0
|
||||
PRED_SIGMA: True
|
||||
DROP_PATH: 0.0
|
||||
WINDOW_DIZE: 0
|
||||
Y_CHANNELS: 4096
|
||||
MAX_SEQ_LEN: 4096
|
||||
QK_NORM: True
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
ATTENTION_BACKEND: flash_attn
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKL
|
||||
EMBED_DIM: 4
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/vae/vae.bin
|
||||
IGNORE_KEYS: []
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-1024px@models/text_encoder/t5-v1_1-xxl/
|
||||
TOKENIZER_PATH: ms://iic/ACE-0.6B-1024px@models/tokenizer/t5-v1_1-xxl
|
||||
LENGTH: 120
|
||||
T5_DTYPE: bfloat16
|
||||
ADDED_IDENTIFIER: [ '{image}', '{caption}', '{mask}', '{ref_image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
CLEAN: whitespace
|
||||
USE_GRAD: False
|
||||
|
||||
ACE_PROMPT: [
|
||||
"A cute cartoon rabbit holding a whiteboard that says 'ACE Refiner', standing in a sunny meadow filled with flowers, with a big smile and bright colors.",
|
||||
"A beautiful young woman with long flowing hair, wearing a summer dress, holding a whiteboard that reads 'ACE Refiner' while sitting on a park bench surrounded by cherry blossoms.",
|
||||
"An adorable cartoon cat wearing oversized glasses, holding a whiteboard that says 'ACE Refiner', perched on a stack of colorful books in a cozy library setting.",
|
||||
"A charming girl with pigtails, wearing a cute school uniform, enthusiastically holding a whiteboard that has 'ACE Refiner' written on it, in a bright and cheerful classroom full of educational posters.",
|
||||
"A friendly cartoon dog with floppy ears, sitting in front of a doghouse, proudly holding a whiteboard that says 'ACE Refiner', with a playful expression and a blue sky in the background.",
|
||||
"A cute anime girl with big expressive eyes, dressed in a colorful outfit, holding a whiteboard that reads 'ACE Refiner' in a fantastical landscape filled with mythical creatures.",
|
||||
"A vibrant cartoon fox holding a whiteboard that says 'ACE Refiner', standing on a rock by a sparkling stream, surrounded by lush greenery and butterflies.",
|
||||
"A stylish young woman in a business outfit, smiling as she holds a whiteboard written with 'ACE Refiner', in a modern office filled with plants and natural light.",
|
||||
"A cute cartoon unicorn holding a sparkling whiteboard that says 'ACE Refiner', frolicking in a magical forest, with rainbows and stars in the background.",
|
||||
"A happy family, consisting of a cute little girl and her playful puppy, holding a whiteboard that says 'ACE Refiner', together in their backyard on a sunny day."
|
||||
]
|
||||
REFINER_MODEL:
|
||||
NAME: ""
|
||||
IS_DEFAULT: False
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
RESOLUTIONS: [ [ 1024, 1024 ] ]
|
||||
INPUT:
|
||||
INPUT_IMAGE:
|
||||
INPUT_MASK:
|
||||
TASK:
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT: ""
|
||||
OUTPUT_HEIGHT: 1024
|
||||
OUTPUT_WIDTH: 1024
|
||||
SAMPLER: flow_euler
|
||||
SAMPLE_STEPS: 30
|
||||
GUIDE_SCALE: 3.5
|
||||
GUIDE_RESCALE:
|
||||
OUTPUT:
|
||||
LATENT:
|
||||
IMAGES:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: encode
|
||||
DTYPE: bfloat16
|
||||
INPUT: [ "IMAGE" ]
|
||||
- NAME: decode
|
||||
DTYPE: bfloat16
|
||||
INPUT: [ "LATENT" ]
|
||||
PARAS:
|
||||
SCALE_FACTOR: 1.5305
|
||||
SHIFT_FACTOR: 0.0609
|
||||
SIZE_FACTOR: 8
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: forward
|
||||
DTYPE: bfloat16
|
||||
INPUT: [ "SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE" ]
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: encode
|
||||
DTYPE: bfloat16
|
||||
INPUT: [ "PROMPT" ]
|
||||
|
||||
MODEL:
|
||||
DIFFUSION:
|
||||
NAME: DiffusionFluxRF
|
||||
PREDICTION_TYPE: raw
|
||||
NOISE_SCHEDULER:
|
||||
NAME: FlowMatchSigmaScheduler
|
||||
WEIGHTING_SCHEME: logit_normal
|
||||
SHIFT: 3.0
|
||||
LOGIT_MEAN: 0.0
|
||||
LOGIT_STD: 1.0
|
||||
MODE_SCALE: 1.29
|
||||
DIFFUSION_MODEL:
|
||||
NAME: FluxMR
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-dev@flux1-dev.safetensors
|
||||
IN_CHANNELS: 64
|
||||
OUT_CHANNELS: 64
|
||||
HIDDEN_SIZE: 3072
|
||||
NUM_HEADS: 24
|
||||
AXES_DIM: [ 16, 56, 56 ]
|
||||
THETA: 10000
|
||||
VEC_IN_DIM: 768
|
||||
GUIDANCE_EMBED: True
|
||||
CONTEXT_IN_DIM: 4096
|
||||
MLP_RATIO: 4.0
|
||||
QKV_BIAS: True
|
||||
DEPTH: 19
|
||||
DEPTH_SINGLE_BLOCKS: 38
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
ATTN_BACKEND: flash_attn
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLFlux
|
||||
EMBED_DIM: 16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-dev@ae.safetensors
|
||||
IGNORE_KEYS: [ ]
|
||||
BATCH_SIZE: 8
|
||||
USE_CONV: False
|
||||
SCALE_FACTOR: 0.3611
|
||||
SHIFT_FACTOR: 0.1159
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
USE_CHECKPOINT: False
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
USE_CHECKPOINT: False
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5PlusClipFluxEmbedder
|
||||
T5_MODEL:
|
||||
NAME: HFEmbedder
|
||||
HF_MODEL_CLS: T5EncoderModel
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-dev@text_encoder_2/
|
||||
HF_TOKENIZER_CLS: T5Tokenizer
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-dev@tokenizer_2/
|
||||
MAX_LENGTH: 512
|
||||
OUTPUT_KEY: last_hidden_state
|
||||
D_TYPE: bfloat16
|
||||
BATCH_INFER: False
|
||||
CLEAN: whitespace
|
||||
CLIP_MODEL:
|
||||
NAME: HFEmbedder
|
||||
HF_MODEL_CLS: CLIPTextModel
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-dev@text_encoder/
|
||||
HF_TOKENIZER_CLS: CLIPTokenizer
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-dev@tokenizer/
|
||||
MAX_LENGTH: 77
|
||||
OUTPUT_KEY: pooler_output
|
||||
D_TYPE: bfloat16
|
||||
BATCH_INFER: True
|
||||
CLEAN: whitespace
|
||||
@@ -0,0 +1,128 @@
|
||||
NAME: ACE_0.6B_512
|
||||
IS_DEFAULT: True
|
||||
USE_DYNAMIC_MODEL: True
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
#
|
||||
INPUT:
|
||||
INPUT_IMAGE:
|
||||
INPUT_MASK:
|
||||
TASK:
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT: ""
|
||||
OUTPUT_HEIGHT: 512
|
||||
OUTPUT_WIDTH: 512
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 20
|
||||
GUIDE_SCALE: 4.5
|
||||
GUIDE_RESCALE: 0.5
|
||||
SEED: -1
|
||||
TAR_INDEX: 0
|
||||
OUTPUT:
|
||||
LATENT:
|
||||
IMAGES:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: encode
|
||||
DTYPE: float16
|
||||
INPUT: ["IMAGE"]
|
||||
- NAME: decode
|
||||
DTYPE: float16
|
||||
INPUT: ["LATENT"]
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: forward
|
||||
DTYPE: float16
|
||||
INPUT: ["SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE"]
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
- NAME: encode_list_of_list
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["PROMPT"]
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionACE
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
SCALE_FACTOR: 0.18215
|
||||
SIZE_FACTOR: 8
|
||||
DECODER_BIAS: 0.5
|
||||
DEFAULT_N_PROMPT: ""
|
||||
TEXT_IDENTIFIER: [ '{image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
USE_TEXT_POS_EMBEDDINGS: True
|
||||
#
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: eps
|
||||
MIN_SNR_GAMMA:
|
||||
NOISE_SCHEDULER:
|
||||
NAME: LinearScheduler
|
||||
NUM_TIMESTEPS: 1000
|
||||
BETA_MIN: 0.0001
|
||||
BETA_MAX: 0.02
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: ACE
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-512px@models/dit/ace_0.6b_512px.pth
|
||||
IGNORE_KEYS: [ ]
|
||||
PATCH_SIZE: 2
|
||||
IN_CHANNELS: 4
|
||||
HIDDEN_SIZE: 1152
|
||||
DEPTH: 28
|
||||
NUM_HEADS: 16
|
||||
MLP_RATIO: 4.0
|
||||
PRED_SIGMA: True
|
||||
DROP_PATH: 0.0
|
||||
WINDOW_DIZE: 0
|
||||
Y_CHANNELS: 4096
|
||||
MAX_SEQ_LEN: 1024
|
||||
QK_NORM: True
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
ATTENTION_BACKEND: flash_attn
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKL
|
||||
EMBED_DIM: 4
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-512px@models/vae/vae.bin
|
||||
IGNORE_KEYS: []
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 4
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://iic/ACE-0.6B-512px@models/text_encoder/t5-v1_1-xxl/
|
||||
TOKENIZER_PATH: ms://iic/ACE-0.6B-512px@models/tokenizer/t5-v1_1-xxl
|
||||
LENGTH: 120
|
||||
T5_DTYPE: bfloat16
|
||||
ADDED_IDENTIFIER: [ '{image}', '{caption}', '{mask}', '{ref_image}', '{image1}', '{image2}', '{image3}', '{image4}', '{image5}', '{image6}', '{image7}', '{image8}', '{image9}' ]
|
||||
CLEAN: whitespace
|
||||
USE_GRAD: False
|
||||
@@ -0,0 +1,152 @@
|
||||
NAME: COGVIDEOX_2B
|
||||
IS_DEFAULT: False
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
RESOLUTIONS: [[480, 720]]
|
||||
INPUT:
|
||||
IMAGE:
|
||||
ORIGINAL_SIZE_AS_TUPLE: [480, 720]
|
||||
TARGET_SIZE_AS_TUPLE: [480, 720]
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT: ""
|
||||
PROMPT_PREFIX: ""
|
||||
SAMPLE: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
GUIDE_SCALE: 6.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
DISCRETIZATION: trailing
|
||||
NUM_FRAMES:
|
||||
DEFAULT: 49
|
||||
VISIBLE: True
|
||||
FPS:
|
||||
DEFAULT: 8
|
||||
VISIBLE: True
|
||||
OUTPUT:
|
||||
VIDEOS:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: decode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["LATENT"]
|
||||
PARAS:
|
||||
SCALING_FACTOR_IMAGE: 1.15258426
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: forward
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE", "GUIDE_RESCALE", "DISCRETIZATION", "NUM_FRAMES", "FPS"]
|
||||
PARAS:
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: False
|
||||
PATCH_SIZE: 2
|
||||
LATENT_CHANNELS: 16
|
||||
SCALE_FACTOR_SPATIAL: 8
|
||||
SCALE_FACTOR_TEMPORAL: 4
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: encode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["PROMPT"]
|
||||
#
|
||||
MODEL:
|
||||
PRETRAINED_MODEL:
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: v
|
||||
NOISE_SCHEDULER:
|
||||
NAME: ScaledLinearScheduler
|
||||
BETA_MIN: 0.00085
|
||||
BETA_MAX: 0.012
|
||||
SNR_SHIFT_SCALE: 3.0
|
||||
RESCALE_BETAS_ZERO_SNR: True
|
||||
DIFFUSION_SAMPLERS:
|
||||
NAME: DDIMSampler
|
||||
DISCRETIZATION_TYPE: trailing
|
||||
ETA: 0.0
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: CogVideoXTransformer3DModel
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-2b@transformer/diffusion_pytorch_model.safetensors
|
||||
NUM_ATTENTION_HEADS: 30
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 16
|
||||
FLIP_SIN_TO_COS: True
|
||||
FREQ_SHIFT: 0
|
||||
TIME_EMBED_DIM: 512
|
||||
TEXT_EMBED_DIM: 4096
|
||||
NUM_LAYERS: 30
|
||||
DROPOUT: 0.0
|
||||
ATTENTION_BIAS: True
|
||||
SAMPLE_WIDTH: 90
|
||||
SAMPLE_HEIGHT: 60
|
||||
SAMPLE_FRAMES: 49
|
||||
PATCH_SIZE: 2
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
MAX_TEXT_SEQ_LENGTH: 226
|
||||
ACTIVATION_FN: "gelu-approximate"
|
||||
TIMESTEP_ACTIVATION_FN: "silu"
|
||||
NORM_ELEMENTWISE_AFFINE: True
|
||||
NORM_EPS: 1e-5
|
||||
SPATIAL_INTERPOLATION_SCALE: 1.875
|
||||
TEMPORAL_INTERPOLATION_SCALE: 1.0
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: False
|
||||
USE_LEARNED_POSITIONAL_EMBEDDINGS: False
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-2b@vae/diffusion_pytorch_model.safetensors
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
LENGTH: 226
|
||||
CLEAN:
|
||||
USE_GRAD: False
|
||||
T5_DTYPE: bfloat16
|
||||
@@ -0,0 +1,154 @@
|
||||
NAME: COGVIDEOX_5B
|
||||
IS_DEFAULT: False
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
RESOLUTIONS: [[480, 720]]
|
||||
INPUT:
|
||||
IMAGE:
|
||||
ORIGINAL_SIZE_AS_TUPLE: [480, 720]
|
||||
TARGET_SIZE_AS_TUPLE: [480, 720]
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT: ""
|
||||
PROMPT_PREFIX: ""
|
||||
SAMPLE: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
GUIDE_SCALE: 6.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
DISCRETIZATION: trailing
|
||||
NUM_FRAMES:
|
||||
DEFAULT: 49
|
||||
VISIBLE: True
|
||||
FPS:
|
||||
DEFAULT: 8
|
||||
VISIBLE: True
|
||||
OUTPUT:
|
||||
VIDEOS:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: decode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["LATENT"]
|
||||
PARAS:
|
||||
SCALING_FACTOR_IMAGE: 0.7 # 5b diff
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: forward
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE", "GUIDE_RESCALE", "DISCRETIZATION", "NUM_FRAMES", "FPS"]
|
||||
PARAS:
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: True
|
||||
PATCH_SIZE: 2
|
||||
LATENT_CHANNELS: 16
|
||||
SCALE_FACTOR_SPATIAL: 8
|
||||
SCALE_FACTOR_TEMPORAL: 4
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: encode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["PROMPT"]
|
||||
#
|
||||
MODEL:
|
||||
PRETRAINED_MODEL:
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: v
|
||||
NOISE_SCHEDULER:
|
||||
NAME: ScaledLinearScheduler
|
||||
BETA_MIN: 0.00085
|
||||
BETA_MAX: 0.012
|
||||
SNR_SHIFT_SCALE: 1.0 # 5b diff
|
||||
RESCALE_BETAS_ZERO_SNR: True
|
||||
DIFFUSION_SAMPLERS:
|
||||
NAME: DDIMSampler
|
||||
DISCRETIZATION_TYPE: trailing
|
||||
ETA: 0.0
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: CogVideoXTransformer3DModel
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: # 5b diff
|
||||
- ms://AI-ModelScope/CogVideoX-5b@transformer/diffusion_pytorch_model-00001-of-00002.safetensors
|
||||
- ms://AI-ModelScope/CogVideoX-5b@transformer/diffusion_pytorch_model-00002-of-00002.safetensors
|
||||
NUM_ATTENTION_HEADS: 48 # 5b diff
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 16
|
||||
FLIP_SIN_TO_COS: True
|
||||
FREQ_SHIFT: 0
|
||||
TIME_EMBED_DIM: 512
|
||||
TEXT_EMBED_DIM: 4096
|
||||
NUM_LAYERS: 42 # 5b diff
|
||||
DROPOUT: 0.0
|
||||
ATTENTION_BIAS: True
|
||||
SAMPLE_WIDTH: 90
|
||||
SAMPLE_HEIGHT: 60
|
||||
SAMPLE_FRAMES: 49
|
||||
PATCH_SIZE: 2
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
MAX_TEXT_SEQ_LENGTH: 226
|
||||
ACTIVATION_FN: "gelu-approximate"
|
||||
TIMESTEP_ACTIVATION_FN: "silu"
|
||||
NORM_ELEMENTWISE_AFFINE: True
|
||||
NORM_EPS: 1e-5
|
||||
SPATIAL_INTERPOLATION_SCALE: 1.875
|
||||
TEMPORAL_INTERPOLATION_SCALE: 1.0
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: True # 5b diff
|
||||
USE_LEARNED_POSITIONAL_EMBEDDINGS: False
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-5b@vae/diffusion_pytorch_model.safetensors # 5b diff
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
LENGTH: 226
|
||||
CLEAN:
|
||||
USE_GRAD: False
|
||||
T5_DTYPE: bfloat16
|
||||
@@ -0,0 +1,201 @@
|
||||
NAME: FLUX1.0_DEV
|
||||
IS_DEFAULT: False
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
RESOLUTIONS: [[1024, 1024]]
|
||||
INPUT:
|
||||
IMAGE:
|
||||
ORIGINAL_SIZE_AS_TUPLE: [1024, 1024]
|
||||
TARGET_SIZE_AS_TUPLE: [1024, 1024]
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT:
|
||||
DEFAULT: ""
|
||||
VISIBLE: False
|
||||
PROMPT_PREFIX: ""
|
||||
SAMPLE:
|
||||
VALUES: ["flow_euler"]
|
||||
DEFAULT: "flow_euler"
|
||||
SAMPLE_STEPS: 50
|
||||
GUIDE_SCALE: 3.5
|
||||
GUIDE_RESCALE:
|
||||
DEFAULT: 0.0
|
||||
VISIBLE: False
|
||||
DISCRETIZATION:
|
||||
VALUES: []
|
||||
DEFAULT:
|
||||
VISIBLE: False
|
||||
OUTPUT:
|
||||
LATENT:
|
||||
IMAGES:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: encode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["IMAGE"]
|
||||
-
|
||||
NAME: decode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["LATENT"]
|
||||
PARAS:
|
||||
SCALE_FACTOR: 1.5305
|
||||
SHIFT_FACTOR: 0.0609
|
||||
SIZE_FACTOR: 8
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: forward
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE"]
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: encode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["PROMPT"]
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionFlux
|
||||
PARAMETERIZATION: rf
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA:
|
||||
ZERO_TERMINAL_SNR: False
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
# NAME DESCRIPTION: TYPE: default: 'DiffusionFluxRF'
|
||||
NAME: DiffusionFluxRF
|
||||
PREDICTION_TYPE: raw
|
||||
# NOISE_SCHEDULER DESCRIPTION: TYPE: default: ''
|
||||
NOISE_SCHEDULER:
|
||||
# NAME DESCRIPTION: TYPE: default: 'FlowMatchSigmaScheduler'
|
||||
NAME: FlowMatchSigmaScheduler
|
||||
# WEIGHTING_SCHEME DESCRIPTION: The weighting scheme for sampling timesteps, choose from ['sigma_sqrt', 'logit_normal', 'mode', 'cosmap', 'none']. TYPE: str default: 'logit_normal'
|
||||
WEIGHTING_SCHEME: logit_normal
|
||||
SHIFT: 3.0
|
||||
# LOGIT_MEAN DESCRIPTION: The mean of the logit distribution for sampling timesteps. TYPE: float default: 0.0
|
||||
LOGIT_MEAN: 0.0
|
||||
# LOGIT_STD DESCRIPTION: The standard deviation of the logit distribution for sampling timesteps. TYPE: float default: 1.0
|
||||
LOGIT_STD: 1.0
|
||||
# MODE_SCALE DESCRIPTION: The scale factor for the mode of the logit distribution for sampling timesteps. TYPE: float default: 1.29
|
||||
MODE_SCALE: 1.29
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'Flux'
|
||||
NAME: Flux
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-dev@flux1-dev.safetensors
|
||||
# IN_CHANNELS DESCRIPTION: model's input channels. TYPE: int default: 64
|
||||
IN_CHANNELS: 64
|
||||
# HIDDEN_SIZE DESCRIPTION: model's hidden size. TYPE: int default: 1024
|
||||
HIDDEN_SIZE: 3072
|
||||
# NUM_HEADS DESCRIPTION: number of heads in the transformer. TYPE: int default: 16
|
||||
NUM_HEADS: 24
|
||||
# AXES_DIM DESCRIPTION: dimensions of the axes of the positional encoding. TYPE: list default: [16, 56, 56]
|
||||
AXES_DIM: [ 16, 56, 56 ]
|
||||
# THETA DESCRIPTION: theta for positional encoding. TYPE: int default: 10000
|
||||
THETA: 10000
|
||||
# VEC_IN_DIM DESCRIPTION: dimension of the vector input. TYPE: int default: 768
|
||||
VEC_IN_DIM: 768
|
||||
# GUIDANCE_EMBED DESCRIPTION: whether to use guidance embedding. TYPE: bool default: False
|
||||
GUIDANCE_EMBED: True
|
||||
# CONTEXT_IN_DIM DESCRIPTION: dimension of the context input. TYPE: int default: 4096
|
||||
CONTEXT_IN_DIM: 4096
|
||||
# MLP_RATIO DESCRIPTION: ratio of mlp hidden size to hidden size. TYPE: float default: 4.0
|
||||
MLP_RATIO: 4.0
|
||||
# QKV_BIAS DESCRIPTION: whether to use bias in qkv projection. TYPE: bool default: True
|
||||
QKV_BIAS: True
|
||||
# DEPTH DESCRIPTION: number of transformer blocks. TYPE: int default: 19
|
||||
DEPTH: 19
|
||||
# DEPTH_SINGLE_BLOCKS DESCRIPTION: number of transformer blocks in the single stream block. TYPE: int default: 38
|
||||
DEPTH_SINGLE_BLOCKS: 38
|
||||
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLFlux
|
||||
EMBED_DIM: 16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-dev@ae.safetensors
|
||||
IGNORE_KEYS: [ ]
|
||||
BATCH_SIZE: 8
|
||||
USE_CONV: False
|
||||
SCALE_FACTOR: 0.3611
|
||||
SHIFT_FACTOR: 0.1159
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'T5PlusClipFluxEmbedder'
|
||||
NAME: T5PlusClipFluxEmbedder
|
||||
# T5_MODEL DESCRIPTION: TYPE: default: ''
|
||||
T5_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'HFEmbedder'
|
||||
NAME: HFEmbedder
|
||||
# HF_MODEL_CLS DESCRIPTION: huggingface cls in transfomer TYPE: NoneType default: None
|
||||
HF_MODEL_CLS: T5EncoderModel
|
||||
# MODEL_PATH DESCRIPTION: model folder path TYPE: NoneType default: None
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-dev@text_encoder_2/
|
||||
# HF_TOKENIZER_CLS DESCRIPTION: huggingface cls in transfomer TYPE: NoneType default: None
|
||||
HF_TOKENIZER_CLS: T5Tokenizer
|
||||
# TOKENIZER_PATH DESCRIPTION: tokenizer folder path TYPE: NoneType default: None
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-dev@tokenizer_2/
|
||||
# MAX_LENGTH DESCRIPTION: max length of input TYPE: int default: 77
|
||||
MAX_LENGTH: 512
|
||||
# OUTPUT_KEY DESCRIPTION: output key TYPE: str default: 'last_hidden_state'
|
||||
OUTPUT_KEY: last_hidden_state
|
||||
# D_TYPE DESCRIPTION: dtype TYPE: str default: 'bfloat16'
|
||||
D_TYPE: bfloat16
|
||||
# BATCH_INFER DESCRIPTION: batch infer TYPE: bool default: False
|
||||
BATCH_INFER: False
|
||||
CLEAN: whitespace
|
||||
# CLIP_MODEL DESCRIPTION: TYPE: default: ''
|
||||
CLIP_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'HFEmbedder'
|
||||
NAME: HFEmbedder
|
||||
# HF_MODEL_CLS DESCRIPTION: huggingface cls in transfomer TYPE: NoneType default: None
|
||||
HF_MODEL_CLS: CLIPTextModel
|
||||
# MODEL_PATH DESCRIPTION: model folder path TYPE: NoneType default: None
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-dev@text_encoder/
|
||||
# HF_TOKENIZER_CLS DESCRIPTION: huggingface cls in transfomer TYPE: NoneType default: None
|
||||
HF_TOKENIZER_CLS: CLIPTokenizer
|
||||
# TOKENIZER_PATH DESCRIPTION: tokenizer folder path TYPE: NoneType default: None
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-dev@tokenizer/
|
||||
# MAX_LENGTH DESCRIPTION: max length of input TYPE: int default: 77
|
||||
MAX_LENGTH: 77
|
||||
# OUTPUT_KEY DESCRIPTION: output key TYPE: str default: 'last_hidden_state'
|
||||
OUTPUT_KEY: pooler_output
|
||||
# D_TYPE DESCRIPTION: dtype TYPE: str default: 'bfloat16'
|
||||
D_TYPE: bfloat16
|
||||
# BATCH_INFER DESCRIPTION: batch infer TYPE: bool default: False
|
||||
BATCH_INFER: True
|
||||
CLEAN: whitespace
|
||||
@@ -0,0 +1,212 @@
|
||||
NAME: FLUX1.0_SCHNELL
|
||||
IS_DEFAULT: False
|
||||
DEFAULT_PARAS:
|
||||
PARAS:
|
||||
RESOLUTIONS: [[1024, 1024]]
|
||||
INPUT:
|
||||
IMAGE:
|
||||
ORIGINAL_SIZE_AS_TUPLE: [1024, 1024]
|
||||
TARGET_SIZE_AS_TUPLE: [1024, 1024]
|
||||
PROMPT: ""
|
||||
NEGATIVE_PROMPT:
|
||||
DEFAULT: ""
|
||||
VISIBLE: False
|
||||
PROMPT_PREFIX: ""
|
||||
SAMPLE:
|
||||
VALUES: ["flow_euler"]
|
||||
DEFAULT: "flow_euler"
|
||||
SAMPLE_STEPS: 4
|
||||
GUIDE_SCALE: 3.5
|
||||
GUIDE_RESCALE:
|
||||
DEFAULT: 0.0
|
||||
VISIBLE: False
|
||||
DISCRETIZATION:
|
||||
VALUES: []
|
||||
DEFAULT:
|
||||
VISIBLE: False
|
||||
OUTPUT:
|
||||
LATENT:
|
||||
IMAGES:
|
||||
SEED:
|
||||
MODULES_PARAS:
|
||||
FIRST_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: encode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["IMAGE"]
|
||||
-
|
||||
NAME: decode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["LATENT"]
|
||||
PARAS:
|
||||
SCALE_FACTOR: 1.5305
|
||||
SHIFT_FACTOR: 0.0609
|
||||
SIZE_FACTOR: 8
|
||||
DIFFUSION_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: forward
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["SAMPLE_STEPS", "SAMPLE", "GUIDE_SCALE"]
|
||||
COND_STAGE_MODEL:
|
||||
FUNCTION:
|
||||
-
|
||||
NAME: encode
|
||||
DTYPE: bfloat16
|
||||
INPUT: ["PROMPT"]
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionFlux
|
||||
PARAMETERIZATION: rf
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA:
|
||||
ZERO_TERMINAL_SNR: False
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
# NAME DESCRIPTION: TYPE: default: 'DiffusionFluxRF'
|
||||
NAME: DiffusionFluxRF
|
||||
PREDICTION_TYPE: raw
|
||||
# NOISE_SCHEDULER DESCRIPTION: TYPE: default: ''
|
||||
NOISE_SCHEDULER:
|
||||
# NAME DESCRIPTION: TYPE: default: 'FlowMatchSigmaScheduler'
|
||||
NAME: FlowMatchSigmaScheduler
|
||||
# WEIGHTING_SCHEME DESCRIPTION: The weighting scheme for sampling timesteps, choose from ['sigma_sqrt', 'logit_normal', 'mode', 'cosmap', 'none']. TYPE: str default: 'logit_normal'
|
||||
WEIGHTING_SCHEME: logit_normal
|
||||
SHIFT: 3.0
|
||||
# LOGIT_MEAN DESCRIPTION: The mean of the logit distribution for sampling timesteps. TYPE: float default: 0.0
|
||||
LOGIT_MEAN: 0.0
|
||||
# LOGIT_STD DESCRIPTION: The standard deviation of the logit distribution for sampling timesteps. TYPE: float default: 1.0
|
||||
LOGIT_STD: 1.0
|
||||
# MODE_SCALE DESCRIPTION: The scale factor for the mode of the logit distribution for sampling timesteps. TYPE: float default: 1.29
|
||||
MODE_SCALE: 1.29
|
||||
SAMPLER_SCHEDULER:
|
||||
# NAME DESCRIPTION: TYPE: default: 'FlowMatchFluxShiftScheduler'
|
||||
NAME: FlowMatchFluxShiftScheduler
|
||||
# SHIFT DESCRIPTION: Use timestamp shift or not, default is True. TYPE: bool default: True
|
||||
SHIFT: False
|
||||
# SIGMOID_SCALE DESCRIPTION: The scale of sigmoid function for sampling timesteps. TYPE: int default: 1
|
||||
SIGMOID_SCALE: 1
|
||||
# BASE_SHIFT DESCRIPTION: The base shift factor for the timestamp. TYPE: float default: 0.5
|
||||
BASE_SHIFT: 0.5
|
||||
# MAX_SHIFT DESCRIPTION: The max shift factor for the timestamp. TYPE: float default: 1.15
|
||||
MAX_SHIFT: 1.15
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'Flux'
|
||||
NAME: Flux
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-schnell@flux1-schnell.safetensors
|
||||
# IN_CHANNELS DESCRIPTION: model's input channels. TYPE: int default: 64
|
||||
IN_CHANNELS: 64
|
||||
# HIDDEN_SIZE DESCRIPTION: model's hidden size. TYPE: int default: 1024
|
||||
HIDDEN_SIZE: 3072
|
||||
# NUM_HEADS DESCRIPTION: number of heads in the transformer. TYPE: int default: 16
|
||||
NUM_HEADS: 24
|
||||
# AXES_DIM DESCRIPTION: dimensions of the axes of the positional encoding. TYPE: list default: [16, 56, 56]
|
||||
AXES_DIM: [ 16, 56, 56 ]
|
||||
# THETA DESCRIPTION: theta for positional encoding. TYPE: int default: 10000
|
||||
THETA: 10000
|
||||
# VEC_IN_DIM DESCRIPTION: dimension of the vector input. TYPE: int default: 768
|
||||
VEC_IN_DIM: 768
|
||||
# GUIDANCE_EMBED DESCRIPTION: whether to use guidance embedding. TYPE: bool default: False
|
||||
GUIDANCE_EMBED: False
|
||||
# CONTEXT_IN_DIM DESCRIPTION: dimension of the context input. TYPE: int default: 4096
|
||||
CONTEXT_IN_DIM: 4096
|
||||
# MLP_RATIO DESCRIPTION: ratio of mlp hidden size to hidden size. TYPE: float default: 4.0
|
||||
MLP_RATIO: 4.0
|
||||
# QKV_BIAS DESCRIPTION: whether to use bias in qkv projection. TYPE: bool default: True
|
||||
QKV_BIAS: True
|
||||
# DEPTH DESCRIPTION: number of transformer blocks. TYPE: int default: 19
|
||||
DEPTH: 19
|
||||
# DEPTH_SINGLE_BLOCKS DESCRIPTION: number of transformer blocks in the single stream block. TYPE: int default: 38
|
||||
DEPTH_SINGLE_BLOCKS: 38
|
||||
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLFlux
|
||||
EMBED_DIM: 16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-schnell@ae.safetensors
|
||||
IGNORE_KEYS: [ ]
|
||||
BATCH_SIZE: 8
|
||||
USE_CONV: False
|
||||
SCALE_FACTOR: 0.3611
|
||||
SHIFT_FACTOR: 0.1159
|
||||
#
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
#
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'T5PlusClipFluxEmbedder'
|
||||
NAME: T5PlusClipFluxEmbedder
|
||||
# T5_MODEL DESCRIPTION: TYPE: default: ''
|
||||
T5_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'HFEmbedder'
|
||||
NAME: HFEmbedder
|
||||
# HF_MODEL_CLS DESCRIPTION: huggingface cls in transfomer TYPE: NoneType default: None
|
||||
HF_MODEL_CLS: T5EncoderModel
|
||||
# MODEL_PATH DESCRIPTION: model folder path TYPE: NoneType default: None
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-schnell@text_encoder_2/
|
||||
# HF_TOKENIZER_CLS DESCRIPTION: huggingface cls in transfomer TYPE: NoneType default: None
|
||||
HF_TOKENIZER_CLS: T5Tokenizer
|
||||
# TOKENIZER_PATH DESCRIPTION: tokenizer folder path TYPE: NoneType default: None
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-schnell@tokenizer_2/
|
||||
# MAX_LENGTH DESCRIPTION: max length of input TYPE: int default: 77
|
||||
MAX_LENGTH: 256
|
||||
# OUTPUT_KEY DESCRIPTION: output key TYPE: str default: 'last_hidden_state'
|
||||
OUTPUT_KEY: last_hidden_state
|
||||
# D_TYPE DESCRIPTION: dtype TYPE: str default: 'bfloat16'
|
||||
D_TYPE: bfloat16
|
||||
# BATCH_INFER DESCRIPTION: batch infer TYPE: bool default: False
|
||||
BATCH_INFER: False
|
||||
CLEAN: whitespace
|
||||
# CLIP_MODEL DESCRIPTION: TYPE: default: ''
|
||||
CLIP_MODEL:
|
||||
# NAME DESCRIPTION: TYPE: default: 'HFEmbedder'
|
||||
NAME: HFEmbedder
|
||||
# HF_MODEL_CLS DESCRIPTION: huggingface cls in transfomer TYPE: NoneType default: None
|
||||
HF_MODEL_CLS: CLIPTextModel
|
||||
# MODEL_PATH DESCRIPTION: model folder path TYPE: NoneType default: None
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-schnell@text_encoder/
|
||||
# HF_TOKENIZER_CLS DESCRIPTION: huggingface cls in transfomer TYPE: NoneType default: None
|
||||
HF_TOKENIZER_CLS: CLIPTokenizer
|
||||
# TOKENIZER_PATH DESCRIPTION: tokenizer folder path TYPE: NoneType default: None
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-schnell@tokenizer/
|
||||
# MAX_LENGTH DESCRIPTION: max length of input TYPE: int default: 77
|
||||
MAX_LENGTH: 77
|
||||
# OUTPUT_KEY DESCRIPTION: output key TYPE: str default: 'last_hidden_state'
|
||||
OUTPUT_KEY: pooler_output
|
||||
# D_TYPE DESCRIPTION: dtype TYPE: str default: 'bfloat16'
|
||||
D_TYPE: bfloat16
|
||||
# BATCH_INFER DESCRIPTION: batch infer TYPE: bool default: False
|
||||
BATCH_INFER: True
|
||||
CLEAN: whitespace
|
||||
@@ -1,4 +1,5 @@
|
||||
WORK_DIR: "inference"
|
||||
SKIP_EXAMPLES: True
|
||||
DIFFUSION_PARAS:
|
||||
SAMPLE:
|
||||
VALUES: ['ddim', 'euler', 'euler_ancestral', 'heun', 'dpm2',
|
||||
@@ -6,65 +7,91 @@ DIFFUSION_PARAS:
|
||||
'dpm2_karras', 'dpm2_ancestral_karras', 'dpmpp_2s_ancestral_karras', 'dpmpp_2m_karras',
|
||||
'dpmpp_sde_karras', 'dpmpp_2m_sde_karras']
|
||||
DEFAULT: 'dpmpp_2s_ancestral'
|
||||
VISIBLE: True
|
||||
NEGATIVE_PROMPT:
|
||||
DEFAULT:
|
||||
VISIBLE: True
|
||||
PROMPT_PREFIX:
|
||||
DEFAULT:
|
||||
VISIBLE: True
|
||||
SAMPLES:
|
||||
MIN: 1
|
||||
MAX: 4
|
||||
DEFAULT: 1
|
||||
VISIBLE: True
|
||||
NUM_FRAMES:
|
||||
MIN: 1
|
||||
MAX: 100
|
||||
DEFAULT: 49
|
||||
VISIBLE: False
|
||||
FPS:
|
||||
MIN: 1
|
||||
MAX: 50
|
||||
DEFAULT: 8
|
||||
VISIBLE: False
|
||||
SAMPLE_STEPS:
|
||||
MIN: 1
|
||||
MAX: 100
|
||||
DEFAULT: 30
|
||||
VISIBLE: True
|
||||
GUIDE_SCALE:
|
||||
MIN: 0
|
||||
MAX: 10
|
||||
DEFAULT: 5.0
|
||||
VISIBLE: True
|
||||
GUIDE_RESCALE:
|
||||
MIN: 0
|
||||
MAX: 1.0
|
||||
DEFAULT: 0.5
|
||||
VISIBLE: True
|
||||
DISCRETIZATION:
|
||||
VALUES: ["trailing", "leading", "linspace"]
|
||||
DEFAULT: "linspace"
|
||||
VISIBLE: True
|
||||
REFINE_SAMPLERS:
|
||||
VALUES: [ 'ddim', 'euler', 'euler_ancestral', 'heun', 'dpm2',
|
||||
'dpm2_ancestral', 'dpmpp_2m', 'dpmpp_sde', 'dpmpp_2m_sde', 'dpmpp_2s_ancestral',
|
||||
'dpm2_karras', 'dpm2_ancestral_karras', 'dpmpp_2s_ancestral_karras', 'dpmpp_2m_karras',
|
||||
'dpmpp_sde_karras', 'dpmpp_2m_sde_karras' ]
|
||||
DEFAULT: 'dpmpp_2s_ancestral'
|
||||
VISIBLE: True
|
||||
REFINE_SAMPLE_STEPS:
|
||||
MIN: 0
|
||||
MAX: 100
|
||||
DEFAULT: 30
|
||||
VISIBLE: True
|
||||
REFINE_GUIDE_SCALE:
|
||||
MIN: 0
|
||||
MAX: 10
|
||||
DEFAULT: 5.0
|
||||
VISIBLE: True
|
||||
REFINE_GUIDE_RESCALE:
|
||||
MIN: 0
|
||||
MAX: 1.0
|
||||
DEFAULT: 0.5
|
||||
VISIBLE: True
|
||||
REFINE_DISCRETIZATION:
|
||||
VALUES: [ "trailing", "leading", "linspace" ]
|
||||
DEFAULT: "linspace"
|
||||
VISIBLE: True
|
||||
AESTHETIC_SCORE:
|
||||
MIN: 0.0
|
||||
MAX: 10.0
|
||||
DEFAULT: 6.0
|
||||
VISIBLE: True
|
||||
NEGATIVE_AESTHETIC_SCORE:
|
||||
MIN: 0.0
|
||||
MAX: 10.0
|
||||
DEFAULT: 2.5
|
||||
VISIBLE: True
|
||||
REFINE_STRENGTH:
|
||||
MIN: 0
|
||||
MAX: 1.0
|
||||
DEFAULT: 0.15
|
||||
RESOLUTIONS:
|
||||
VALUES: [ [512, 512], [768, 768],
|
||||
[704, 1408], [704, 1344], [768, 1344],
|
||||
VALUES: [
|
||||
[512, 512], [768, 768],
|
||||
[704, 1408], [704, 1344], [768, 1344],
|
||||
[720, 1280],
|
||||
[768, 1280], [832, 1216], [832, 1152],
|
||||
[896, 1152], [896, 1088], [960, 1088],
|
||||
@@ -74,8 +101,14 @@ DIFFUSION_PARAS:
|
||||
[1280, 768],
|
||||
[1344, 768], [1344, 704], [1408, 704],
|
||||
[1472, 704], [1536, 640], [1600, 640],
|
||||
[1664, 576], [1728, 576]]
|
||||
[1664, 576], [1728, 576],
|
||||
[2048, 2048], [2048, 1920], [1920, 2048],
|
||||
[1536, 2560], [2560, 1536], [2560, 1440],
|
||||
[2560, 1440],
|
||||
[480, 720], [720, 480]
|
||||
]
|
||||
DEFAULT: [1024, 1024]
|
||||
VISIBLE: True
|
||||
EXTENSION_PARAS:
|
||||
MANTRA_BOOK: scepter/methods/studio/extensions/mantra_book/mantra_book.yaml
|
||||
OFFICIAL_TUNERS: scepter/methods/studio/extensions/tuners/official_tuners.yaml
|
||||
|
||||
@@ -2,11 +2,10 @@ WORK_DIR: datasets
|
||||
EXPORT_DIR: export_datasets
|
||||
FILE_SYSTEM:
|
||||
-
|
||||
# NAME DESCRIPTION: TYPE: default: ''
|
||||
NAME: LocalFs
|
||||
AUTO_CLEAN: False
|
||||
|
||||
PROCESSORS:
|
||||
# Caption processor
|
||||
- NAME: BlipImageBase
|
||||
TYPE: caption
|
||||
MODEL_PATH: ms://cubeai/blip-image-captioning-base
|
||||
@@ -15,6 +14,81 @@ PROCESSORS:
|
||||
PARAS:
|
||||
- LANGUAGE_NAME: English
|
||||
LANGUAGE_ZH_NAME: 英语
|
||||
- NAME: InternVL15
|
||||
TYPE: caption
|
||||
MODEL_PATH: ms://AI-ModelScope/InternVL-Chat-V1-5
|
||||
DEVICE: "gpu"
|
||||
MEMORY: 49968
|
||||
PARAS:
|
||||
- PROMPT: 用中文描述这张图片
|
||||
LANGUAGE_NAME: Chinese
|
||||
LANGUAGE_ZH_NAME: 中文
|
||||
- PROMPT: Generate the caption in English
|
||||
LANGUAGE_NAME: English
|
||||
LANGUAGE_ZH_NAME: 英语
|
||||
- NAME: QWVLQuantize
|
||||
TYPE: caption
|
||||
DEVICE: "gpu"
|
||||
MEMORY: 7885
|
||||
MODEL_PATH: ms://qwen/Qwen-VL:v1.0.3
|
||||
PARAS:
|
||||
- PROMPT: 用中文描述这张图片
|
||||
LANGUAGE_NAME: Chinese
|
||||
LANGUAGE_ZH_NAME: 中文
|
||||
MAX_NEW_TOKENS:
|
||||
VALUE: 1024
|
||||
MAX: 2048
|
||||
STEP: 128
|
||||
MIN: 256
|
||||
MIN_NEW_TOKENS:
|
||||
VALUE: 16
|
||||
MAX: 1024
|
||||
STEP: 16
|
||||
MIN: 0
|
||||
NUM_BEAMS:
|
||||
VALUE: 1
|
||||
MAX: 12
|
||||
STEP: 1
|
||||
MIN: 1
|
||||
REPETITION_PENALTY:
|
||||
VALUE: 1.0
|
||||
MAX: 100.0
|
||||
STEP: 1.0
|
||||
MIN: 1.0
|
||||
TEMPERATURE:
|
||||
VALUE: 1.0
|
||||
MAX: 100.0
|
||||
STEP: 1.0
|
||||
MIN: 1.0
|
||||
- PROMPT: Generate the caption in English
|
||||
LANGUAGE_NAME: English
|
||||
LANGUAGE_ZH_NAME: 英语
|
||||
MAX_NEW_TOKENS:
|
||||
VALUE: 1024
|
||||
MAX: 2048
|
||||
STEP: 128
|
||||
MIN: 256
|
||||
MIN_NEW_TOKENS:
|
||||
VALUE: 16
|
||||
MAX: 1024
|
||||
STEP: 16
|
||||
MIN: 0
|
||||
NUM_BEAMS:
|
||||
VALUE: 1
|
||||
MAX: 12
|
||||
STEP: 1
|
||||
MIN: 1
|
||||
REPETITION_PENALTY:
|
||||
VALUE: 1.0
|
||||
MAX: 100.0
|
||||
STEP: 1.0
|
||||
MIN: 1.0
|
||||
TEMPERATURE:
|
||||
VALUE: 1.0
|
||||
MAX: 100.0
|
||||
STEP: 1.0
|
||||
MIN: 1.0
|
||||
|
||||
- NAME: QWVL
|
||||
TYPE: caption
|
||||
MODEL_PATH: ms://qwen/Qwen-VL:v1.0.3
|
||||
@@ -77,75 +151,14 @@ PROCESSORS:
|
||||
MAX: 100.0
|
||||
STEP: 1.0
|
||||
MIN: 1.0
|
||||
-
|
||||
NAME: QWVLQuantize
|
||||
TYPE: caption
|
||||
DEVICE: "gpu"
|
||||
MEMORY: 7885
|
||||
MODEL_PATH: ms://qwen/Qwen-VL:v1.0.3
|
||||
PARAS:
|
||||
- PROMPT: 用中文描述这张图片
|
||||
LANGUAGE_NAME: Chinese
|
||||
LANGUAGE_ZH_NAME: 中文
|
||||
MAX_NEW_TOKENS:
|
||||
VALUE: 1024
|
||||
MAX: 2048
|
||||
STEP: 128
|
||||
MIN: 256
|
||||
MIN_NEW_TOKENS:
|
||||
VALUE: 16
|
||||
MAX: 1024
|
||||
STEP: 16
|
||||
MIN: 0
|
||||
NUM_BEAMS:
|
||||
VALUE: 1
|
||||
MAX: 12
|
||||
STEP: 1
|
||||
MIN: 1
|
||||
REPETITION_PENALTY:
|
||||
VALUE: 1.0
|
||||
MAX: 100.0
|
||||
STEP: 1.0
|
||||
MIN: 1.0
|
||||
TEMPERATURE:
|
||||
VALUE: 1.0
|
||||
MAX: 100.0
|
||||
STEP: 1.0
|
||||
MIN: 1.0
|
||||
- PROMPT: Generate the caption in English
|
||||
LANGUAGE_NAME: English
|
||||
LANGUAGE_ZH_NAME: 英语
|
||||
MAX_NEW_TOKENS:
|
||||
VALUE: 1024
|
||||
MAX: 2048
|
||||
STEP: 128
|
||||
MIN: 256
|
||||
MIN_NEW_TOKENS:
|
||||
VALUE: 16
|
||||
MAX: 1024
|
||||
STEP: 16
|
||||
MIN: 0
|
||||
NUM_BEAMS:
|
||||
VALUE: 1
|
||||
MAX: 12
|
||||
STEP: 1
|
||||
MIN: 1
|
||||
REPETITION_PENALTY:
|
||||
VALUE: 1.0
|
||||
MAX: 100.0
|
||||
STEP: 1.0
|
||||
MIN: 1.0
|
||||
TEMPERATURE:
|
||||
VALUE: 1.0
|
||||
MAX: 100.0
|
||||
STEP: 1.0
|
||||
MIN: 1.0
|
||||
-
|
||||
NAME: CenterCrop
|
||||
|
||||
# Simple processor
|
||||
- NAME: CenterCrop
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
PARAS:
|
||||
CAPTION_INTERACTIVE: False
|
||||
HEIGHT_RATIO:
|
||||
VALUE: 1
|
||||
MAX: 20
|
||||
@@ -156,18 +169,309 @@ PROCESSORS:
|
||||
MAX: 20
|
||||
STEP: 1
|
||||
MIN: 1
|
||||
# - NAME: PaddingCrop
|
||||
# TYPE: image
|
||||
# DEVICE: "cpu"
|
||||
# MEMORY: 10
|
||||
# PARAS:
|
||||
# HEIGHT_RATIO:
|
||||
# VALUE: 3
|
||||
# MAX: 25
|
||||
# STEP: 1
|
||||
# MIN: 1
|
||||
# WIDTH_RATIO:
|
||||
# VALUE: 4
|
||||
# MAX: 20
|
||||
# STEP: 1
|
||||
# MIN: 1
|
||||
- NAME: ChangeSample
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
PARAS:
|
||||
CAPTION_INTERACTIVE: False
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
SRC_IMAGE_MASK_INTERACTIVE: True
|
||||
TARGET_IMAGE_INTERACTIVE: True
|
||||
PREVIEW_BTN_VISIBLE: False
|
||||
- NAME: MaskEditSample
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
PARAS:
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
CAPTION_INTERACTIVE: False
|
||||
- NAME: SourceMaskSample
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
PARAS:
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
CAPTION_INTERACTIVE: False
|
||||
- NAME: MaskSwapEditSample
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
PARAS:
|
||||
PREVIEW_BTN_VISIBLE: False
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
CAPTION_INTERACTIVE: False
|
||||
- NAME: SwapMaskSwapEditSample
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
PARAS:
|
||||
PREVIEW_BTN_VISIBLE: False
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
CAPTION_INTERACTIVE: False
|
||||
- NAME: SwapSample
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
PARAS:
|
||||
PREVIEW_BTN_VISIBLE: True
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
TARGET_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
- NAME: DefaultMaskSample
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
PARAS:
|
||||
PREVIEW_BTN_VISIBLE: True
|
||||
SRC_IMAGE_INTERACTIVE: False
|
||||
TARGET_IMAGE_INTERACTIVE: False
|
||||
CAPTION_INTERACTIVE: False
|
||||
# - NAME: PaddingCrop
|
||||
# TYPE: image
|
||||
# DEVICE: "cpu"
|
||||
# MEMORY: 10
|
||||
# PARAS:
|
||||
# HEIGHT_RATIO:
|
||||
# VALUE: 3
|
||||
# MAX: 25
|
||||
# STEP: 1
|
||||
# MIN: 1
|
||||
# WIDTH_RATIO:
|
||||
# VALUE: 4
|
||||
# MAX: 20
|
||||
# STEP: 1
|
||||
# MIN: 1
|
||||
# Annotator processor
|
||||
- NAME: CannyExtractor
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
MODEL:
|
||||
NAME: "CannyAnnotator"
|
||||
LOW_THRESHOLD: 100
|
||||
HIGH_THRESHOLD: 200
|
||||
PARAS:
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
- NAME: ColorExtractor
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
MODEL:
|
||||
NAME: "ColorAnnotator"
|
||||
RATIO: 64
|
||||
PARAS:
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
- NAME: InfoDrawContourExtractor
|
||||
TYPE: image
|
||||
DEVICE: "gpu"
|
||||
MEMORY: 10
|
||||
MODEL:
|
||||
NAME: "InfoDrawContourAnnotator"
|
||||
INPUT_NC: 3
|
||||
OUTPUT_NC: 1
|
||||
N_RESIDUAL_BLOCKS: 3
|
||||
SIGMOID: True
|
||||
PRETRAINED_MODEL: "ms://iic/scepter_annotator@annotator/ckpts/informative_drawing_contour_style.pth"
|
||||
PARAS:
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
- NAME: DegradationExtractor
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
MODEL:
|
||||
NAME: "DegradationAnnotator"
|
||||
RANDOM_DEGRADATION: True
|
||||
PARAMS:
|
||||
gaussian_noise: { }
|
||||
resize: { 'scale': [ 0.4, 0.8 ] }
|
||||
jpeg: { 'jpeg_level': [ 25, 75 ] }
|
||||
gaussian_blur: { 'kernel_size': [ 7, 9, 11, 13, 15 ], 'sigma': [ 0.9, 1.8 ] }
|
||||
PARAS:
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
- NAME: MidasExtractor
|
||||
TYPE: image
|
||||
DEVICE: "gpu"
|
||||
MEMORY: 10
|
||||
MODEL:
|
||||
NAME: "MidasDetector"
|
||||
PRETRAINED_MODEL: "ms://iic/scepter_annotator@annotator/ckpts/dpt_hybrid-midas-501f0c75.pt"
|
||||
PARAS:
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
- NAME: DoodleExtractor
|
||||
TYPE: image
|
||||
DEVICE: "gpu"
|
||||
MEMORY: 10
|
||||
MODEL:
|
||||
NAME: "DoodleAnnotator"
|
||||
PROCESSOR_TYPE: "pidinet_sketch"
|
||||
PROCESSOR_CFG:
|
||||
- NAME: "PiDiAnnotator"
|
||||
PRETRAINED_MODEL: "ms://iic/scepter_annotator@annotator/ckpts/table5_pidinet.pth"
|
||||
- NAME: "SketchAnnotator"
|
||||
PRETRAINED_MODEL: "ms://iic/scepter_annotator@annotator/ckpts/sketch_simplification_gan.pth"
|
||||
PARAS:
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
- NAME: GrayExtractor
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
MODEL:
|
||||
NAME: "GrayAnnotator"
|
||||
PARAS:
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
- NAME: InpaintingExtractor
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
MODEL:
|
||||
NAME: "InpaintingAnnotator"
|
||||
RETURN_MASK: False
|
||||
PARAS:
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
|
||||
- NAME: InpaintingSourceExtractor
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
PARAS:
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
- NAME: OpenposeExtractor
|
||||
TYPE: image
|
||||
DEVICE: "gpu"
|
||||
MEMORY: 10
|
||||
MODEL:
|
||||
NAME: "OpenposeAnnotator"
|
||||
BODY_MODEL_PATH: "ms://iic/scepter_annotator@annotator/ckpts/body_pose_model.pth"
|
||||
HAND_MODEL_PATH: "ms://iic/scepter_annotator@annotator/ckpts/hand_pose_model.pth"
|
||||
PARAS:
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
- NAME: OutpaintingExtractor
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
MODEL:
|
||||
NAME: "OutpaintingAnnotator"
|
||||
RETURN_MASK: False
|
||||
KEEP_PADDING_RATIO: 1
|
||||
RANDOM_CFG:
|
||||
DIRECTION_RANGE: [ 'left', 'right', 'up', 'down' ]
|
||||
RATIO_RANGE: [ 0.1, 0.7 ]
|
||||
PARAS:
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
USE_MASK_VISIBLE: True
|
||||
PREVIEW_BTN_VISIBLE: False
|
||||
- NAME: OutpaintingResize
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
MODEL:
|
||||
NAME: "OutpaintingResize"
|
||||
PARAS:
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
PREVIEW_BTN_VISIBLE: False
|
||||
- NAME: InfoDrawAnimeAnnotator
|
||||
TYPE: image
|
||||
DEVICE: "gpu"
|
||||
MEMORY: 10
|
||||
MODEL:
|
||||
NAME: "InfoDrawAnimeAnnotator"
|
||||
INPUT_NC: 3
|
||||
OUTPUT_NC: 1
|
||||
N_RESIDUAL_BLOCKS: 3
|
||||
SIGMOID: True
|
||||
PRETRAINED_MODEL: "ms://iic/scepter_annotator@annotator/ckpts/informative_drawing_anime_style.pth"
|
||||
PARAS:
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
- NAME: ESAMExtractor
|
||||
TYPE: image
|
||||
DEVICE: "gpu"
|
||||
MEMORY: 10
|
||||
MODEL:
|
||||
NAME: "ESAMAnnotator"
|
||||
PRETRAINED_MODEL: "ms://iic/scepter_annotator@annotator/ckpts/efficient_sam_vits.pt"
|
||||
SAVE_MODE: 'P'
|
||||
GRID_SIZE: 32
|
||||
USE_DOMINANT_COLOR: True
|
||||
RETURN_MASK: False
|
||||
PARAS:
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
- NAME: InvertExtractor
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
MODEL:
|
||||
NAME: "InvertAnnotator"
|
||||
PARAS:
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
|
||||
- NAME: LamaExtractor
|
||||
TYPE: image
|
||||
DEVICE: "cpu"
|
||||
MEMORY: 10
|
||||
MODEL:
|
||||
NAME: "LamaAnnotator"
|
||||
PRETRAINED_MODEL: "ms:///iic/cv_fft_inpainting_lama/"
|
||||
PARAS:
|
||||
SRC_IMAGE_TOOL: sketch
|
||||
SRC_IMAGE_INTERACTIVE: True
|
||||
CAPTION_INTERACTIVE: False
|
||||
|
||||
VIDEO_PROCESSORS:
|
||||
- NAME: CogVLM2Llama3Caption
|
||||
TYPE: caption
|
||||
MODEL_PATH: ms://ZhipuAI/cogvlm2-llama3-caption
|
||||
DEVICE: "gpu"
|
||||
MEMORY: 20000
|
||||
PROMPT: Please describe this video in detail.
|
||||
TEMPERATURE: 0.1
|
||||
MAX_NEW_TOKENS: 2048
|
||||
PAD_TOKEN_ID: 128002
|
||||
TOP_K: 1
|
||||
TOP_P: 0.1
|
||||
|
||||
TRANSLATION_PROCESSORS:
|
||||
- NAME: OpusMtZhEn
|
||||
TYPE: caption
|
||||
MODEL_PATH: ms://cubeai/trans-opus-mt-zh-en
|
||||
DEVICE: "gpu"
|
||||
MEMORY: 5000
|
||||
- NAME: OpusMtEnZh
|
||||
TYPE: caption
|
||||
MODEL_PATH: ms://cubeai/trans-opus-mt-en-zh
|
||||
DEVICE: "gpu"
|
||||
MEMORY: 5000
|
||||
@@ -87,3 +87,7 @@ INTERFACE:
|
||||
NAME_EN: Inference
|
||||
IFID: inference
|
||||
CONFIG: scepter/methods/studio/inference/inference.yaml
|
||||
- NAME: 对话式编辑
|
||||
NAME_EN: ChatBot
|
||||
IFID: chatbot
|
||||
CONFIG: scepter/methods/studio/chatbot/chatbot.yaml
|
||||
|
||||
@@ -0,0 +1,315 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 42
|
||||
TENSOR_PARALLEL_SIZE: 1
|
||||
PIPELINE_PARALLEL_SIZE: 1
|
||||
SYS_ENVS:
|
||||
TORCH_CUDNN_V8_API_ENABLED: '1'
|
||||
TOKENIZERS_PARALLELISM: 'false'
|
||||
TF_CPP_MIN_LOG_LEVEL: '3'
|
||||
PYTORCH_CUDA_ALLOC_CONF: 'expandable_segments:True'
|
||||
META:
|
||||
VERSION: 'COGVIDEOX_2B'
|
||||
DESCRIPTION: "cogvideox 2b"
|
||||
IS_DEFAULT: False
|
||||
IS_SHARE: True
|
||||
INFERENCE_PARAS:
|
||||
INFERENCE_BATCH_SIZE: 1
|
||||
INFERENCE_PREFIX: ""
|
||||
DEFAULT_SAMPLER: "ddim"
|
||||
DEFAULT_SAMPLE_STEPS: 50
|
||||
INFERENCE_N_PROMPT: ""
|
||||
RESOLUTION: [ 480, 720 ]
|
||||
PARAS:
|
||||
- TRAIN_BATCH_SIZE: 1
|
||||
TRAIN_PREFIX: ""
|
||||
TRAIN_N_PROMPT: ""
|
||||
RESOLUTION: [ 480, 720 ]
|
||||
MEMORY: 89000
|
||||
EPOCHS: 50
|
||||
SAVE_INTERVAL: 25
|
||||
EPSEC: 0.818
|
||||
LEARNING_RATE: 4e-4
|
||||
IS_DEFAULT: False
|
||||
TUNER: FULL
|
||||
- TRAIN_BATCH_SIZE: 1
|
||||
TRAIN_PREFIX: ""
|
||||
TRAIN_N_PROMPT: ""
|
||||
RESOLUTION: [ 480, 720 ]
|
||||
MEMORY: 89000
|
||||
EPOCHS: 50
|
||||
SAVE_INTERVAL: 25
|
||||
EPSEC: 0.818
|
||||
LEARNING_RATE: 4e-4
|
||||
IS_DEFAULT: True
|
||||
TUNER: LORA
|
||||
#
|
||||
TUNERS:
|
||||
LORA:
|
||||
- NAME: SwiftLoRA
|
||||
R: 64
|
||||
LORA_ALPHA: 64
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "model.*(.to_k|.to_q|.to_v|.to_out.0)$"
|
||||
#
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionVideoSolver
|
||||
MAX_STEPS: 2000
|
||||
USE_AMP: True
|
||||
DTYPE: bfloat16
|
||||
USE_FAIRSCALE: False
|
||||
USE_FSDP: True
|
||||
LOAD_MODEL_ONLY: False
|
||||
ENABLE_GRADSCALER: False
|
||||
USE_SCALER: False
|
||||
RESUME_FROM:
|
||||
WORK_DIR: ./cache/save_data/dit_cogvideox_2b_lora
|
||||
LOG_FILE: std_log.txt
|
||||
EVAL_INTERVAL: 100
|
||||
LOG_TRAIN_NUM: 4
|
||||
FPS: 8
|
||||
SHARDING_STRATEGY: full_shard
|
||||
FSDP_REDUCE_DTYPE: float32
|
||||
FSDP_BUFFER_DTYPE: float32
|
||||
FSDP_SHARD_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
SAVE_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
TRAIN_MODULES: ['model']
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionCogVideoX
|
||||
PRETRAINED_MODEL:
|
||||
PARAMETERIZATION: v
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA: 3.0
|
||||
ZERO_TERMINAL_SNR: True
|
||||
SCALE_FACTOR_SPATIAL: 8
|
||||
SCALE_FACTOR_TEMPORAL: 4
|
||||
SCALING_FACTOR_IMAGE: 1.15258426
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: v
|
||||
NOISE_SCHEDULER:
|
||||
NAME: ScaledLinearScheduler
|
||||
BETA_MIN: 0.00085
|
||||
BETA_MAX: 0.012
|
||||
SNR_SHIFT_SCALE: 3.0
|
||||
RESCALE_BETAS_ZERO_SNR: True
|
||||
DIFFUSION_SAMPLERS:
|
||||
NAME: DDIMSampler
|
||||
DISCRETIZATION_TYPE: trailing
|
||||
ETA: 0.0
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: CogVideoXTransformer3DModel
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-2b@transformer/diffusion_pytorch_model.safetensors
|
||||
NUM_ATTENTION_HEADS: 30
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 16
|
||||
FLIP_SIN_TO_COS: True
|
||||
FREQ_SHIFT: 0
|
||||
TIME_EMBED_DIM: 512
|
||||
TEXT_EMBED_DIM: 4096
|
||||
NUM_LAYERS: 30
|
||||
DROPOUT: 0.0
|
||||
ATTENTION_BIAS: True
|
||||
SAMPLE_WIDTH: 90
|
||||
SAMPLE_HEIGHT: 60
|
||||
SAMPLE_FRAMES: 49
|
||||
PATCH_SIZE: 2
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
MAX_TEXT_SEQ_LENGTH: 226
|
||||
ACTIVATION_FN: "gelu-approximate"
|
||||
TIMESTEP_ACTIVATION_FN: "silu"
|
||||
NORM_ELEMENTWISE_AFFINE: True
|
||||
NORM_EPS: 1e-5
|
||||
SPATIAL_INTERPOLATION_SCALE: 1.875
|
||||
TEMPORAL_INTERPOLATION_SCALE: 1.0
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: False
|
||||
USE_LEARNED_POSITIONAL_EMBEDDINGS: False
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-2b@vae/diffusion_pytorch_model.safetensors
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: False
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
LENGTH: 226
|
||||
CLEAN:
|
||||
USE_GRAD: False
|
||||
#
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
SEED: 42
|
||||
GUIDE_SCALE: 6.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
NUM_FRAMES: 49
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: Adam
|
||||
LEARNING_RATE: 1e-3
|
||||
BETAS: [ 0.9, 0.95 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 0.0
|
||||
AMSGRAD: False
|
||||
#
|
||||
# LR_SCHEDULER:
|
||||
# NAME: StepAnnealingLR
|
||||
# WARMUP_STEPS: 200
|
||||
# TOTAL_STEPS: 2000
|
||||
# DECAY_MODE: 'cosine'
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: VideoGenDatasetOTF
|
||||
MODE: train
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
PROMPT_PREFIX: ''
|
||||
DELIMITER: '#;#'
|
||||
FIELDS: [ 'video_path', 'width', 'height', 'prompt' ]
|
||||
PATH_PREFIX:
|
||||
DATA_FILE:
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'video', 'video_latent', "prompt" ]
|
||||
META_KEYS: [ ]
|
||||
MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-2b@vae/diffusion_pytorch_model.safetensors
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "A girl riding a bike.", "A panda, dressed in a small, red jacket and a tiny hat, sits on a wooden stool in a serene bamboo forest. The panda's fluffy paws strum a miniature acoustic guitar, producing soft, melodic tunes. Nearby, a few other pandas gather, watching curiously and some clapping in rhythm. Sunlight filters through the tall bamboo, casting a gentle glow on the scene. The panda's face is expressive, showing concentration and joy as it plays. The background includes a small, flowing stream and vibrant green foliage, enhancing the peaceful and magical atmosphere of this unique musical performance." ]
|
||||
IMAGE_SIZE: [ 480, 720 ]
|
||||
FIELDS: [ "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: ''
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
# USE_NUM: 8
|
||||
NUM_WORKERS: 4
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'index', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
- NAME: BackwardHook
|
||||
PRIORITY: 10
|
||||
- NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
PRIORITY: 20
|
||||
- NAME: CheckpointHook
|
||||
INTERVAL: 1000
|
||||
PRIORITY: 40
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
DISABLE_SNAPSHOT: True
|
||||
#
|
||||
EVAL_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
SAVE_PROBE_PREFIX: 'image'
|
||||
@@ -0,0 +1,317 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
SEED: 42
|
||||
TENSOR_PARALLEL_SIZE: 1
|
||||
PIPELINE_PARALLEL_SIZE: 1
|
||||
SYS_ENVS:
|
||||
TORCH_CUDNN_V8_API_ENABLED: '1'
|
||||
TOKENIZERS_PARALLELISM: 'false'
|
||||
TF_CPP_MIN_LOG_LEVEL: '3'
|
||||
PYTORCH_CUDA_ALLOC_CONF: 'expandable_segments:True'
|
||||
META:
|
||||
VERSION: 'COGVIDEOX_5B'
|
||||
DESCRIPTION: "cogvideox 5b"
|
||||
IS_DEFAULT: False
|
||||
IS_SHARE: True
|
||||
INFERENCE_PARAS:
|
||||
INFERENCE_BATCH_SIZE: 1
|
||||
INFERENCE_PREFIX: ""
|
||||
DEFAULT_SAMPLER: "ddim"
|
||||
DEFAULT_SAMPLE_STEPS: 50
|
||||
INFERENCE_N_PROMPT: ""
|
||||
RESOLUTION: [ 480, 720 ]
|
||||
PARAS:
|
||||
- TRAIN_BATCH_SIZE: 1
|
||||
TRAIN_PREFIX: ""
|
||||
TRAIN_N_PROMPT: ""
|
||||
RESOLUTION: [ 480, 720 ]
|
||||
MEMORY: 89000
|
||||
EPOCHS: 50
|
||||
SAVE_INTERVAL: 25
|
||||
EPSEC: 0.818
|
||||
LEARNING_RATE: 4e-4
|
||||
IS_DEFAULT: False
|
||||
TUNER: FULL
|
||||
- TRAIN_BATCH_SIZE: 1
|
||||
TRAIN_PREFIX: ""
|
||||
TRAIN_N_PROMPT: ""
|
||||
RESOLUTION: [ 480, 720 ]
|
||||
MEMORY: 89000
|
||||
EPOCHS: 50
|
||||
SAVE_INTERVAL: 25
|
||||
EPSEC: 0.818
|
||||
LEARNING_RATE: 4e-4
|
||||
IS_DEFAULT: True
|
||||
TUNER: LORA
|
||||
#
|
||||
TUNERS:
|
||||
LORA:
|
||||
- NAME: SwiftLoRA
|
||||
R: 64
|
||||
LORA_ALPHA: 64
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "model.*(.to_k|.to_q|.to_v|.to_out.0)$"
|
||||
#
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionVideoSolver
|
||||
MAX_STEPS: 2000
|
||||
USE_AMP: True
|
||||
DTYPE: bfloat16
|
||||
USE_FAIRSCALE: False
|
||||
USE_FSDP: True
|
||||
LOAD_MODEL_ONLY: False
|
||||
ENABLE_GRADSCALER: False
|
||||
USE_SCALER: False
|
||||
RESUME_FROM:
|
||||
WORK_DIR: ./cache/save_data/dit_cogvideox_5b_lora
|
||||
LOG_FILE: std_log.txt
|
||||
EVAL_INTERVAL: 100
|
||||
LOG_TRAIN_NUM: 4
|
||||
FPS: 8
|
||||
SHARDING_STRATEGY: full_shard
|
||||
FSDP_REDUCE_DTYPE: float32
|
||||
FSDP_BUFFER_DTYPE: float32
|
||||
FSDP_SHARD_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
SAVE_MODULES: [ 'model', 'cond_stage_model.model']
|
||||
TRAIN_MODULES: ['model']
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
#
|
||||
TUNER:
|
||||
#
|
||||
MODEL:
|
||||
NAME: LatentDiffusionCogVideoX
|
||||
PRETRAINED_MODEL:
|
||||
PARAMETERIZATION: v
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA: 3.0
|
||||
ZERO_TERMINAL_SNR: True
|
||||
SCALE_FACTOR_SPATIAL: 8
|
||||
SCALE_FACTOR_TEMPORAL: 4
|
||||
SCALING_FACTOR_IMAGE: 0.7 # 5b diff
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
NAME: BaseDiffusion
|
||||
PREDICTION_TYPE: v
|
||||
NOISE_SCHEDULER:
|
||||
NAME: ScaledLinearScheduler
|
||||
BETA_MIN: 0.00085
|
||||
BETA_MAX: 0.012
|
||||
SNR_SHIFT_SCALE: 1.0 # 5b diff
|
||||
RESCALE_BETAS_ZERO_SNR: True
|
||||
DIFFUSION_SAMPLERS:
|
||||
NAME: DDIMSampler
|
||||
DISCRETIZATION_TYPE: trailing
|
||||
ETA: 0.0
|
||||
#
|
||||
DIFFUSION_MODEL:
|
||||
NAME: CogVideoXTransformer3DModel
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: # 5b diff
|
||||
- ms://AI-ModelScope/CogVideoX-5b@transformer/diffusion_pytorch_model-00001-of-00002.safetensors
|
||||
- ms://AI-ModelScope/CogVideoX-5b@transformer/diffusion_pytorch_model-00002-of-00002.safetensors
|
||||
NUM_ATTENTION_HEADS: 48 # 5b diff
|
||||
ATTENTION_HEAD_DIM: 64
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 16
|
||||
FLIP_SIN_TO_COS: True
|
||||
FREQ_SHIFT: 0
|
||||
TIME_EMBED_DIM: 512
|
||||
TEXT_EMBED_DIM: 4096
|
||||
NUM_LAYERS: 42 # 5b diff
|
||||
DROPOUT: 0.0
|
||||
ATTENTION_BIAS: True
|
||||
SAMPLE_WIDTH: 90
|
||||
SAMPLE_HEIGHT: 60
|
||||
SAMPLE_FRAMES: 49
|
||||
PATCH_SIZE: 2
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
MAX_TEXT_SEQ_LENGTH: 226
|
||||
ACTIVATION_FN: "gelu-approximate"
|
||||
TIMESTEP_ACTIVATION_FN: "silu"
|
||||
NORM_ELEMENTWISE_AFFINE: True
|
||||
NORM_EPS: 1e-5
|
||||
SPATIAL_INTERPOLATION_SCALE: 1.875
|
||||
TEMPORAL_INTERPOLATION_SCALE: 1.0
|
||||
USE_ROTARY_POSITIONAL_EMBEDDINGS: True # 5b diff
|
||||
USE_LEARNED_POSITIONAL_EMBEDDINGS: False
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-5b@vae/diffusion_pytorch_model.safetensors # 5b diff
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5EmbedderHF
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/t5-v1_1-xxl
|
||||
LENGTH: 226
|
||||
CLEAN:
|
||||
USE_GRAD: False
|
||||
#
|
||||
LOSS:
|
||||
NAME: ReconstructLoss
|
||||
LOSS_TYPE: l2
|
||||
#
|
||||
SAMPLE_ARGS:
|
||||
SAMPLER: ddim
|
||||
SAMPLE_STEPS: 50
|
||||
SEED: 42
|
||||
GUIDE_SCALE: 6.0
|
||||
GUIDE_RESCALE: 0.0
|
||||
NUM_FRAMES: 49
|
||||
#
|
||||
OPTIMIZER:
|
||||
NAME: Adam
|
||||
LEARNING_RATE: 1e-3
|
||||
BETAS: [ 0.9, 0.95 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 0.0
|
||||
AMSGRAD: False
|
||||
#
|
||||
# LR_SCHEDULER:
|
||||
# NAME: StepAnnealingLR
|
||||
# WARMUP_STEPS: 200
|
||||
# TOTAL_STEPS: 2000
|
||||
# DECAY_MODE: 'cosine'
|
||||
#
|
||||
TRAIN_DATA:
|
||||
NAME: VideoGenDatasetOTF
|
||||
MODE: train
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
PROMPT_PREFIX: ''
|
||||
DELIMITER: '#;#'
|
||||
FIELDS: [ 'video_path', 'width', 'height', 'prompt' ]
|
||||
PATH_PREFIX:
|
||||
DATA_FILE:
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'video', 'video_latent', "prompt" ]
|
||||
META_KEYS: [ ]
|
||||
MODEL:
|
||||
NAME: AutoencoderKLCogVideoX
|
||||
DTYPE: bfloat16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/CogVideoX-5b@vae/diffusion_pytorch_model.safetensors
|
||||
SAMPLE_HEIGHT: 480
|
||||
SAMPLE_WIDTH: 720
|
||||
USE_QUANT_CONV: False
|
||||
USE_POST_QUANT_CONV: False
|
||||
USE_SLICING: True
|
||||
USE_TILING: True
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
ENCODER:
|
||||
NAME: CogVideoXEncoder3D
|
||||
IN_CHANNELS: 3
|
||||
OUT_CHANNELS: 16
|
||||
UP_BLOCK_TYPES: [ "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D", "CogVideoXDownBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
DECODER:
|
||||
NAME: CogVideoXDecoder3D
|
||||
IN_CHANNELS: 16
|
||||
OUT_CHANNELS: 3
|
||||
UP_BLOCK_TYPES: [ "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D", "CogVideoXUpBlock3D" ]
|
||||
BLOCK_OUT_CHANNELS: [ 128, 256, 256, 512 ]
|
||||
LAYERS_PER_BLOCK: 3
|
||||
ACT_FN: "silu"
|
||||
NORM_EPS: 1e-6
|
||||
NORM_NUM_GROUPS: 32
|
||||
DROPOUT: 0.0
|
||||
PAD_MODE: "first"
|
||||
TEMPORAL_COMPRESSION_RATIO: 4
|
||||
GRADIENT_CHECKPOINTING: True
|
||||
#
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "A girl riding a bike.", "A panda, dressed in a small, red jacket and a tiny hat, sits on a wooden stool in a serene bamboo forest. The panda's fluffy paws strum a miniature acoustic guitar, producing soft, melodic tunes. Nearby, a few other pandas gather, watching curiously and some clapping in rhythm. Sunlight filters through the tall bamboo, casting a gentle glow on the scene. The panda's face is expressive, showing concentration and joy as it plays. The background includes a small, flowing stream and vibrant green foliage, enhancing the peaceful and magical atmosphere of this unique musical performance." ]
|
||||
IMAGE_SIZE: [ 480, 720 ]
|
||||
FIELDS: [ "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: ''
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
# USE_NUM: 8
|
||||
NUM_WORKERS: 4
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'index', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
#
|
||||
TRAIN_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
- NAME: BackwardHook
|
||||
PRIORITY: 10
|
||||
- NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
PRIORITY: 20
|
||||
- NAME: CheckpointHook
|
||||
INTERVAL: 1000
|
||||
PRIORITY: 40
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
DISABLE_SNAPSHOT: True
|
||||
#
|
||||
EVAL_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
SAVE_PROBE_PREFIX: 'image'
|
||||
@@ -0,0 +1,285 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
META:
|
||||
VERSION: 'FLUX1.0_DEV'
|
||||
DESCRIPTION: "flux 1.0 dev"
|
||||
IS_DEFAULT: True
|
||||
IS_SHARE: True
|
||||
INFERENCE_PARAS:
|
||||
INFERENCE_BATCH_SIZE: 1
|
||||
INFERENCE_PREFIX: ""
|
||||
DEFAULT_SAMPLER: "flow_euler"
|
||||
DEFAULT_SAMPLE_STEPS: 50
|
||||
INFERENCE_N_PROMPT: ""
|
||||
RESOLUTION: [1024, 1024]
|
||||
PARAS:
|
||||
-
|
||||
TRAIN_BATCH_SIZE: 1
|
||||
TRAIN_PREFIX: ""
|
||||
TRAIN_N_PROMPT: ""
|
||||
RESOLUTION: [1024, 1024]
|
||||
MEMORY: 89000
|
||||
EPOCHS: 50
|
||||
SAVE_INTERVAL: 25
|
||||
EPSEC: 0.818
|
||||
LEARNING_RATE: 4e-4
|
||||
IS_DEFAULT: False
|
||||
TUNER: FULL
|
||||
-
|
||||
TRAIN_BATCH_SIZE: 1
|
||||
TRAIN_PREFIX: ""
|
||||
TRAIN_N_PROMPT: ""
|
||||
RESOLUTION: [1024, 1024]
|
||||
MEMORY: 89000
|
||||
EPOCHS: 50
|
||||
SAVE_INTERVAL: 25
|
||||
EPSEC: 0.818
|
||||
LEARNING_RATE: 4e-4
|
||||
IS_DEFAULT: True
|
||||
TUNER: LORA
|
||||
#
|
||||
TUNERS:
|
||||
LORA:
|
||||
-
|
||||
NAME: SwiftLoRA
|
||||
R: 4
|
||||
LORA_ALPHA: 4
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "(model.double_blocks.*(.qkv|.proj|.img_mod.lin|.txt_mod.lin))|(model.single_blocks.*(.linear1|.linear2|.modulation.lin))$"
|
||||
#
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionSolver
|
||||
MAX_STEPS: 100000
|
||||
USE_AMP: True
|
||||
DTYPE: bfloat16
|
||||
USE_FAIRSCALE: False
|
||||
USE_FSDP: True
|
||||
LOAD_MODEL_ONLY: False
|
||||
RESUME_FROM:
|
||||
WORK_DIR: ./cache/save_data/dit_flux_dev_1024_lora
|
||||
LOG_FILE: std_log.txt
|
||||
EVAL_INTERVAL: 100
|
||||
LOG_TRAIN_NUM: 16
|
||||
ENABLE_GRADSCALER: False
|
||||
USE_SCALER: False
|
||||
FSDP_REDUCE_DTYPE: float32
|
||||
FSDP_BUFFER_DTYPE: float32
|
||||
FSDP_SHARD_MODULES: [ 'model', 'cond_stage_model.t5_model' ] #
|
||||
SAVE_MODULES: [ 'model']
|
||||
TRAIN_MODULES: ['model']
|
||||
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
|
||||
FREEZE:
|
||||
|
||||
TUNER:
|
||||
|
||||
MODEL:
|
||||
NAME: LatentDiffusionFlux
|
||||
PARAMETERIZATION: rf
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA:
|
||||
ZERO_TERMINAL_SNR: False
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
NAME: DiffusionFluxRF
|
||||
PREDICTION_TYPE: raw
|
||||
NOISE_SCHEDULER:
|
||||
NAME: FlowMatchSigmaScheduler
|
||||
WEIGHTING_SCHEME: logit_normal
|
||||
SHIFT: 3.0
|
||||
LOGIT_MEAN: 0.0
|
||||
LOGIT_STD: 1.0
|
||||
MODE_SCALE: 1.29
|
||||
SAMPLER_SCHEDULER:
|
||||
NAME: FlowMatchFluxShiftScheduler
|
||||
SHIFT: False
|
||||
SIGMOID_SCALE: 1
|
||||
BASE_SHIFT: 0.5
|
||||
MAX_SHIFT: 1.15
|
||||
|
||||
DIFFUSION_MODEL:
|
||||
NAME: Flux
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-dev@flux1-dev.safetensors
|
||||
IN_CHANNELS: 64
|
||||
HIDDEN_SIZE: 3072
|
||||
NUM_HEADS: 24
|
||||
AXES_DIM: [ 16, 56, 56 ]
|
||||
THETA: 10000
|
||||
VEC_IN_DIM: 768
|
||||
GUIDANCE_EMBED: False
|
||||
CONTEXT_IN_DIM: 4096
|
||||
MLP_RATIO: 4.0
|
||||
QKV_BIAS: True
|
||||
DEPTH: 19
|
||||
DEPTH_SINGLE_BLOCKS: 38
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLFlux
|
||||
EMBED_DIM: 16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-dev@ae.safetensors
|
||||
IGNORE_KEYS: [ ]
|
||||
BATCH_SIZE: 8
|
||||
USE_CONV: False
|
||||
SCALE_FACTOR: 0.3611
|
||||
SHIFT_FACTOR: 0.1159
|
||||
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5PlusClipFluxEmbedder
|
||||
T5_MODEL:
|
||||
NAME: HFEmbedder
|
||||
HF_MODEL_CLS: T5EncoderModel
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-dev@text_encoder_2/
|
||||
HF_TOKENIZER_CLS: T5Tokenizer
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-dev@tokenizer_2/
|
||||
MAX_LENGTH: 512
|
||||
OUTPUT_KEY: last_hidden_state
|
||||
D_TYPE: bfloat16
|
||||
BATCH_INFER: False
|
||||
CLEAN: whitespace
|
||||
CLIP_MODEL:
|
||||
NAME: HFEmbedder
|
||||
HF_MODEL_CLS: CLIPTextModel
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-dev@text_encoder/
|
||||
HF_TOKENIZER_CLS: CLIPTokenizer
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-dev@tokenizer/
|
||||
MAX_LENGTH: 77
|
||||
OUTPUT_KEY: pooler_output
|
||||
D_TYPE: bfloat16
|
||||
BATCH_INFER: True
|
||||
CLEAN: whitespace
|
||||
|
||||
SAMPLE_ARGS:
|
||||
SAMPLE_STEPS: 50
|
||||
SAMPLER: flow_euler
|
||||
SEED: 2024
|
||||
IMAGE_SIZE: [ 1024, 1024 ]
|
||||
SHIFT: True
|
||||
GUIDE_SCALE: 3.5
|
||||
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 4e-4
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
AMSGRAD: False
|
||||
|
||||
TRAIN_DATA:
|
||||
NAME: ImageTextPairMSDataset
|
||||
MODE: train
|
||||
MS_DATASET_NAME: style_custom_dataset
|
||||
MS_DATASET_NAMESPACE: damo
|
||||
MS_DATASET_SUBNAME: 3D
|
||||
PROMPT_PREFIX: ""
|
||||
MS_DATASET_SPLIT: train
|
||||
MS_REMAP_KEYS: { 'Image:FILE': 'Target:FILE' }
|
||||
REPLACE_STYLE: False
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
TRANSFORMS:
|
||||
- NAME: LoadImageFromFile
|
||||
RGB_ORDER: RGB
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleResize
|
||||
INTERPOLATION: bilinear
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleCenterCrop
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: ImageToTensor
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: Normalize
|
||||
MEAN: [ 0.5, 0.5, 0.5 ]
|
||||
STD: [ 0.5, 0.5, 0.5 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'image' ]
|
||||
BACKEND: torchvision
|
||||
- NAME: Select
|
||||
KEYS: [ 'image', 'prompt' ]
|
||||
META_KEYS: [ 'data_key' ]
|
||||
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "a cat holds a blackboard that writes \"hello world\"", "a dog running on the lawn" ]
|
||||
IMAGE_SIZE: [ 1024, 1024 ]
|
||||
FIELDS: [ "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: ''
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 2
|
||||
NUM_WORKERS: 4
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'index', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
|
||||
TRAIN_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
- NAME: BackwardHook
|
||||
PRIORITY: 10
|
||||
- NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
- NAME: CheckpointHook
|
||||
INTERVAL: 10000
|
||||
PRIORITY: 200
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
DISABLE_SNAPSHOT: True
|
||||
EVAL_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
SAVE_PROBE_PREFIX: 'image'
|
||||
@@ -0,0 +1,284 @@
|
||||
ENV:
|
||||
BACKEND: nccl
|
||||
META:
|
||||
VERSION: 'FLUX1.0_SCHNELL'
|
||||
DESCRIPTION: "flux 1.0 schnell"
|
||||
IS_DEFAULT: False
|
||||
IS_SHARE: True
|
||||
INFERENCE_PARAS:
|
||||
INFERENCE_BATCH_SIZE: 1
|
||||
INFERENCE_PREFIX: ""
|
||||
DEFAULT_SAMPLER: "flow_euler"
|
||||
DEFAULT_SAMPLE_STEPS: 4
|
||||
INFERENCE_N_PROMPT: ""
|
||||
RESOLUTION: [1024, 1024]
|
||||
PARAS:
|
||||
-
|
||||
TRAIN_BATCH_SIZE: 1
|
||||
TRAIN_PREFIX: ""
|
||||
TRAIN_N_PROMPT: ""
|
||||
RESOLUTION: [1024, 1024]
|
||||
MEMORY: 89000
|
||||
EPOCHS: 50
|
||||
SAVE_INTERVAL: 25
|
||||
EPSEC: 0.818
|
||||
LEARNING_RATE: 4e-4
|
||||
IS_DEFAULT: False
|
||||
TUNER: FULL
|
||||
-
|
||||
TRAIN_BATCH_SIZE: 1
|
||||
TRAIN_PREFIX: ""
|
||||
TRAIN_N_PROMPT: ""
|
||||
RESOLUTION: [1024, 1024]
|
||||
MEMORY: 89000
|
||||
EPOCHS: 50
|
||||
SAVE_INTERVAL: 25
|
||||
EPSEC: 0.818
|
||||
LEARNING_RATE: 4e-4
|
||||
IS_DEFAULT: True
|
||||
TUNER: LORA
|
||||
#
|
||||
TUNERS:
|
||||
LORA:
|
||||
-
|
||||
NAME: SwiftLoRA
|
||||
R: 4
|
||||
LORA_ALPHA: 4
|
||||
LORA_DROPOUT: 0.0
|
||||
BIAS: "none"
|
||||
TARGET_MODULES: "(model.double_blocks.*(.qkv|.proj|.img_mod.lin|.txt_mod.lin))|(model.single_blocks.*(.linear1|.linear2|.modulation.lin))$"
|
||||
#
|
||||
SOLVER:
|
||||
NAME: LatentDiffusionSolver
|
||||
MAX_STEPS: 100000
|
||||
USE_AMP: True
|
||||
DTYPE: bfloat16
|
||||
USE_FAIRSCALE: False
|
||||
USE_FSDP: True
|
||||
LOAD_MODEL_ONLY: False
|
||||
RESUME_FROM:
|
||||
WORK_DIR: ./cache/save_data/dit_flux_schnell_1024_lora
|
||||
LOG_FILE: std_log.txt
|
||||
EVAL_INTERVAL: 100
|
||||
LOG_TRAIN_NUM: 16
|
||||
ENABLE_GRADSCALER: False
|
||||
USE_SCALER: False
|
||||
FSDP_REDUCE_DTYPE: float32
|
||||
FSDP_BUFFER_DTYPE: float32
|
||||
FSDP_SHARD_MODULES: [ 'model', 'cond_stage_model.t5_model' ]
|
||||
SAVE_MODULES: [ 'model']
|
||||
TRAIN_MODULES: ['model']
|
||||
#
|
||||
FILE_SYSTEM:
|
||||
NAME: "ModelscopeFs"
|
||||
TEMP_DIR: "./cache/cache_data"
|
||||
|
||||
FREEZE:
|
||||
|
||||
TUNER:
|
||||
|
||||
MODEL:
|
||||
NAME: LatentDiffusionFlux
|
||||
PARAMETERIZATION: rf
|
||||
TIMESTEPS: 1000
|
||||
MIN_SNR_GAMMA:
|
||||
ZERO_TERMINAL_SNR: False
|
||||
PRETRAINED_MODEL:
|
||||
IGNORE_KEYS: [ ]
|
||||
DEFAULT_N_PROMPT:
|
||||
USE_EMA: False
|
||||
EVAL_EMA: False
|
||||
DIFFUSION:
|
||||
NAME: DiffusionFluxRF
|
||||
PREDICTION_TYPE: raw
|
||||
NOISE_SCHEDULER:
|
||||
NAME: FlowMatchSigmaScheduler
|
||||
WEIGHTING_SCHEME: logit_normal
|
||||
SHIFT: 3.0
|
||||
LOGIT_MEAN: 0.0
|
||||
LOGIT_STD: 1.0
|
||||
MODE_SCALE: 1.29
|
||||
SAMPLER_SCHEDULER:
|
||||
NAME: FlowMatchFluxShiftScheduler
|
||||
SHIFT: False
|
||||
SIGMOID_SCALE: 1
|
||||
BASE_SHIFT: 0.5
|
||||
MAX_SHIFT: 1.15
|
||||
|
||||
DIFFUSION_MODEL:
|
||||
NAME: Flux
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-schnell@flux1-schnell.safetensors
|
||||
IN_CHANNELS: 64
|
||||
HIDDEN_SIZE: 3072
|
||||
NUM_HEADS: 24
|
||||
AXES_DIM: [ 16, 56, 56 ]
|
||||
THETA: 10000
|
||||
VEC_IN_DIM: 768
|
||||
GUIDANCE_EMBED: False
|
||||
CONTEXT_IN_DIM: 4096
|
||||
MLP_RATIO: 4.0
|
||||
QKV_BIAS: True
|
||||
DEPTH: 19
|
||||
DEPTH_SINGLE_BLOCKS: 38
|
||||
USE_GRAD_CHECKPOINT: True
|
||||
|
||||
FIRST_STAGE_MODEL:
|
||||
NAME: AutoencoderKLFlux
|
||||
EMBED_DIM: 16
|
||||
PRETRAINED_MODEL: ms://AI-ModelScope/FLUX.1-schnell@ae.safetensors
|
||||
IGNORE_KEYS: [ ]
|
||||
BATCH_SIZE: 8
|
||||
USE_CONV: False
|
||||
SCALE_FACTOR: 0.3611
|
||||
SHIFT_FACTOR: 0.1159
|
||||
|
||||
ENCODER:
|
||||
NAME: Encoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DOUBLE_Z: True
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
|
||||
DECODER:
|
||||
NAME: Decoder
|
||||
USE_CHECKPOINT: True
|
||||
CH: 128
|
||||
OUT_CH: 3
|
||||
NUM_RES_BLOCKS: 2
|
||||
IN_CHANNELS: 3
|
||||
ATTN_RESOLUTIONS: [ ]
|
||||
CH_MULT: [ 1, 2, 4, 4 ]
|
||||
Z_CHANNELS: 16
|
||||
DROPOUT: 0.0
|
||||
RESAMP_WITH_CONV: True
|
||||
GIVE_PRE_END: False
|
||||
TANH_OUT: False
|
||||
|
||||
COND_STAGE_MODEL:
|
||||
NAME: T5PlusClipFluxEmbedder
|
||||
T5_MODEL:
|
||||
NAME: HFEmbedder
|
||||
HF_MODEL_CLS: T5EncoderModel
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-schnell@text_encoder_2/
|
||||
HF_TOKENIZER_CLS: T5Tokenizer
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-schnell@tokenizer_2/
|
||||
MAX_LENGTH: 256
|
||||
OUTPUT_KEY: last_hidden_state
|
||||
D_TYPE: bfloat16
|
||||
BATCH_INFER: False
|
||||
CLEAN: whitespace
|
||||
CLIP_MODEL:
|
||||
NAME: HFEmbedder
|
||||
HF_MODEL_CLS: CLIPTextModel
|
||||
MODEL_PATH: ms://AI-ModelScope/FLUX.1-schnell@text_encoder/
|
||||
HF_TOKENIZER_CLS: CLIPTokenizer
|
||||
TOKENIZER_PATH: ms://AI-ModelScope/FLUX.1-schnell@tokenizer/
|
||||
MAX_LENGTH: 77
|
||||
OUTPUT_KEY: pooler_output
|
||||
D_TYPE: bfloat16
|
||||
BATCH_INFER: True
|
||||
CLEAN: whitespace
|
||||
|
||||
SAMPLE_ARGS:
|
||||
SAMPLE_STEPS: 4
|
||||
SAMPLER: flow_euler
|
||||
SEED: 2024
|
||||
IMAGE_SIZE: [ 1024, 1024 ]
|
||||
GUIDE_SCALE: 3.5
|
||||
|
||||
OPTIMIZER:
|
||||
NAME: AdamW
|
||||
LEARNING_RATE: 4e-4
|
||||
BETAS: [ 0.9, 0.999 ]
|
||||
EPS: 1e-8
|
||||
WEIGHT_DECAY: 1e-2
|
||||
AMSGRAD: False
|
||||
|
||||
TRAIN_DATA:
|
||||
NAME: ImageTextPairMSDataset
|
||||
MODE: train
|
||||
MS_DATASET_NAME: style_custom_dataset
|
||||
MS_DATASET_NAMESPACE: damo
|
||||
MS_DATASET_SUBNAME: 3D
|
||||
PROMPT_PREFIX: ""
|
||||
MS_DATASET_SPLIT: train
|
||||
MS_REMAP_KEYS: { 'Image:FILE': 'Target:FILE' }
|
||||
REPLACE_STYLE: False
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 1
|
||||
NUM_WORKERS: 4
|
||||
SAMPLER:
|
||||
NAME: LoopSampler
|
||||
TRANSFORMS:
|
||||
- NAME: LoadImageFromFile
|
||||
RGB_ORDER: RGB
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleResize
|
||||
INTERPOLATION: bilinear
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: FlexibleCenterCrop
|
||||
SIZE: [ 1024, 1024 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: ImageToTensor
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'img' ]
|
||||
BACKEND: pillow
|
||||
- NAME: Normalize
|
||||
MEAN: [ 0.5, 0.5, 0.5 ]
|
||||
STD: [ 0.5, 0.5, 0.5 ]
|
||||
INPUT_KEY: [ 'img' ]
|
||||
OUTPUT_KEY: [ 'image' ]
|
||||
BACKEND: torchvision
|
||||
- NAME: Select
|
||||
KEYS: [ 'image', 'prompt' ]
|
||||
META_KEYS: [ 'data_key' ]
|
||||
|
||||
EVAL_DATA:
|
||||
NAME: Text2ImageDataset
|
||||
MODE: eval
|
||||
PROMPT_FILE:
|
||||
PROMPT_DATA: [ "a cat holds a blackboard that writes \"hello world\"", "a dog running on the lawn" ]
|
||||
IMAGE_SIZE: [ 1024, 1024 ]
|
||||
FIELDS: [ "prompt" ]
|
||||
DELIMITER: '#;#'
|
||||
PROMPT_PREFIX: ''
|
||||
PIN_MEMORY: True
|
||||
BATCH_SIZE: 2
|
||||
NUM_WORKERS: 4
|
||||
TRANSFORMS:
|
||||
- NAME: Select
|
||||
KEYS: [ 'index', 'prompt' ]
|
||||
META_KEYS: [ 'image_size' ]
|
||||
|
||||
TRAIN_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
PRIORITY: 0
|
||||
- NAME: BackwardHook
|
||||
PRIORITY: 10
|
||||
- NAME: LogHook
|
||||
LOG_INTERVAL: 10
|
||||
- NAME: CheckpointHook
|
||||
INTERVAL: 10000
|
||||
PRIORITY: 200
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
DISABLE_SNAPSHOT: True
|
||||
EVAL_HOOKS:
|
||||
- NAME: ProbeDataHook
|
||||
PROB_INTERVAL: 100
|
||||
SAVE_LAST: True
|
||||
SAVE_NAME_PREFIX: 'step'
|
||||
SAVE_PROBE_PREFIX: 'image'
|
||||
@@ -35,7 +35,7 @@ META:
|
||||
SAVE_INTERVAL: 25
|
||||
EPSEC: 0.818
|
||||
LEARNING_RATE: 0.0001
|
||||
IS_DEFAULT: False
|
||||
IS_DEFAULT: True
|
||||
TUNER: LORA
|
||||
#
|
||||
TUNERS:
|
||||
|
||||
@@ -13,8 +13,10 @@ TRAIN_PARAS:
|
||||
VALUES: [[256, 256], [320, 180], [180, 320],
|
||||
[512, 512], [640, 360], [360, 640],
|
||||
[768, 768], [960, 540], [540, 960],
|
||||
[1024, 1024], [1280, 720], [720, 1280]]
|
||||
[1024, 1024], [1280, 720], [720, 1280],
|
||||
[720, 480], [480, 720]]
|
||||
DEFAULT: [1024, 1024]
|
||||
EVAL_PROMPTS:
|
||||
- a boy wearing a jacket
|
||||
- a dog running on the lawn
|
||||
SAVE_FILE_LOCAL_PATH: "cache/scepter_ui/datasets/train_data_from_list"
|
||||
|
||||
@@ -13,3 +13,5 @@ BASE_MODEL_VERSION:
|
||||
TUNER_TYPE: [ 'LORA', 'SCE', 'FULL' ]
|
||||
- BASE_MODEL: 'EDIT'
|
||||
TUNER_TYPE: [ 'LORA', 'SCE', 'FULL' ]
|
||||
- BASE_MODEL: 'FLUX1.0_DEV'
|
||||
TUNER_TYPE: [ 'LORA' ]
|
||||
@@ -1,4 +1,23 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
from scepter.modules import (data, inference, model, opt, solver, transform,
|
||||
utils)
|
||||
from typing import TYPE_CHECKING
|
||||
from scepter.modules.utils.import_utils import LazyImportModule
|
||||
|
||||
|
||||
if TYPE_CHECKING:
|
||||
from scepter.modules import (data, inference, model, opt, solver, transform,
|
||||
utils)
|
||||
else:
|
||||
_import_structure = {
|
||||
'modules': ['data', 'inference', 'model', 'opt', 'solver',
|
||||
'transform', 'utils']
|
||||
}
|
||||
|
||||
import sys
|
||||
sys.modules[__name__] = LazyImportModule(
|
||||
__name__,
|
||||
globals()['__file__'],
|
||||
_import_structure,
|
||||
module_spec=__spec__,
|
||||
extra_objects={},
|
||||
)
|
||||
|
||||
@@ -1,11 +1,60 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
from scepter.modules.annotator.base_annotator import GeneralAnnotator
|
||||
from scepter.modules.annotator.canny import CannyAnnotator
|
||||
from scepter.modules.annotator.color import ColorAnnotator
|
||||
from scepter.modules.annotator.hed import HedAnnotator
|
||||
from scepter.modules.annotator.identity import IdentityAnnotator
|
||||
from scepter.modules.annotator.invert import InvertAnnotator
|
||||
from scepter.modules.annotator.midas_op import MidasDetector
|
||||
from scepter.modules.annotator.mlsd_op import MLSDdetector
|
||||
from scepter.modules.annotator.openpose import OpenposeAnnotator
|
||||
from typing import TYPE_CHECKING
|
||||
from scepter.modules.utils.import_utils import LazyImportModule
|
||||
|
||||
if TYPE_CHECKING:
|
||||
from scepter.modules.annotator.base_annotator import GeneralAnnotator
|
||||
from scepter.modules.annotator.canny import CannyAnnotator
|
||||
from scepter.modules.annotator.color import ColorAnnotator
|
||||
from scepter.modules.annotator.degradation import DegradationAnnotator
|
||||
from scepter.modules.annotator.doodle import DoodleAnnotator
|
||||
from scepter.modules.annotator.gray import GrayAnnotator
|
||||
from scepter.modules.annotator.hed import HedAnnotator
|
||||
from scepter.modules.annotator.identity import IdentityAnnotator
|
||||
from scepter.modules.annotator.informative_drawing import (
|
||||
InfoDrawAnimeAnnotator, InfoDrawContourAnnotator,
|
||||
InfoDrawOpenSketchAnnotator)
|
||||
from scepter.modules.annotator.inpainting import InpaintingAnnotator
|
||||
from scepter.modules.annotator.invert import InvertAnnotator
|
||||
from scepter.modules.annotator.midas_op import MidasDetector
|
||||
from scepter.modules.annotator.mlsd_op import MLSDdetector
|
||||
from scepter.modules.annotator.openpose import OpenposeAnnotator
|
||||
from scepter.modules.annotator.outpainting import OutpaintingAnnotator, OutpaintingResize
|
||||
from scepter.modules.annotator.pidinet import PiDiAnnotator
|
||||
from scepter.modules.annotator.segmentation import ESAMAnnotator
|
||||
from scepter.modules.annotator.sketch import SketchAnnotator
|
||||
from scepter.modules.annotator.lama import LamaAnnotator
|
||||
else:
|
||||
_import_structure = {
|
||||
'base_annotator': ['GeneralAnnotator'],
|
||||
'canny': ['CannyAnnotator'],
|
||||
'color': ['ColorAnnotator'],
|
||||
'degradation': ['DegradationAnnotator'],
|
||||
'doodle': ['DoodleAnnotator'],
|
||||
'gray': ['GrayAnnotator'],
|
||||
'hed': ['HedAnnotator'],
|
||||
'identity': ['IdentityAnnotator'],
|
||||
'informative_drawing': ['InfoDrawAnimeAnnotator',
|
||||
'InfoDrawContourAnnotator',
|
||||
'InfoDrawOpenSketchAnnotator'],
|
||||
'inpainting': ['InpaintingAnnotator'],
|
||||
'invert': ['InvertAnnotator'],
|
||||
'midas_op': ['MidasDetector'],
|
||||
'mlsd_op': ['MLSDdetector'],
|
||||
'openpose': ['OpenposeAnnotator'],
|
||||
'outpainting': ['OutpaintingAnnotator', 'OutpaintingResize'],
|
||||
'pidinet': ['PiDiAnnotator'],
|
||||
'segmentation': ['ESAMAnnotator'],
|
||||
'sketch': ['SketchAnnotator'],
|
||||
'lama': ['LamaAnnotator'],
|
||||
}
|
||||
|
||||
import sys
|
||||
sys.modules[__name__] = LazyImportModule(
|
||||
__name__,
|
||||
globals()['__file__'],
|
||||
_import_structure,
|
||||
module_spec=__spec__,
|
||||
extra_objects={},
|
||||
)
|
||||
|
||||
@@ -0,0 +1,135 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
import math
|
||||
import random
|
||||
from abc import ABCMeta
|
||||
|
||||
import cv2
|
||||
import numpy as np
|
||||
import torch
|
||||
|
||||
from PIL import Image
|
||||
from scepter.modules.annotator.base_annotator import BaseAnnotator
|
||||
from scepter.modules.annotator.registry import ANNOTATORS
|
||||
from scepter.modules.utils.config import Config, dict_to_yaml
|
||||
|
||||
|
||||
def gaussian_noise_op(im, v):
|
||||
from basicsr.data.degradations import random_add_gaussian_noise
|
||||
noise_level = v.get('noise_level', [10, 20])
|
||||
out = random_add_gaussian_noise(
|
||||
im,
|
||||
sigma_range=noise_level,
|
||||
clip=True,
|
||||
rounds=False,
|
||||
gray_prob=0.4,
|
||||
)
|
||||
out = np.clip(out, 0.0, 1.0)
|
||||
return out
|
||||
|
||||
|
||||
def resize_op(im, v):
|
||||
scale = v.get('scale', [0.5, 0.8])
|
||||
h, w = im.shape[:2]
|
||||
scale = random.uniform(scale[0], scale[1])
|
||||
h_, w_ = int(h * scale), int(w * scale)
|
||||
mode = v.get('mode', 'nearest')
|
||||
if mode == 'nearest':
|
||||
interpolation = cv2.INTER_NEAREST
|
||||
elif mode == 'bilinear':
|
||||
interpolation = cv2.INTER_LINEAR
|
||||
elif mode == 'bicubic':
|
||||
interpolation = cv2.INTER_CUBIC
|
||||
else:
|
||||
interpolation = cv2.INTER_NEAREST
|
||||
im = cv2.resize(im, (w_, h_), interpolation=interpolation)
|
||||
out = cv2.resize(im, (w, h), interpolation=interpolation)
|
||||
out = np.clip(out, 0.0, 1.0)
|
||||
return out
|
||||
|
||||
|
||||
def jpeg_op(im, v):
|
||||
from basicsr.data.degradations import add_jpg_compression
|
||||
jpeg_level = v.get('jpeg_level', [50, 75])
|
||||
v = int(random.uniform(jpeg_level[0], jpeg_level[1]))
|
||||
out = add_jpg_compression(im, v)
|
||||
out = np.clip(out, 0.0, 1.0)
|
||||
return out
|
||||
|
||||
|
||||
def gaussian_blur_op(im, v):
|
||||
from basicsr.data.degradations import random_mixed_kernels
|
||||
kernel_range = v.get('kernel_size', [7, 9])
|
||||
kernel_size = random.choice(kernel_range)
|
||||
kernel_size = min(int(kernel_size) // 2 * 2 + 1, 21)
|
||||
blur_sigma = v.get('sigma', [0.9, 1.0])
|
||||
kernel = random_mixed_kernels(
|
||||
('iso', 'aniso', 'generalized_iso', 'generalized_aniso', 'plateau_iso',
|
||||
'plateau_aniso'), (0.45, 0.25, 0.12, 0.03, 0.12, 0.03),
|
||||
kernel_size,
|
||||
blur_sigma,
|
||||
blur_sigma, [-math.pi, math.pi], [0.5, 2.0], [1, 1.5],
|
||||
noise_range=None)
|
||||
|
||||
pad_size = (21 - kernel_size) // 2
|
||||
kernel = np.pad(kernel, ((pad_size, pad_size), (pad_size, pad_size)))
|
||||
out = cv2.filter2D(im, -1, kernel)
|
||||
out = np.clip(out, 0.0, 1.0)
|
||||
return out
|
||||
|
||||
|
||||
@ANNOTATORS.register_class()
|
||||
class DegradationAnnotator(BaseAnnotator, metaclass=ABCMeta):
|
||||
para_dict = {}
|
||||
|
||||
def __init__(self, cfg, logger=None):
|
||||
super().__init__(cfg, logger=logger)
|
||||
self.params = cfg.get('PARAMS', {
|
||||
'gaussian_noise': {},
|
||||
'resize': {},
|
||||
'jpeg': {},
|
||||
'gaussian_blur': {},
|
||||
})
|
||||
if not isinstance(self.params, dict):
|
||||
self.params = Config.get_dict(self.params)
|
||||
self.random_degradation = cfg.get('RANDOM_DEGRADATION', False)
|
||||
|
||||
def forward(self, image):
|
||||
if isinstance(image, Image.Image):
|
||||
image = np.array(image)
|
||||
elif isinstance(image, torch.Tensor):
|
||||
image = image.detach().cpu().numpy()
|
||||
elif isinstance(image, np.ndarray):
|
||||
image = image.copy()
|
||||
else:
|
||||
raise f'Unsurpport datatype{type(image)}, only surpport np.ndarray, torch.Tensor, Pillow Image.'
|
||||
if np.max(image) > 1.0:
|
||||
image = (image / 255.).astype(np.float32)
|
||||
|
||||
degradation_list = list(self.params.keys())
|
||||
if self.random_degradation:
|
||||
random.shuffle(degradation_list)
|
||||
|
||||
for degradation_type in degradation_list:
|
||||
if degradation_type == 'gaussian_noise':
|
||||
image = gaussian_noise_op(image, self.params[degradation_type])
|
||||
elif degradation_type == 'resize':
|
||||
image = resize_op(image, self.params[degradation_type])
|
||||
elif degradation_type == 'jpeg':
|
||||
image = jpeg_op(image, self.params[degradation_type])
|
||||
elif degradation_type == 'gaussian_blur':
|
||||
image = gaussian_blur_op(image, self.params[degradation_type])
|
||||
else:
|
||||
raise NotImplementedError(
|
||||
f'ERROR: degradation_type: {degradation_type} is invalid.')
|
||||
image = (image * 255.0).astype(np.uint8)
|
||||
|
||||
assert len(image.shape) < 4
|
||||
return image
|
||||
|
||||
@staticmethod
|
||||
def get_config_template():
|
||||
return dict_to_yaml('ANNOTATORS',
|
||||
__class__.__name__,
|
||||
DegradationAnnotator.para_dict,
|
||||
set_name=True)
|
||||
@@ -0,0 +1,42 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
from abc import ABCMeta
|
||||
|
||||
import torch
|
||||
from scepter.modules.annotator.base_annotator import BaseAnnotator
|
||||
from scepter.modules.annotator.registry import ANNOTATORS
|
||||
from scepter.modules.utils.config import dict_to_yaml
|
||||
|
||||
|
||||
@ANNOTATORS.register_class()
|
||||
class DoodleAnnotator(BaseAnnotator, metaclass=ABCMeta):
|
||||
para_dict = {}
|
||||
|
||||
def __init__(self, cfg, logger=None):
|
||||
super().__init__(cfg, logger=logger)
|
||||
self.processor_type = cfg.get('PROCESSOR_TYPE', 'pidinet_sketch')
|
||||
processor_cfg = cfg.get('PROCESSOR_CFG', None)
|
||||
if self.processor_type == 'pidinet_sketch':
|
||||
self.pidinet_ins = ANNOTATORS.build(processor_cfg[0])
|
||||
self.sketch_ins = ANNOTATORS.build(processor_cfg[1])
|
||||
else:
|
||||
raise 'Unsurpport PROCESSOR for DoodleAnnotator'
|
||||
|
||||
@torch.no_grad()
|
||||
@torch.inference_mode()
|
||||
@torch.autocast('cuda', enabled=False)
|
||||
def forward(self, image):
|
||||
if self.processor_type == 'pidinet_sketch':
|
||||
pidinet_res = self.pidinet_ins(image)
|
||||
sketch_res = self.sketch_ins(pidinet_res)
|
||||
doodle_res = sketch_res
|
||||
else:
|
||||
raise 'Unsurpport PROCESSOR for DoodleAnnotator'
|
||||
return doodle_res
|
||||
|
||||
@staticmethod
|
||||
def get_config_template():
|
||||
return dict_to_yaml('ANNOTATORS',
|
||||
__class__.__name__,
|
||||
DoodleAnnotator.para_dict,
|
||||
set_name=True)
|
||||
@@ -0,0 +1,38 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
from abc import ABCMeta
|
||||
|
||||
import cv2
|
||||
import numpy as np
|
||||
import torch
|
||||
from PIL import Image
|
||||
from scepter.modules.annotator.base_annotator import BaseAnnotator
|
||||
from scepter.modules.annotator.registry import ANNOTATORS
|
||||
from scepter.modules.utils.config import dict_to_yaml
|
||||
|
||||
|
||||
@ANNOTATORS.register_class()
|
||||
class GrayAnnotator(BaseAnnotator, metaclass=ABCMeta):
|
||||
para_dict = {}
|
||||
|
||||
def __init__(self, cfg, logger=None):
|
||||
super().__init__(cfg, logger=logger)
|
||||
|
||||
def forward(self, image):
|
||||
if isinstance(image, Image.Image):
|
||||
image = np.array(image)
|
||||
elif isinstance(image, torch.Tensor):
|
||||
image = image.detach().cpu().numpy()
|
||||
elif isinstance(image, np.ndarray):
|
||||
image = image.copy()
|
||||
else:
|
||||
raise f'Unsurpport datatype{type(image)}, only surpport np.ndarray, torch.Tensor, Pillow Image.'
|
||||
gray_map = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
|
||||
return gray_map[..., None].repeat(3, axis=2)
|
||||
|
||||
@staticmethod
|
||||
def get_config_template():
|
||||
return dict_to_yaml('ANNOTATORS',
|
||||
__class__.__name__,
|
||||
GrayAnnotator.para_dict,
|
||||
set_name=True)
|
||||
@@ -114,7 +114,7 @@ class HedAnnotator(BaseAnnotator, metaclass=ABCMeta):
|
||||
pretrained_model = cfg.get('PRETRAINED_MODEL', None)
|
||||
if pretrained_model:
|
||||
with FS.get_from(pretrained_model, wait_finish=True) as local_path:
|
||||
self.netNetwork.load_state_dict(torch.load(local_path))
|
||||
self.netNetwork.load_state_dict(torch.load(local_path, weights_only=True))
|
||||
|
||||
@torch.no_grad()
|
||||
@torch.inference_mode()
|
||||
|
||||
@@ -0,0 +1,175 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
from abc import ABCMeta
|
||||
|
||||
import numpy as np
|
||||
import torch
|
||||
import torch.nn as nn
|
||||
from einops import rearrange
|
||||
from torchvision.transforms import InterpolationMode
|
||||
|
||||
from scepter.modules.annotator.base_annotator import BaseAnnotator
|
||||
from scepter.modules.annotator.registry import ANNOTATORS
|
||||
from scepter.modules.utils.config import dict_to_yaml
|
||||
from scepter.modules.utils.distribute import we
|
||||
from scepter.modules.utils.file_system import FS
|
||||
|
||||
norm_layer = nn.InstanceNorm2d
|
||||
|
||||
|
||||
class ResidualBlock(nn.Module):
|
||||
def __init__(self, in_features):
|
||||
super(ResidualBlock, self).__init__()
|
||||
|
||||
conv_block = [
|
||||
nn.ReflectionPad2d(1),
|
||||
nn.Conv2d(in_features, in_features, 3),
|
||||
norm_layer(in_features),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.ReflectionPad2d(1),
|
||||
nn.Conv2d(in_features, in_features, 3),
|
||||
norm_layer(in_features)
|
||||
]
|
||||
|
||||
self.conv_block = nn.Sequential(*conv_block)
|
||||
|
||||
def forward(self, x):
|
||||
return x + self.conv_block(x)
|
||||
|
||||
|
||||
class ContourInference(nn.Module):
|
||||
def __init__(self, input_nc, output_nc, n_residual_blocks=9, sigmoid=True):
|
||||
super(ContourInference, self).__init__()
|
||||
|
||||
# Initial convolution block
|
||||
model0 = [
|
||||
nn.ReflectionPad2d(3),
|
||||
nn.Conv2d(input_nc, 64, 7),
|
||||
norm_layer(64),
|
||||
nn.ReLU(inplace=True)
|
||||
]
|
||||
self.model0 = nn.Sequential(*model0)
|
||||
|
||||
# Downsampling
|
||||
model1 = []
|
||||
in_features = 64
|
||||
out_features = in_features * 2
|
||||
for _ in range(2):
|
||||
model1 += [
|
||||
nn.Conv2d(in_features, out_features, 3, stride=2, padding=1),
|
||||
norm_layer(out_features),
|
||||
nn.ReLU(inplace=True)
|
||||
]
|
||||
in_features = out_features
|
||||
out_features = in_features * 2
|
||||
self.model1 = nn.Sequential(*model1)
|
||||
|
||||
model2 = []
|
||||
# Residual blocks
|
||||
for _ in range(n_residual_blocks):
|
||||
model2 += [ResidualBlock(in_features)]
|
||||
self.model2 = nn.Sequential(*model2)
|
||||
|
||||
# Upsampling
|
||||
model3 = []
|
||||
out_features = in_features // 2
|
||||
for _ in range(2):
|
||||
model3 += [
|
||||
nn.ConvTranspose2d(in_features,
|
||||
out_features,
|
||||
3,
|
||||
stride=2,
|
||||
padding=1,
|
||||
output_padding=1),
|
||||
norm_layer(out_features),
|
||||
nn.ReLU(inplace=True)
|
||||
]
|
||||
in_features = out_features
|
||||
out_features = in_features // 2
|
||||
self.model3 = nn.Sequential(*model3)
|
||||
|
||||
# Output layer
|
||||
model4 = [nn.ReflectionPad2d(3), nn.Conv2d(64, output_nc, 7)]
|
||||
if sigmoid:
|
||||
model4 += [nn.Sigmoid()]
|
||||
|
||||
self.model4 = nn.Sequential(*model4)
|
||||
|
||||
def forward(self, x, cond=None):
|
||||
out = self.model0(x)
|
||||
out = self.model1(out)
|
||||
out = self.model2(out)
|
||||
out = self.model3(out)
|
||||
out = self.model4(out)
|
||||
|
||||
return out
|
||||
|
||||
|
||||
@ANNOTATORS.register_class()
|
||||
class InfoDrawContourAnnotator(BaseAnnotator, metaclass=ABCMeta):
|
||||
para_dict = {}
|
||||
|
||||
def __init__(self, cfg, logger=None):
|
||||
super().__init__(cfg, logger=logger)
|
||||
input_nc = cfg.get('INPUT_NC', 3)
|
||||
output_nc = cfg.get('OUTPUT_NC', 1)
|
||||
n_residual_blocks = cfg.get('N_RESIDUAL_BLOCKS', 3)
|
||||
sigmoid = cfg.get('SIGMOID', True)
|
||||
pretrained_model = cfg.get('PRETRAINED_MODEL', None)
|
||||
|
||||
self.model = ContourInference(input_nc, output_nc, n_residual_blocks,
|
||||
sigmoid)
|
||||
with FS.get_from(pretrained_model, wait_finish=True) as local_path:
|
||||
self.model.load_state_dict(torch.load(local_path, weights_only=True))
|
||||
self.model = self.model.eval().requires_grad_(False).to(we.device_id)
|
||||
|
||||
@torch.no_grad()
|
||||
@torch.inference_mode()
|
||||
@torch.autocast('cuda', enabled=False)
|
||||
def forward(self, image):
|
||||
is_batch = False if len(image.shape) == 3 else True
|
||||
if isinstance(image, torch.Tensor):
|
||||
if len(image.shape) == 3:
|
||||
image = rearrange(image, 'h w c -> 1 c h w')
|
||||
B, C, H, W = image.shape
|
||||
elif len(image.shape) == 4:
|
||||
B, C, H, W = image.shape
|
||||
else:
|
||||
raise "Unsurpport input image's shape"
|
||||
elif isinstance(image, np.ndarray):
|
||||
image = torch.from_numpy(image.copy()).float()
|
||||
if len(image.shape) == 3:
|
||||
image = rearrange(image, 'h w c -> 1 c h w')
|
||||
B, C, H, W = image.shape
|
||||
elif len(image.shape) == 4:
|
||||
B, C, H, W = image.shape
|
||||
else:
|
||||
raise "Unsurpport input image's shape"
|
||||
else:
|
||||
raise "Unsurpport input image's type"
|
||||
|
||||
image = image.float().div(255).to(we.device_id)
|
||||
contour_map = self.model(image)
|
||||
contour_map = (contour_map.squeeze(dim=1) * 255.0).clip(
|
||||
0, 255).cpu().numpy().astype(np.uint8)
|
||||
contour_map = contour_map[..., None].repeat(3, -1)
|
||||
if not is_batch:
|
||||
contour_map = contour_map.squeeze()
|
||||
return contour_map
|
||||
|
||||
@staticmethod
|
||||
def get_config_template():
|
||||
return dict_to_yaml('ANNOTATORS',
|
||||
__class__.__name__,
|
||||
InfoDrawContourAnnotator.para_dict,
|
||||
set_name=True)
|
||||
|
||||
|
||||
@ANNOTATORS.register_class()
|
||||
class InfoDrawAnimeAnnotator(InfoDrawContourAnnotator):
|
||||
pass
|
||||
|
||||
|
||||
@ANNOTATORS.register_class()
|
||||
class InfoDrawOpenSketchAnnotator(InfoDrawContourAnnotator):
|
||||
pass
|
||||
@@ -0,0 +1,275 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
import random
|
||||
from abc import ABCMeta
|
||||
from enum import Enum
|
||||
|
||||
import cv2
|
||||
import numpy as np
|
||||
import torch
|
||||
from PIL import Image
|
||||
|
||||
from scepter.modules.annotator.base_annotator import BaseAnnotator
|
||||
from scepter.modules.annotator.registry import ANNOTATORS
|
||||
from scepter.modules.utils.config import Config, dict_to_yaml
|
||||
|
||||
|
||||
def invert_image(im):
|
||||
im_arr = np.array(im)
|
||||
mask_1 = im_arr == 0
|
||||
mask_2 = im_arr == 255
|
||||
im_arr[mask_1] = 255
|
||||
im_arr[mask_2] = 0
|
||||
new_im = im_arr
|
||||
return new_im
|
||||
|
||||
|
||||
class DrawMethod(Enum):
|
||||
LINE = 'line'
|
||||
CIRCLE = 'circle'
|
||||
SQUARE = 'square'
|
||||
|
||||
|
||||
def make_random_irregular_mask(shape,
|
||||
max_angle=4,
|
||||
max_len=60,
|
||||
max_width=20,
|
||||
min_times=0,
|
||||
max_times=10,
|
||||
draw_method=DrawMethod.LINE):
|
||||
draw_method = DrawMethod(draw_method)
|
||||
|
||||
height, width = shape
|
||||
mask = np.zeros((height, width), np.float32)
|
||||
times = np.random.randint(min_times, max_times + 1)
|
||||
for i in range(times):
|
||||
start_x = np.random.randint(width)
|
||||
start_y = np.random.randint(height)
|
||||
for j in range(1 + np.random.randint(5)):
|
||||
angle = 0.01 + np.random.randint(max_angle)
|
||||
if i % 2 == 0:
|
||||
angle = 2 * 3.1415926 - angle
|
||||
length = 10 + np.random.randint(max_len)
|
||||
brush_w = 5 + np.random.randint(max_width)
|
||||
end_x = np.clip(
|
||||
(start_x + length * np.sin(angle)).astype(np.int32), 0, width)
|
||||
end_y = np.clip(
|
||||
(start_y + length * np.cos(angle)).astype(np.int32), 0, height)
|
||||
if draw_method == DrawMethod.LINE:
|
||||
cv2.line(mask, (start_x, start_y), (end_x, end_y), 1.0,
|
||||
brush_w)
|
||||
elif draw_method == DrawMethod.CIRCLE:
|
||||
cv2.circle(mask, (start_x, start_y),
|
||||
radius=brush_w,
|
||||
color=1.,
|
||||
thickness=-1)
|
||||
elif draw_method == DrawMethod.SQUARE:
|
||||
radius = brush_w // 2
|
||||
mask[start_y - radius:start_y + radius,
|
||||
start_x - radius:start_x + radius] = 1
|
||||
start_x, start_y = end_x, end_y
|
||||
return mask[None, ...]
|
||||
|
||||
|
||||
class RandomIrregularMaskGenerator:
|
||||
def __init__(self,
|
||||
max_angle=4,
|
||||
max_len=60,
|
||||
max_width=20,
|
||||
min_times=0,
|
||||
max_times=10,
|
||||
ramp_kwargs=None,
|
||||
draw_method=DrawMethod.LINE):
|
||||
self.max_angle = max_angle
|
||||
self.max_len = max_len
|
||||
self.max_width = max_width
|
||||
self.min_times = min_times
|
||||
self.max_times = max_times
|
||||
self.draw_method = draw_method
|
||||
self.ramp = None
|
||||
# self.ramp = LinearRamp(**ramp_kwargs) if ramp_kwargs is not None else None
|
||||
|
||||
def __call__(self, img, iter_i=None, raw_image=None):
|
||||
coef = self.ramp(iter_i) if (self.ramp is not None) and (
|
||||
iter_i is not None) else 1
|
||||
cur_max_len = int(max(1, self.max_len * coef))
|
||||
cur_max_width = int(max(1, self.max_width * coef))
|
||||
cur_max_times = int(self.min_times + 1 +
|
||||
(self.max_times - self.min_times) * coef)
|
||||
return make_random_irregular_mask(img.shape[1:],
|
||||
max_angle=self.max_angle,
|
||||
max_len=cur_max_len,
|
||||
max_width=cur_max_width,
|
||||
min_times=self.min_times,
|
||||
max_times=cur_max_times,
|
||||
draw_method=self.draw_method)
|
||||
|
||||
|
||||
def make_random_rectangle_mask(shape,
|
||||
margin=10,
|
||||
bbox_min_size=30,
|
||||
bbox_max_size=100,
|
||||
min_times=0,
|
||||
max_times=3):
|
||||
height, width = shape
|
||||
mask = np.zeros((height, width), np.float32)
|
||||
bbox_max_size = min(bbox_max_size, height - margin * 2, width - margin * 2)
|
||||
times = np.random.randint(min_times, max_times + 1)
|
||||
for i in range(times):
|
||||
box_width = np.random.randint(bbox_min_size, bbox_max_size)
|
||||
box_height = np.random.randint(bbox_min_size, bbox_max_size)
|
||||
start_x = np.random.randint(margin, width - margin - box_width + 1)
|
||||
start_y = np.random.randint(margin, height - margin - box_height + 1)
|
||||
mask[start_y:start_y + box_height, start_x:start_x + box_width] = 1
|
||||
return mask[None, ...]
|
||||
|
||||
|
||||
class RandomRectangleMaskGenerator:
|
||||
def __init__(self,
|
||||
margin=10,
|
||||
bbox_min_size=30,
|
||||
bbox_max_size=100,
|
||||
min_times=0,
|
||||
max_times=3,
|
||||
ramp_kwargs=None):
|
||||
self.margin = margin
|
||||
self.bbox_min_size = bbox_min_size
|
||||
self.bbox_max_size = bbox_max_size
|
||||
self.min_times = min_times
|
||||
self.max_times = max_times
|
||||
self.ramp = None
|
||||
# self.ramp = LinearRamp(**ramp_kwargs) if ramp_kwargs is not None else None
|
||||
|
||||
def __call__(self, img, iter_i=None, raw_image=None):
|
||||
coef = self.ramp(iter_i) if (self.ramp is not None) and (
|
||||
iter_i is not None) else 1
|
||||
cur_bbox_max_size = int(self.bbox_min_size + 1 +
|
||||
(self.bbox_max_size - self.bbox_min_size) *
|
||||
coef)
|
||||
cur_max_times = int(self.min_times +
|
||||
(self.max_times - self.min_times) * coef)
|
||||
return make_random_rectangle_mask(img.shape[1:],
|
||||
margin=self.margin,
|
||||
bbox_min_size=self.bbox_min_size,
|
||||
bbox_max_size=cur_bbox_max_size,
|
||||
min_times=self.min_times,
|
||||
max_times=cur_max_times)
|
||||
|
||||
|
||||
class MixedMaskGenerator:
|
||||
def __init__(self,
|
||||
irregular_proba=1 / 3,
|
||||
irregular_kwargs=None,
|
||||
box_proba=1 / 3,
|
||||
box_kwargs=None,
|
||||
invert_proba=0):
|
||||
self.probas = []
|
||||
self.gens = []
|
||||
|
||||
if irregular_proba > 0:
|
||||
self.probas.append(irregular_proba)
|
||||
if irregular_kwargs is None:
|
||||
irregular_kwargs = {}
|
||||
else:
|
||||
irregular_kwargs = dict(irregular_kwargs)
|
||||
irregular_kwargs['draw_method'] = DrawMethod.LINE
|
||||
self.gens.append(RandomIrregularMaskGenerator(**irregular_kwargs))
|
||||
|
||||
if box_proba > 0:
|
||||
self.probas.append(box_proba)
|
||||
if box_kwargs is None:
|
||||
box_kwargs = {}
|
||||
self.gens.append(RandomRectangleMaskGenerator(**box_kwargs))
|
||||
|
||||
self.probas = np.array(self.probas, dtype='float32')
|
||||
self.probas /= self.probas.sum()
|
||||
self.invert_proba = invert_proba
|
||||
|
||||
def __call__(self, img, iter_i=None, raw_image=None):
|
||||
kind = np.random.choice(len(self.probas), p=self.probas)
|
||||
gen = self.gens[kind]
|
||||
result = gen(img, iter_i=iter_i, raw_image=raw_image)
|
||||
if self.invert_proba > 0 and random.random() < self.invert_proba:
|
||||
result = 1 - result
|
||||
return result
|
||||
|
||||
|
||||
@ANNOTATORS.register_class()
|
||||
class InpaintingAnnotator(BaseAnnotator, metaclass=ABCMeta):
|
||||
para_dict = {}
|
||||
|
||||
def __init__(self, cfg, logger=None):
|
||||
super().__init__(cfg, logger=logger)
|
||||
self.mask_cfg = cfg.get(
|
||||
'MASK_CFG', {
|
||||
'irregular_proba': 0.5,
|
||||
'irregular_kwargs': {
|
||||
'min_times': 4,
|
||||
'max_times': 10,
|
||||
'max_width': 100,
|
||||
'max_angle': 4,
|
||||
'max_len': 200
|
||||
},
|
||||
'box_proba': 0.5,
|
||||
'box_kwargs': {
|
||||
'margin': 0,
|
||||
'bbox_min_size': 30,
|
||||
'bbox_max_size': 150,
|
||||
'max_times': 5,
|
||||
'min_times': 1
|
||||
}
|
||||
})
|
||||
self.mask_cfg = Config.get_dict(self.mask_cfg) if not isinstance(
|
||||
self.mask_cfg, dict) else self.mask_cfg
|
||||
self.mask_generator = MixedMaskGenerator(**self.mask_cfg)
|
||||
self.return_mask = cfg.get('RETURN_MASK', False)
|
||||
self.return_invert = cfg.get('RETURN_INVERT', True)
|
||||
self.mask_color = cfg.get('MASK_COLOR', 0)
|
||||
|
||||
def forward(self,
|
||||
image,
|
||||
mask=None,
|
||||
return_mask=None,
|
||||
return_invert=None,
|
||||
mask_color=None):
|
||||
return_mask = return_mask if return_mask is not None else self.return_mask
|
||||
return_invert = return_invert if return_invert is not None else self.return_invert
|
||||
mask_color = mask_color if mask_color is not None else self.mask_color
|
||||
if isinstance(image, Image.Image):
|
||||
image = np.array(image)
|
||||
elif isinstance(image, torch.Tensor):
|
||||
image = image.detach().cpu().numpy()
|
||||
elif isinstance(image, np.ndarray):
|
||||
image = image.copy()
|
||||
else:
|
||||
raise f'Unsurpport datatype{type(image)}, only surpport np.ndarray, torch.Tensor, Pillow Image.'
|
||||
|
||||
if mask is not None:
|
||||
if mask_color:
|
||||
image[np.array(mask) == 255] = mask_color
|
||||
else:
|
||||
image[np.array(mask) == 255] = 0
|
||||
else:
|
||||
img = np.transpose(image, (2, 0, 1))
|
||||
mask = self.mask_generator(img)
|
||||
mask = (np.transpose(mask,
|
||||
(1, 2, 0)).squeeze(-1) * 255).astype(np.uint8)
|
||||
if return_invert:
|
||||
mask = invert_image(mask)
|
||||
colored_mask = np.zeros_like(image)
|
||||
if mask_color: colored_mask[:] = mask_color
|
||||
image = np.where(mask[:, :, np.newaxis] == 255, colored_mask,
|
||||
image)
|
||||
|
||||
if return_mask:
|
||||
ret_data = {'image': np.array(image), 'mask': np.array(mask)}
|
||||
else:
|
||||
ret_data = np.array(image)
|
||||
return ret_data
|
||||
|
||||
@staticmethod
|
||||
def get_config_template():
|
||||
return dict_to_yaml('ANNOTATORS',
|
||||
__class__.__name__,
|
||||
InpaintingAnnotator.para_dict,
|
||||
set_name=True)
|
||||
@@ -0,0 +1,106 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
from abc import ABCMeta
|
||||
|
||||
import numpy as np
|
||||
|
||||
import cv2
|
||||
import torch
|
||||
from PIL import Image
|
||||
from scepter.modules.annotator.base_annotator import BaseAnnotator
|
||||
from scepter.modules.annotator.registry import ANNOTATORS
|
||||
from scepter.modules.utils.config import dict_to_yaml
|
||||
from scepter.modules.utils.distribute import we
|
||||
from scepter.modules.utils.file_system import FS
|
||||
|
||||
|
||||
def dilate_mask(mask, dilate_factor=15):
|
||||
mask = mask.astype(np.uint8)
|
||||
mask = cv2.dilate(mask,
|
||||
np.ones((dilate_factor, dilate_factor), np.uint8),
|
||||
iterations=1)
|
||||
return mask
|
||||
|
||||
|
||||
@ANNOTATORS.register_class()
|
||||
class LamaAnnotator(BaseAnnotator, metaclass=ABCMeta):
|
||||
para_dict = {}
|
||||
|
||||
def __init__(self, cfg, logger=None):
|
||||
super().__init__(cfg, logger=logger)
|
||||
from modelscope.pipelines.builder import PIPELINES
|
||||
from modelscope.pipelines.cv import ImageInpaintingPipeline
|
||||
from modelscope.pipelines import pipeline
|
||||
from modelscope.utils.constant import Tasks
|
||||
from modelscope.metainfo import Pipelines
|
||||
from modelscope.models.cv.image_inpainting.refinement import refine_predict
|
||||
from torch.utils.data._utils.collate import default_collate
|
||||
|
||||
@PIPELINES.register_module(Tasks.image_inpainting,
|
||||
module_name=Pipelines.image_inpainting +
|
||||
'-v2')
|
||||
class ImageInpaintingPipelineV2(ImageInpaintingPipeline):
|
||||
def perform_inference(self, data):
|
||||
px_budget = 9000000
|
||||
batch = default_collate([data])
|
||||
if self.refine:
|
||||
assert 'unpad_to_size' in batch, 'Unpadded size is required for the refinement'
|
||||
assert 'cuda' in str(
|
||||
self.device), 'GPU is required for refinement'
|
||||
gpu_ids = str(self.device).split(':')[-1]
|
||||
cur_res = refine_predict(batch,
|
||||
self.infer_model,
|
||||
gpu_ids=gpu_ids,
|
||||
modulo=self.pad_out_to_modulo,
|
||||
n_iters=15,
|
||||
lr=0.002,
|
||||
min_side=512,
|
||||
max_scales=3,
|
||||
px_budget=px_budget)
|
||||
cur_res = cur_res[0].permute(1, 2,
|
||||
0).detach().cpu().numpy()
|
||||
else:
|
||||
with torch.no_grad():
|
||||
batch = self.move_to_device(batch, self.device)
|
||||
batch['mask'] = (batch['mask'] > 0) * 1
|
||||
batch = self.infer_model(batch)
|
||||
cur_res = batch['inpainted'][0].permute(
|
||||
1, 2, 0).detach().cpu().numpy()
|
||||
unpad_to_size = batch.get('unpad_to_size', None)
|
||||
if unpad_to_size is not None:
|
||||
orig_height, orig_width = unpad_to_size
|
||||
cur_res = cur_res[:orig_height, :orig_width]
|
||||
|
||||
cur_res = np.clip(cur_res * 255, 0, 255).astype('uint8')
|
||||
cur_res = cv2.cvtColor(cur_res, cv2.COLOR_RGB2BGR)
|
||||
return cur_res
|
||||
|
||||
lama_model_dir = FS.get_dir_to_local_dir(cfg.PRETRAINED_MODEL)
|
||||
self.lama_model = pipeline(Tasks.image_inpainting,
|
||||
model=lama_model_dir,
|
||||
pipeline_name=Pipelines.image_inpainting +
|
||||
'-v2',
|
||||
refine=True,
|
||||
device='cuda:{}'.format(we.device_id))
|
||||
|
||||
def forward(self, image, mask):
|
||||
mask = dilate_mask(mask, dilate_factor=19)
|
||||
input_mask = Image.fromarray(mask)
|
||||
mask_expanded = np.tile(np.expand_dims(mask, axis=-1), (1, 1, 3))
|
||||
input_image_np = np.array(image)
|
||||
input_image_np[mask_expanded == 255] = 0
|
||||
input_image = Image.fromarray(input_image_np)
|
||||
input = {
|
||||
'img': input_image,
|
||||
'mask': input_mask,
|
||||
}
|
||||
result = self.lama_model(input)
|
||||
output_img = result['output_img']
|
||||
return output_img[..., ::-1]
|
||||
|
||||
@staticmethod
|
||||
def get_config_template():
|
||||
return dict_to_yaml('ANNOTATORS',
|
||||
__class__.__name__,
|
||||
LamaAnnotator.para_dict,
|
||||
set_name=True)
|
||||
@@ -10,7 +10,7 @@ class BaseModel(torch.nn.Module):
|
||||
Args:
|
||||
path (str): file path
|
||||
"""
|
||||
parameters = torch.load(path, map_location=torch.device('cpu'))
|
||||
parameters = torch.load(path, map_location=torch.device('cpu'), weights_only=True)
|
||||
|
||||
if 'optimizer' in parameters:
|
||||
parameters = parameters['model']
|
||||
|
||||
@@ -29,7 +29,7 @@ class MLSDdetector(BaseAnnotator, metaclass=ABCMeta):
|
||||
pretrained_model = cfg.get('PRETRAINED_MODEL', None)
|
||||
if pretrained_model:
|
||||
with FS.get_from(pretrained_model, wait_finish=True) as local_path:
|
||||
model.load_state_dict(torch.load(local_path), strict=True)
|
||||
model.load_state_dict(torch.load(local_path, weights_only=True), strict=True)
|
||||
self.model = model.eval()
|
||||
self.thr_v = cfg.get('THR_V', 0.1)
|
||||
self.thr_d = cfg.get('THR_D', 0.1)
|
||||
|
||||
@@ -9,9 +9,10 @@ import os
|
||||
from abc import ABCMeta
|
||||
from collections import OrderedDict
|
||||
|
||||
import numpy as np
|
||||
|
||||
import cv2
|
||||
import matplotlib
|
||||
import numpy as np
|
||||
import torch
|
||||
import torch.nn as nn
|
||||
from PIL import Image
|
||||
@@ -422,7 +423,7 @@ class Hand(object):
|
||||
self.model = handpose_model()
|
||||
if torch.cuda.is_available():
|
||||
self.model = self.model.to(device)
|
||||
model_dict = transfer(self.model, torch.load(model_path))
|
||||
model_dict = transfer(self.model, torch.load(model_path, weights_only=True))
|
||||
self.model.load_state_dict(model_dict)
|
||||
self.model.eval()
|
||||
self.device = device
|
||||
@@ -478,7 +479,7 @@ class Hand(object):
|
||||
map_ori = heatmap_avg[:, :, part]
|
||||
one_heatmap = gaussian_filter(map_ori, sigma=3)
|
||||
binary = np.ascontiguousarray(one_heatmap > thre, dtype=np.uint8)
|
||||
# 全部小于阈值
|
||||
|
||||
if np.sum(binary) == 0:
|
||||
all_peaks.append([0, 0])
|
||||
continue
|
||||
@@ -502,7 +503,7 @@ class Body(object):
|
||||
self.model = bodypose_model()
|
||||
if torch.cuda.is_available():
|
||||
self.model = self.model.to(device)
|
||||
model_dict = transfer(self.model, torch.load(model_path))
|
||||
model_dict = transfer(self.model, torch.load(model_path, weights_only=True))
|
||||
self.model.load_state_dict(model_dict)
|
||||
self.model.eval()
|
||||
self.device = device
|
||||
@@ -788,7 +789,7 @@ class OpenposeAnnotator(BaseAnnotator, metaclass=ABCMeta):
|
||||
raise f'Unsurpport datatype{type(image)}, only surpport np.ndarray, torch.Tensor, Pillow Image.'
|
||||
image = image[:, :, ::-1]
|
||||
candidate, subset = self.body_estimation(image)
|
||||
canvas = np.zeros_like(image)
|
||||
canvas = np.zeros_like(image, order='C') # to check
|
||||
canvas = draw_bodypose(canvas, candidate, subset)
|
||||
if self.use_hand:
|
||||
hands_list = handDetect(candidate, subset, image)
|
||||
|
||||
@@ -0,0 +1,199 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
import math
|
||||
import random
|
||||
from abc import ABCMeta
|
||||
|
||||
import numpy as np
|
||||
import torch
|
||||
from PIL import Image, ImageDraw
|
||||
|
||||
from scepter.modules.annotator.base_annotator import BaseAnnotator
|
||||
from scepter.modules.annotator.registry import ANNOTATORS
|
||||
from scepter.modules.utils.config import dict_to_yaml
|
||||
|
||||
|
||||
@ANNOTATORS.register_class()
|
||||
class OutpaintingAnnotator(BaseAnnotator, metaclass=ABCMeta):
|
||||
para_dict = {}
|
||||
|
||||
def __init__(self, cfg, logger=None):
|
||||
super().__init__(cfg, logger=logger)
|
||||
self.mask_blur = cfg.get('MASK_BLUR', 0)
|
||||
self.random_cfg = cfg.get('RANDOM_CFG', None)
|
||||
self.return_mask = cfg.get('RETURN_MASK', False)
|
||||
self.return_source = cfg.get('RETURN_SOURCE', True)
|
||||
self.keep_padding_ratio = cfg.get('KEEP_PADDING_RATIO', 64)
|
||||
self.mask_color = cfg.get('MASK_COLOR', 0)
|
||||
|
||||
def get_box(self, mask):
|
||||
locs = np.where(mask == 255)
|
||||
if len(locs) < 1 or locs[0].shape[0] < 1 or locs[1].shape[0] < 1:
|
||||
return None
|
||||
left, right = np.min(locs[1]), np.max(locs[1])
|
||||
top, bottom = np.min(locs[0]), np.max(locs[0])
|
||||
return [left, top, right, bottom]
|
||||
|
||||
def forward(self,
|
||||
image,
|
||||
ratio=0.3,
|
||||
mask=None,
|
||||
direction=['left', 'right', 'up', 'down'],
|
||||
return_mask=None,
|
||||
return_source=None,
|
||||
mask_color=None):
|
||||
return_mask = return_mask if return_mask is not None else self.return_mask
|
||||
return_source = return_source if return_source is not None else self.return_source
|
||||
mask_color = mask_color if mask_color is not None else self.mask_color
|
||||
if isinstance(image, Image.Image):
|
||||
image = image
|
||||
elif isinstance(image, torch.Tensor):
|
||||
image = Image.fromarray(image.detach().cpu().numpy())
|
||||
elif isinstance(image, np.ndarray):
|
||||
image = Image.fromarray(image.copy())
|
||||
else:
|
||||
raise f'Unsurpport datatype{type(image)}, only surpport np.ndarray, torch.Tensor, Pillow Image.'
|
||||
|
||||
if self.random_cfg:
|
||||
direction_range = self.random_cfg.get(
|
||||
'DIRECTION_RANGE', ['left', 'right', 'up', 'down'])
|
||||
ratio_range = self.random_cfg.get('RATIO_RANGE', [0.0, 1.0])
|
||||
direction = random.sample(
|
||||
direction_range,
|
||||
random.choice(list(range(1,
|
||||
len(direction_range) + 1))))
|
||||
ratio = random.uniform(ratio_range[0], ratio_range[1])
|
||||
|
||||
if mask is None:
|
||||
init_image = image
|
||||
src_width, src_height = init_image.width, init_image.height
|
||||
left = int(ratio * src_width) if 'left' in direction else 0
|
||||
right = int(ratio * src_width) if 'right' in direction else 0
|
||||
up = int(ratio * src_height) if 'up' in direction else 0
|
||||
down = int(ratio * src_height) if 'down' in direction else 0
|
||||
# print(direction, ratio, left, right, up, down)
|
||||
tar_width = math.ceil(
|
||||
(src_width + left + right) /
|
||||
self.keep_padding_ratio) * self.keep_padding_ratio
|
||||
tar_height = math.ceil(
|
||||
(src_height + up + down) /
|
||||
self.keep_padding_ratio) * self.keep_padding_ratio
|
||||
if left > 0:
|
||||
left = left * (tar_width - src_width) // (left + right)
|
||||
if right > 0:
|
||||
right = tar_width - src_width - left
|
||||
if up > 0:
|
||||
up = up * (tar_height - src_height) // (up + down)
|
||||
if down > 0:
|
||||
down = tar_height - src_height - up
|
||||
if mask_color is not None:
|
||||
img = Image.new('RGB', (tar_width, tar_height),
|
||||
color=mask_color)
|
||||
else:
|
||||
img = Image.new('RGB', (tar_width, tar_height))
|
||||
img.paste(init_image, (left, up))
|
||||
mask = Image.new('L', (img.width, img.height), 'white')
|
||||
draw = ImageDraw.Draw(mask)
|
||||
|
||||
draw.rectangle(
|
||||
(left + (self.mask_blur * 2 if left > 0 else 0), up +
|
||||
(self.mask_blur * 2 if up > 0 else 0), mask.width - right -
|
||||
(self.mask_blur * 2 if right > 0 else 0), mask.height - down -
|
||||
(self.mask_blur * 2 if down > 0 else 0)),
|
||||
fill='black')
|
||||
else:
|
||||
bbox = self.get_box(np.array(mask))
|
||||
if bbox is None:
|
||||
img = image
|
||||
mask = mask
|
||||
init_image = image
|
||||
else:
|
||||
mask = Image.new('L', (image.width, image.height), 'white')
|
||||
mask_zero = Image.new('L',
|
||||
(bbox[2] - bbox[0], bbox[3] - bbox[1]),
|
||||
'black')
|
||||
mask.paste(mask_zero, (bbox[0], bbox[1]))
|
||||
crop_image = image.crop(bbox)
|
||||
init_image = Image.new('RGB', (image.width, image.height),
|
||||
'black')
|
||||
init_image.paste(crop_image, (bbox[0], bbox[1]))
|
||||
img = image
|
||||
if return_mask:
|
||||
if return_source:
|
||||
ret_data = {
|
||||
'src_image': np.array(init_image),
|
||||
'image': np.array(img),
|
||||
'mask': np.array(mask)
|
||||
}
|
||||
else:
|
||||
ret_data = {'image': np.array(img), 'mask': np.array(mask)}
|
||||
else:
|
||||
if return_source:
|
||||
ret_data = {
|
||||
'src_image': np.array(init_image),
|
||||
'image': np.array(img)
|
||||
}
|
||||
else:
|
||||
ret_data = np.array(img)
|
||||
return ret_data
|
||||
|
||||
@staticmethod
|
||||
def get_config_template():
|
||||
return dict_to_yaml('ANNOTATORS',
|
||||
__class__.__name__,
|
||||
OutpaintingAnnotator.para_dict,
|
||||
set_name=True)
|
||||
|
||||
|
||||
@ANNOTATORS.register_class()
|
||||
class OutpaintingResize(BaseAnnotator, metaclass=ABCMeta):
|
||||
para_dict = {}
|
||||
|
||||
def __init__(self, cfg, logger=None):
|
||||
super().__init__(cfg, logger=logger)
|
||||
|
||||
def get_box(self, mask):
|
||||
locs = np.where(mask == 0)
|
||||
if len(locs) < 1 or locs[0].shape[0] < 1 or locs[1].shape[0] < 1:
|
||||
return None
|
||||
left, right = np.min(locs[1]), np.max(locs[1])
|
||||
top, bottom = np.min(locs[0]), np.max(locs[0])
|
||||
return [left, top, right, bottom]
|
||||
|
||||
def forward(self, image, target_image, mask=None):
|
||||
if isinstance(image, Image.Image):
|
||||
image = image
|
||||
elif isinstance(image, torch.Tensor):
|
||||
image = Image.fromarray(image.detach().cpu().numpy())
|
||||
elif isinstance(image, np.ndarray):
|
||||
image = Image.fromarray(image.copy())
|
||||
else:
|
||||
raise f'Unsurpport datatype{type(image)}, only surpport np.ndarray, torch.Tensor, Pillow Image.'
|
||||
|
||||
if isinstance(target_image, Image.Image):
|
||||
target_image = target_image
|
||||
elif isinstance(target_image, torch.Tensor):
|
||||
target_image = Image.fromarray(target_image.detach().cpu().numpy())
|
||||
elif isinstance(target_image, np.ndarray):
|
||||
target_image = Image.fromarray(target_image.copy())
|
||||
else:
|
||||
raise f'Unsurpport datatype{type(target_image)}, only surpport np.ndarray, torch.Tensor, Pillow Image.'
|
||||
|
||||
bbox = self.get_box(np.array(mask))
|
||||
if bbox is None:
|
||||
init_image = image
|
||||
else:
|
||||
paste_img = image.resize((bbox[2] - bbox[0], bbox[3] - bbox[1]))
|
||||
init_image = Image.new('RGB',
|
||||
(target_image.width, target_image.height),
|
||||
'black')
|
||||
init_image.paste(paste_img, (bbox[0], bbox[1]))
|
||||
ret_data = {'src_image': np.array(init_image)}
|
||||
return ret_data
|
||||
|
||||
@staticmethod
|
||||
def get_config_template():
|
||||
return dict_to_yaml('ANNOTATORS',
|
||||
__class__.__name__,
|
||||
OutpaintingResize.para_dict,
|
||||
set_name=True)
|
||||
@@ -0,0 +1,934 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
import math
|
||||
from abc import ABCMeta
|
||||
|
||||
import numpy as np
|
||||
|
||||
import torch
|
||||
import torch.nn as nn
|
||||
import torch.nn.functional as F
|
||||
from einops import rearrange
|
||||
from scepter.modules.annotator.base_annotator import BaseAnnotator
|
||||
from scepter.modules.annotator.registry import ANNOTATORS
|
||||
from scepter.modules.utils.config import dict_to_yaml
|
||||
from scepter.modules.utils.distribute import we
|
||||
from scepter.modules.utils.file_system import FS
|
||||
|
||||
CONFIGS = {
|
||||
'baseline': {
|
||||
'layer0': 'cv',
|
||||
'layer1': 'cv',
|
||||
'layer2': 'cv',
|
||||
'layer3': 'cv',
|
||||
'layer4': 'cv',
|
||||
'layer5': 'cv',
|
||||
'layer6': 'cv',
|
||||
'layer7': 'cv',
|
||||
'layer8': 'cv',
|
||||
'layer9': 'cv',
|
||||
'layer10': 'cv',
|
||||
'layer11': 'cv',
|
||||
'layer12': 'cv',
|
||||
'layer13': 'cv',
|
||||
'layer14': 'cv',
|
||||
'layer15': 'cv',
|
||||
},
|
||||
'c-v15': {
|
||||
'layer0': 'cd',
|
||||
'layer1': 'cv',
|
||||
'layer2': 'cv',
|
||||
'layer3': 'cv',
|
||||
'layer4': 'cv',
|
||||
'layer5': 'cv',
|
||||
'layer6': 'cv',
|
||||
'layer7': 'cv',
|
||||
'layer8': 'cv',
|
||||
'layer9': 'cv',
|
||||
'layer10': 'cv',
|
||||
'layer11': 'cv',
|
||||
'layer12': 'cv',
|
||||
'layer13': 'cv',
|
||||
'layer14': 'cv',
|
||||
'layer15': 'cv',
|
||||
},
|
||||
'a-v15': {
|
||||
'layer0': 'ad',
|
||||
'layer1': 'cv',
|
||||
'layer2': 'cv',
|
||||
'layer3': 'cv',
|
||||
'layer4': 'cv',
|
||||
'layer5': 'cv',
|
||||
'layer6': 'cv',
|
||||
'layer7': 'cv',
|
||||
'layer8': 'cv',
|
||||
'layer9': 'cv',
|
||||
'layer10': 'cv',
|
||||
'layer11': 'cv',
|
||||
'layer12': 'cv',
|
||||
'layer13': 'cv',
|
||||
'layer14': 'cv',
|
||||
'layer15': 'cv',
|
||||
},
|
||||
'r-v15': {
|
||||
'layer0': 'rd',
|
||||
'layer1': 'cv',
|
||||
'layer2': 'cv',
|
||||
'layer3': 'cv',
|
||||
'layer4': 'cv',
|
||||
'layer5': 'cv',
|
||||
'layer6': 'cv',
|
||||
'layer7': 'cv',
|
||||
'layer8': 'cv',
|
||||
'layer9': 'cv',
|
||||
'layer10': 'cv',
|
||||
'layer11': 'cv',
|
||||
'layer12': 'cv',
|
||||
'layer13': 'cv',
|
||||
'layer14': 'cv',
|
||||
'layer15': 'cv',
|
||||
},
|
||||
'cvvv4': {
|
||||
'layer0': 'cd',
|
||||
'layer1': 'cv',
|
||||
'layer2': 'cv',
|
||||
'layer3': 'cv',
|
||||
'layer4': 'cd',
|
||||
'layer5': 'cv',
|
||||
'layer6': 'cv',
|
||||
'layer7': 'cv',
|
||||
'layer8': 'cd',
|
||||
'layer9': 'cv',
|
||||
'layer10': 'cv',
|
||||
'layer11': 'cv',
|
||||
'layer12': 'cd',
|
||||
'layer13': 'cv',
|
||||
'layer14': 'cv',
|
||||
'layer15': 'cv',
|
||||
},
|
||||
'avvv4': {
|
||||
'layer0': 'ad',
|
||||
'layer1': 'cv',
|
||||
'layer2': 'cv',
|
||||
'layer3': 'cv',
|
||||
'layer4': 'ad',
|
||||
'layer5': 'cv',
|
||||
'layer6': 'cv',
|
||||
'layer7': 'cv',
|
||||
'layer8': 'ad',
|
||||
'layer9': 'cv',
|
||||
'layer10': 'cv',
|
||||
'layer11': 'cv',
|
||||
'layer12': 'ad',
|
||||
'layer13': 'cv',
|
||||
'layer14': 'cv',
|
||||
'layer15': 'cv',
|
||||
},
|
||||
'rvvv4': {
|
||||
'layer0': 'rd',
|
||||
'layer1': 'cv',
|
||||
'layer2': 'cv',
|
||||
'layer3': 'cv',
|
||||
'layer4': 'rd',
|
||||
'layer5': 'cv',
|
||||
'layer6': 'cv',
|
||||
'layer7': 'cv',
|
||||
'layer8': 'rd',
|
||||
'layer9': 'cv',
|
||||
'layer10': 'cv',
|
||||
'layer11': 'cv',
|
||||
'layer12': 'rd',
|
||||
'layer13': 'cv',
|
||||
'layer14': 'cv',
|
||||
'layer15': 'cv',
|
||||
},
|
||||
'cccv4': {
|
||||
'layer0': 'cd',
|
||||
'layer1': 'cd',
|
||||
'layer2': 'cd',
|
||||
'layer3': 'cv',
|
||||
'layer4': 'cd',
|
||||
'layer5': 'cd',
|
||||
'layer6': 'cd',
|
||||
'layer7': 'cv',
|
||||
'layer8': 'cd',
|
||||
'layer9': 'cd',
|
||||
'layer10': 'cd',
|
||||
'layer11': 'cv',
|
||||
'layer12': 'cd',
|
||||
'layer13': 'cd',
|
||||
'layer14': 'cd',
|
||||
'layer15': 'cv',
|
||||
},
|
||||
'aaav4': {
|
||||
'layer0': 'ad',
|
||||
'layer1': 'ad',
|
||||
'layer2': 'ad',
|
||||
'layer3': 'cv',
|
||||
'layer4': 'ad',
|
||||
'layer5': 'ad',
|
||||
'layer6': 'ad',
|
||||
'layer7': 'cv',
|
||||
'layer8': 'ad',
|
||||
'layer9': 'ad',
|
||||
'layer10': 'ad',
|
||||
'layer11': 'cv',
|
||||
'layer12': 'ad',
|
||||
'layer13': 'ad',
|
||||
'layer14': 'ad',
|
||||
'layer15': 'cv',
|
||||
},
|
||||
'rrrv4': {
|
||||
'layer0': 'rd',
|
||||
'layer1': 'rd',
|
||||
'layer2': 'rd',
|
||||
'layer3': 'cv',
|
||||
'layer4': 'rd',
|
||||
'layer5': 'rd',
|
||||
'layer6': 'rd',
|
||||
'layer7': 'cv',
|
||||
'layer8': 'rd',
|
||||
'layer9': 'rd',
|
||||
'layer10': 'rd',
|
||||
'layer11': 'cv',
|
||||
'layer12': 'rd',
|
||||
'layer13': 'rd',
|
||||
'layer14': 'rd',
|
||||
'layer15': 'cv',
|
||||
},
|
||||
'c16': {
|
||||
'layer0': 'cd',
|
||||
'layer1': 'cd',
|
||||
'layer2': 'cd',
|
||||
'layer3': 'cd',
|
||||
'layer4': 'cd',
|
||||
'layer5': 'cd',
|
||||
'layer6': 'cd',
|
||||
'layer7': 'cd',
|
||||
'layer8': 'cd',
|
||||
'layer9': 'cd',
|
||||
'layer10': 'cd',
|
||||
'layer11': 'cd',
|
||||
'layer12': 'cd',
|
||||
'layer13': 'cd',
|
||||
'layer14': 'cd',
|
||||
'layer15': 'cd',
|
||||
},
|
||||
'a16': {
|
||||
'layer0': 'ad',
|
||||
'layer1': 'ad',
|
||||
'layer2': 'ad',
|
||||
'layer3': 'ad',
|
||||
'layer4': 'ad',
|
||||
'layer5': 'ad',
|
||||
'layer6': 'ad',
|
||||
'layer7': 'ad',
|
||||
'layer8': 'ad',
|
||||
'layer9': 'ad',
|
||||
'layer10': 'ad',
|
||||
'layer11': 'ad',
|
||||
'layer12': 'ad',
|
||||
'layer13': 'ad',
|
||||
'layer14': 'ad',
|
||||
'layer15': 'ad',
|
||||
},
|
||||
'r16': {
|
||||
'layer0': 'rd',
|
||||
'layer1': 'rd',
|
||||
'layer2': 'rd',
|
||||
'layer3': 'rd',
|
||||
'layer4': 'rd',
|
||||
'layer5': 'rd',
|
||||
'layer6': 'rd',
|
||||
'layer7': 'rd',
|
||||
'layer8': 'rd',
|
||||
'layer9': 'rd',
|
||||
'layer10': 'rd',
|
||||
'layer11': 'rd',
|
||||
'layer12': 'rd',
|
||||
'layer13': 'rd',
|
||||
'layer14': 'rd',
|
||||
'layer15': 'rd',
|
||||
},
|
||||
'carv4': {
|
||||
'layer0': 'cd',
|
||||
'layer1': 'ad',
|
||||
'layer2': 'rd',
|
||||
'layer3': 'cv',
|
||||
'layer4': 'cd',
|
||||
'layer5': 'ad',
|
||||
'layer6': 'rd',
|
||||
'layer7': 'cv',
|
||||
'layer8': 'cd',
|
||||
'layer9': 'ad',
|
||||
'layer10': 'rd',
|
||||
'layer11': 'cv',
|
||||
'layer12': 'cd',
|
||||
'layer13': 'ad',
|
||||
'layer14': 'rd',
|
||||
'layer15': 'cv'
|
||||
}
|
||||
}
|
||||
|
||||
|
||||
def create_conv_func(op_type):
|
||||
assert op_type in ['cv', 'cd', 'ad',
|
||||
'rd'], 'unknown op type: %s' % str(op_type)
|
||||
if op_type == 'cv':
|
||||
return F.conv2d
|
||||
if op_type == 'cd':
|
||||
|
||||
def func(x,
|
||||
weights,
|
||||
bias=None,
|
||||
stride=1,
|
||||
padding=0,
|
||||
dilation=1,
|
||||
groups=1):
|
||||
assert dilation in [1,
|
||||
2], 'dilation for cd_conv should be in 1 or 2'
|
||||
assert weights.size(2) == 3 and weights.size(3) == 3, \
|
||||
'kernel size for cd_conv should be 3x3'
|
||||
assert padding == dilation, 'padding for cd_conv set wrong'
|
||||
|
||||
weights_c = weights.sum(dim=[2, 3], keepdim=True)
|
||||
yc = F.conv2d(x,
|
||||
weights_c,
|
||||
stride=stride,
|
||||
padding=0,
|
||||
groups=groups)
|
||||
y = F.conv2d(x,
|
||||
weights,
|
||||
bias,
|
||||
stride=stride,
|
||||
padding=padding,
|
||||
dilation=dilation,
|
||||
groups=groups)
|
||||
return y - yc
|
||||
|
||||
return func
|
||||
elif op_type == 'ad':
|
||||
|
||||
def func(x,
|
||||
weights,
|
||||
bias=None,
|
||||
stride=1,
|
||||
padding=0,
|
||||
dilation=1,
|
||||
groups=1):
|
||||
assert dilation in [1,
|
||||
2], 'dilation for ad_conv should be in 1 or 2'
|
||||
assert weights.size(2) == 3 and weights.size(3) == 3, \
|
||||
'kernel size for ad_conv should be 3x3'
|
||||
assert padding == dilation, 'padding for ad_conv set wrong'
|
||||
|
||||
shape = weights.shape
|
||||
weights = weights.view(shape[0], shape[1], -1)
|
||||
# clock-wise
|
||||
weights_conv = (
|
||||
weights -
|
||||
weights[:, :, [3, 0, 1, 6, 4, 2, 7, 8, 5]]).view(shape)
|
||||
y = F.conv2d(x,
|
||||
weights_conv,
|
||||
bias,
|
||||
stride=stride,
|
||||
padding=padding,
|
||||
dilation=dilation,
|
||||
groups=groups)
|
||||
return y
|
||||
|
||||
return func
|
||||
elif op_type == 'rd':
|
||||
|
||||
def func(x,
|
||||
weights,
|
||||
bias=None,
|
||||
stride=1,
|
||||
padding=0,
|
||||
dilation=1,
|
||||
groups=1):
|
||||
assert dilation in [1,
|
||||
2], 'dilation for rd_conv should be in 1 or 2'
|
||||
assert weights.size(2) == 3 and weights.size(3) == 3, \
|
||||
'kernel size for rd_conv should be 3x3'
|
||||
padding = 2 * dilation
|
||||
|
||||
shape = weights.shape
|
||||
if weights.is_cuda:
|
||||
buffer = torch.cuda.FloatTensor(shape[0], shape[1],
|
||||
5 * 5).fill_(0)
|
||||
else:
|
||||
buffer = torch.zeros(shape[0], shape[1], 5 * 5)
|
||||
weights = weights.view(shape[0], shape[1], -1)
|
||||
buffer[:, :, [0, 2, 4, 10, 14, 20, 22, 24]] = weights[:, :, 1:]
|
||||
buffer[:, :, [6, 7, 8, 11, 13, 16, 17, 18]] = -weights[:, :, 1:]
|
||||
buffer[:, :, 12] = 0
|
||||
buffer = buffer.view(shape[0], shape[1], 5, 5)
|
||||
y = F.conv2d(x,
|
||||
buffer,
|
||||
bias,
|
||||
stride=stride,
|
||||
padding=padding,
|
||||
dilation=dilation,
|
||||
groups=groups)
|
||||
return y
|
||||
|
||||
return func
|
||||
else:
|
||||
print('impossible to be here unless you force that', flush=True)
|
||||
return None
|
||||
|
||||
|
||||
def config_model(model):
|
||||
model_options = list(CONFIGS.keys())
|
||||
assert model in model_options, \
|
||||
'unrecognized model, please choose from %s' % str(model_options)
|
||||
|
||||
pdcs = []
|
||||
for i in range(16):
|
||||
layer_name = 'layer%d' % i
|
||||
op = CONFIGS[model][layer_name]
|
||||
pdcs.append(create_conv_func(op))
|
||||
return pdcs
|
||||
|
||||
|
||||
def config_model_converted(model):
|
||||
model_options = list(CONFIGS.keys())
|
||||
assert model in model_options, \
|
||||
'unrecognized model, please choose from %s' % str(model_options)
|
||||
|
||||
pdcs = []
|
||||
for i in range(16):
|
||||
layer_name = 'layer%d' % i
|
||||
op = CONFIGS[model][layer_name]
|
||||
pdcs.append(op)
|
||||
return pdcs
|
||||
|
||||
|
||||
def convert_pdc(op, weight):
|
||||
if op == 'cv':
|
||||
return weight
|
||||
elif op == 'cd':
|
||||
shape = weight.shape
|
||||
weight_c = weight.sum(dim=[2, 3])
|
||||
weight = weight.view(shape[0], shape[1], -1)
|
||||
weight[:, :, 4] = weight[:, :, 4] - weight_c
|
||||
weight = weight.view(shape)
|
||||
return weight
|
||||
elif op == 'ad':
|
||||
shape = weight.shape
|
||||
weight = weight.view(shape[0], shape[1], -1)
|
||||
weight_conv = (weight -
|
||||
weight[:, :, [3, 0, 1, 6, 4, 2, 7, 8, 5]]).view(shape)
|
||||
return weight_conv
|
||||
elif op == 'rd':
|
||||
shape = weight.shape
|
||||
buffer = torch.zeros(shape[0], shape[1], 5 * 5, device=weight.device)
|
||||
weight = weight.view(shape[0], shape[1], -1)
|
||||
buffer[:, :, [0, 2, 4, 10, 14, 20, 22, 24]] = weight[:, :, 1:]
|
||||
buffer[:, :, [6, 7, 8, 11, 13, 16, 17, 18]] = -weight[:, :, 1:]
|
||||
buffer = buffer.view(shape[0], shape[1], 5, 5)
|
||||
return buffer
|
||||
raise ValueError('wrong op {}'.format(str(op)))
|
||||
|
||||
|
||||
def convert_pidinet(state_dict, config):
|
||||
pdcs = config_model_converted(config)
|
||||
new_dict = {}
|
||||
for pname, p in state_dict.items():
|
||||
if 'init_block.weight' in pname:
|
||||
new_dict[pname] = convert_pdc(pdcs[0], p)
|
||||
elif 'block1_1.conv1.weight' in pname:
|
||||
new_dict[pname] = convert_pdc(pdcs[1], p)
|
||||
elif 'block1_2.conv1.weight' in pname:
|
||||
new_dict[pname] = convert_pdc(pdcs[2], p)
|
||||
elif 'block1_3.conv1.weight' in pname:
|
||||
new_dict[pname] = convert_pdc(pdcs[3], p)
|
||||
elif 'block2_1.conv1.weight' in pname:
|
||||
new_dict[pname] = convert_pdc(pdcs[4], p)
|
||||
elif 'block2_2.conv1.weight' in pname:
|
||||
new_dict[pname] = convert_pdc(pdcs[5], p)
|
||||
elif 'block2_3.conv1.weight' in pname:
|
||||
new_dict[pname] = convert_pdc(pdcs[6], p)
|
||||
elif 'block2_4.conv1.weight' in pname:
|
||||
new_dict[pname] = convert_pdc(pdcs[7], p)
|
||||
elif 'block3_1.conv1.weight' in pname:
|
||||
new_dict[pname] = convert_pdc(pdcs[8], p)
|
||||
elif 'block3_2.conv1.weight' in pname:
|
||||
new_dict[pname] = convert_pdc(pdcs[9], p)
|
||||
elif 'block3_3.conv1.weight' in pname:
|
||||
new_dict[pname] = convert_pdc(pdcs[10], p)
|
||||
elif 'block3_4.conv1.weight' in pname:
|
||||
new_dict[pname] = convert_pdc(pdcs[11], p)
|
||||
elif 'block4_1.conv1.weight' in pname:
|
||||
new_dict[pname] = convert_pdc(pdcs[12], p)
|
||||
elif 'block4_2.conv1.weight' in pname:
|
||||
new_dict[pname] = convert_pdc(pdcs[13], p)
|
||||
elif 'block4_3.conv1.weight' in pname:
|
||||
new_dict[pname] = convert_pdc(pdcs[14], p)
|
||||
elif 'block4_4.conv1.weight' in pname:
|
||||
new_dict[pname] = convert_pdc(pdcs[15], p)
|
||||
else:
|
||||
new_dict[pname] = p
|
||||
return new_dict
|
||||
|
||||
|
||||
class Conv2d(nn.Module):
|
||||
def __init__(self,
|
||||
pdc,
|
||||
in_channels,
|
||||
out_channels,
|
||||
kernel_size,
|
||||
stride=1,
|
||||
padding=0,
|
||||
dilation=1,
|
||||
groups=1,
|
||||
bias=False):
|
||||
super().__init__()
|
||||
if in_channels % groups != 0:
|
||||
raise ValueError('in_channels must be divisible by groups')
|
||||
if out_channels % groups != 0:
|
||||
raise ValueError('out_channels must be divisible by groups')
|
||||
self.in_channels = in_channels
|
||||
self.out_channels = out_channels
|
||||
self.kernel_size = kernel_size
|
||||
self.stride = stride
|
||||
self.padding = padding
|
||||
self.dilation = dilation
|
||||
self.groups = groups
|
||||
self.weight = nn.Parameter(
|
||||
torch.Tensor(out_channels, in_channels // groups, kernel_size,
|
||||
kernel_size))
|
||||
if bias:
|
||||
self.bias = nn.Parameter(torch.Tensor(out_channels))
|
||||
else:
|
||||
self.register_parameter('bias', None)
|
||||
self.reset_parameters()
|
||||
self.pdc = pdc
|
||||
|
||||
def reset_parameters(self):
|
||||
nn.init.kaiming_uniform_(self.weight, a=math.sqrt(5))
|
||||
if self.bias is not None:
|
||||
fan_in, _ = nn.init._calculate_fan_in_and_fan_out(self.weight)
|
||||
bound = 1 / math.sqrt(fan_in)
|
||||
nn.init.uniform_(self.bias, -bound, bound)
|
||||
|
||||
def forward(self, input):
|
||||
return self.pdc(input, self.weight, self.bias, self.stride,
|
||||
self.padding, self.dilation, self.groups)
|
||||
|
||||
|
||||
class CSAM(nn.Module):
|
||||
"""
|
||||
Compact Spatial Attention Module
|
||||
"""
|
||||
def __init__(self, channels):
|
||||
super().__init__()
|
||||
|
||||
mid_channels = 4
|
||||
self.relu1 = nn.ReLU()
|
||||
self.conv1 = nn.Conv2d(channels,
|
||||
mid_channels,
|
||||
kernel_size=1,
|
||||
padding=0)
|
||||
self.conv2 = nn.Conv2d(mid_channels,
|
||||
1,
|
||||
kernel_size=3,
|
||||
padding=1,
|
||||
bias=False)
|
||||
self.sigmoid = nn.Sigmoid()
|
||||
nn.init.constant_(self.conv1.bias, 0)
|
||||
|
||||
def forward(self, x):
|
||||
y = self.relu1(x)
|
||||
y = self.conv1(y)
|
||||
y = self.conv2(y)
|
||||
y = self.sigmoid(y)
|
||||
|
||||
return x * y
|
||||
|
||||
|
||||
class CDCM(nn.Module):
|
||||
"""
|
||||
Compact Dilation Convolution based Module
|
||||
"""
|
||||
def __init__(self, in_channels, out_channels):
|
||||
super().__init__()
|
||||
|
||||
self.relu1 = nn.ReLU()
|
||||
self.conv1 = nn.Conv2d(in_channels,
|
||||
out_channels,
|
||||
kernel_size=1,
|
||||
padding=0)
|
||||
self.conv2_1 = nn.Conv2d(out_channels,
|
||||
out_channels,
|
||||
kernel_size=3,
|
||||
dilation=5,
|
||||
padding=5,
|
||||
bias=False)
|
||||
self.conv2_2 = nn.Conv2d(out_channels,
|
||||
out_channels,
|
||||
kernel_size=3,
|
||||
dilation=7,
|
||||
padding=7,
|
||||
bias=False)
|
||||
self.conv2_3 = nn.Conv2d(out_channels,
|
||||
out_channels,
|
||||
kernel_size=3,
|
||||
dilation=9,
|
||||
padding=9,
|
||||
bias=False)
|
||||
self.conv2_4 = nn.Conv2d(out_channels,
|
||||
out_channels,
|
||||
kernel_size=3,
|
||||
dilation=11,
|
||||
padding=11,
|
||||
bias=False)
|
||||
nn.init.constant_(self.conv1.bias, 0)
|
||||
|
||||
def forward(self, x):
|
||||
x = self.relu1(x)
|
||||
x = self.conv1(x)
|
||||
x1 = self.conv2_1(x)
|
||||
x2 = self.conv2_2(x)
|
||||
x3 = self.conv2_3(x)
|
||||
x4 = self.conv2_4(x)
|
||||
return x1 + x2 + x3 + x4
|
||||
|
||||
|
||||
class MapReduce(nn.Module):
|
||||
"""
|
||||
Reduce feature maps into a single edge map
|
||||
"""
|
||||
def __init__(self, channels):
|
||||
super().__init__()
|
||||
self.conv = nn.Conv2d(channels, 1, kernel_size=1, padding=0)
|
||||
nn.init.constant_(self.conv.bias, 0)
|
||||
|
||||
def forward(self, x):
|
||||
return self.conv(x)
|
||||
|
||||
|
||||
class PDCBlock(nn.Module):
|
||||
def __init__(self, pdc, inplane, ouplane, stride=1):
|
||||
super().__init__()
|
||||
self.stride = stride
|
||||
|
||||
self.stride = stride
|
||||
if self.stride > 1:
|
||||
self.pool = nn.MaxPool2d(kernel_size=2, stride=2)
|
||||
self.shortcut = nn.Conv2d(inplane,
|
||||
ouplane,
|
||||
kernel_size=1,
|
||||
padding=0)
|
||||
self.conv1 = Conv2d(pdc,
|
||||
inplane,
|
||||
inplane,
|
||||
kernel_size=3,
|
||||
padding=1,
|
||||
groups=inplane,
|
||||
bias=False)
|
||||
self.relu2 = nn.ReLU()
|
||||
self.conv2 = nn.Conv2d(inplane,
|
||||
ouplane,
|
||||
kernel_size=1,
|
||||
padding=0,
|
||||
bias=False)
|
||||
|
||||
def forward(self, x):
|
||||
if self.stride > 1:
|
||||
x = self.pool(x)
|
||||
y = self.conv1(x)
|
||||
y = self.relu2(y)
|
||||
y = self.conv2(y)
|
||||
if self.stride > 1:
|
||||
x = self.shortcut(x)
|
||||
y = y + x
|
||||
return y
|
||||
|
||||
|
||||
class PDCBlock_converted(nn.Module):
|
||||
"""
|
||||
CPDC, APDC can be converted to vanilla 3x3 convolution
|
||||
RPDC can be converted to vanilla 5x5 convolution
|
||||
"""
|
||||
def __init__(self, pdc, inplane, ouplane, stride=1):
|
||||
super().__init__()
|
||||
self.stride = stride
|
||||
|
||||
if self.stride > 1:
|
||||
self.pool = nn.MaxPool2d(kernel_size=2, stride=2)
|
||||
self.shortcut = nn.Conv2d(inplane,
|
||||
ouplane,
|
||||
kernel_size=1,
|
||||
padding=0)
|
||||
if pdc == 'rd':
|
||||
self.conv1 = nn.Conv2d(inplane,
|
||||
inplane,
|
||||
kernel_size=5,
|
||||
padding=2,
|
||||
groups=inplane,
|
||||
bias=False)
|
||||
else:
|
||||
self.conv1 = nn.Conv2d(inplane,
|
||||
inplane,
|
||||
kernel_size=3,
|
||||
padding=1,
|
||||
groups=inplane,
|
||||
bias=False)
|
||||
self.relu2 = nn.ReLU()
|
||||
self.conv2 = nn.Conv2d(inplane,
|
||||
ouplane,
|
||||
kernel_size=1,
|
||||
padding=0,
|
||||
bias=False)
|
||||
|
||||
def forward(self, x):
|
||||
if self.stride > 1:
|
||||
x = self.pool(x)
|
||||
y = self.conv1(x)
|
||||
y = self.relu2(y)
|
||||
y = self.conv2(y)
|
||||
if self.stride > 1:
|
||||
x = self.shortcut(x)
|
||||
y = y + x
|
||||
return y
|
||||
|
||||
|
||||
class PiDiNet(nn.Module):
|
||||
def __init__(self,
|
||||
inplane,
|
||||
pdcs,
|
||||
dil=None,
|
||||
sa=False,
|
||||
convert=False,
|
||||
mean=[0.485, 0.456, 0.406],
|
||||
std=[0.229, 0.224, 0.225]):
|
||||
super().__init__()
|
||||
self.sa = sa
|
||||
if dil is not None:
|
||||
assert isinstance(dil, int), 'dil should be an int'
|
||||
self.dil = dil
|
||||
self.mean = mean
|
||||
self.std = std
|
||||
|
||||
self.fuseplanes = []
|
||||
|
||||
self.inplane = inplane
|
||||
if convert:
|
||||
if pdcs[0] == 'rd':
|
||||
init_kernel_size = 5
|
||||
init_padding = 2
|
||||
else:
|
||||
init_kernel_size = 3
|
||||
init_padding = 1
|
||||
self.init_block = nn.Conv2d(3,
|
||||
self.inplane,
|
||||
kernel_size=init_kernel_size,
|
||||
padding=init_padding,
|
||||
bias=False)
|
||||
block_class = PDCBlock_converted
|
||||
else:
|
||||
self.init_block = Conv2d(pdcs[0],
|
||||
3,
|
||||
self.inplane,
|
||||
kernel_size=3,
|
||||
padding=1)
|
||||
block_class = PDCBlock
|
||||
|
||||
self.block1_1 = block_class(pdcs[1], self.inplane, self.inplane)
|
||||
self.block1_2 = block_class(pdcs[2], self.inplane, self.inplane)
|
||||
self.block1_3 = block_class(pdcs[3], self.inplane, self.inplane)
|
||||
self.fuseplanes.append(self.inplane) # C
|
||||
|
||||
inplane = self.inplane
|
||||
self.inplane = self.inplane * 2
|
||||
self.block2_1 = block_class(pdcs[4], inplane, self.inplane, stride=2)
|
||||
self.block2_2 = block_class(pdcs[5], self.inplane, self.inplane)
|
||||
self.block2_3 = block_class(pdcs[6], self.inplane, self.inplane)
|
||||
self.block2_4 = block_class(pdcs[7], self.inplane, self.inplane)
|
||||
self.fuseplanes.append(self.inplane) # 2C
|
||||
|
||||
inplane = self.inplane
|
||||
self.inplane = self.inplane * 2
|
||||
self.block3_1 = block_class(pdcs[8], inplane, self.inplane, stride=2)
|
||||
self.block3_2 = block_class(pdcs[9], self.inplane, self.inplane)
|
||||
self.block3_3 = block_class(pdcs[10], self.inplane, self.inplane)
|
||||
self.block3_4 = block_class(pdcs[11], self.inplane, self.inplane)
|
||||
self.fuseplanes.append(self.inplane) # 4C
|
||||
|
||||
self.block4_1 = block_class(pdcs[12],
|
||||
self.inplane,
|
||||
self.inplane,
|
||||
stride=2)
|
||||
self.block4_2 = block_class(pdcs[13], self.inplane, self.inplane)
|
||||
self.block4_3 = block_class(pdcs[14], self.inplane, self.inplane)
|
||||
self.block4_4 = block_class(pdcs[15], self.inplane, self.inplane)
|
||||
self.fuseplanes.append(self.inplane) # 4C
|
||||
|
||||
self.conv_reduces = nn.ModuleList()
|
||||
if self.sa and self.dil is not None:
|
||||
self.attentions = nn.ModuleList()
|
||||
self.dilations = nn.ModuleList()
|
||||
for i in range(4):
|
||||
self.dilations.append(CDCM(self.fuseplanes[i], self.dil))
|
||||
self.attentions.append(CSAM(self.dil))
|
||||
self.conv_reduces.append(MapReduce(self.dil))
|
||||
elif self.sa:
|
||||
self.attentions = nn.ModuleList()
|
||||
for i in range(4):
|
||||
self.attentions.append(CSAM(self.fuseplanes[i]))
|
||||
self.conv_reduces.append(MapReduce(self.fuseplanes[i]))
|
||||
elif self.dil is not None:
|
||||
self.dilations = nn.ModuleList()
|
||||
for i in range(4):
|
||||
self.dilations.append(CDCM(self.fuseplanes[i], self.dil))
|
||||
self.conv_reduces.append(MapReduce(self.dil))
|
||||
else:
|
||||
for i in range(4):
|
||||
self.conv_reduces.append(MapReduce(self.fuseplanes[i]))
|
||||
|
||||
self.classifier = nn.Conv2d(4, 1, kernel_size=1) # has bias
|
||||
nn.init.constant_(self.classifier.weight, 0.25)
|
||||
nn.init.constant_(self.classifier.bias, 0)
|
||||
|
||||
def get_weights(self):
|
||||
conv_weights = []
|
||||
bn_weights = []
|
||||
relu_weights = []
|
||||
for pname, p in self.named_parameters():
|
||||
if 'bn' in pname:
|
||||
bn_weights.append(p)
|
||||
elif 'relu' in pname:
|
||||
relu_weights.append(p)
|
||||
else:
|
||||
conv_weights.append(p)
|
||||
|
||||
return conv_weights, bn_weights, relu_weights
|
||||
|
||||
def forward(self, x):
|
||||
"""x: [B, 3, H, W] within range [0, 1].
|
||||
"""
|
||||
x = (x - x.new_tensor(self.mean).view(1, -1, 1, 1)) / \
|
||||
x.new_tensor(self.std).view(1, -1, 1, 1)
|
||||
h, w = x.size()[2:]
|
||||
|
||||
x = self.init_block(x)
|
||||
|
||||
x1 = self.block1_1(x)
|
||||
x1 = self.block1_2(x1)
|
||||
x1 = self.block1_3(x1)
|
||||
|
||||
x2 = self.block2_1(x1)
|
||||
x2 = self.block2_2(x2)
|
||||
x2 = self.block2_3(x2)
|
||||
x2 = self.block2_4(x2)
|
||||
|
||||
x3 = self.block3_1(x2)
|
||||
x3 = self.block3_2(x3)
|
||||
x3 = self.block3_3(x3)
|
||||
x3 = self.block3_4(x3)
|
||||
|
||||
x4 = self.block4_1(x3)
|
||||
x4 = self.block4_2(x4)
|
||||
x4 = self.block4_3(x4)
|
||||
x4 = self.block4_4(x4)
|
||||
|
||||
x_fuses = []
|
||||
if self.sa and self.dil is not None:
|
||||
for i, xi in enumerate([x1, x2, x3, x4]):
|
||||
x_fuses.append(self.attentions[i](self.dilations[i](xi)))
|
||||
elif self.sa:
|
||||
for i, xi in enumerate([x1, x2, x3, x4]):
|
||||
x_fuses.append(self.attentions[i](xi))
|
||||
elif self.dil is not None:
|
||||
for i, xi in enumerate([x1, x2, x3, x4]):
|
||||
x_fuses.append(self.dilations[i](xi))
|
||||
else:
|
||||
x_fuses = [x1, x2, x3, x4]
|
||||
|
||||
e1 = self.conv_reduces[0](x_fuses[0])
|
||||
e1 = F.interpolate(e1, (h, w), mode='bilinear', align_corners=False)
|
||||
|
||||
e2 = self.conv_reduces[1](x_fuses[1])
|
||||
e2 = F.interpolate(e2, (h, w), mode='bilinear', align_corners=False)
|
||||
|
||||
e3 = self.conv_reduces[2](x_fuses[2])
|
||||
e3 = F.interpolate(e3, (h, w), mode='bilinear', align_corners=False)
|
||||
|
||||
e4 = self.conv_reduces[3](x_fuses[3])
|
||||
e4 = F.interpolate(e4, (h, w), mode='bilinear', align_corners=False)
|
||||
|
||||
outputs = [e1, e2, e3, e4]
|
||||
output = self.classifier(torch.cat(outputs, dim=1))
|
||||
|
||||
outputs.append(output)
|
||||
outputs = [torch.sigmoid(r) for r in outputs]
|
||||
return outputs[-1]
|
||||
|
||||
|
||||
@ANNOTATORS.register_class()
|
||||
class PiDiAnnotator(BaseAnnotator, metaclass=ABCMeta):
|
||||
para_dict = {}
|
||||
|
||||
def __init__(self, cfg, logger=None):
|
||||
super().__init__(cfg, logger=logger)
|
||||
pretrained_model = cfg.get('PRETRAINED_MODEL', None)
|
||||
vanilla_cnn = cfg.get('VANILLA_CNN', True)
|
||||
pdcs = config_model_converted(
|
||||
'carv4') if vanilla_cnn else config_model('carv4')
|
||||
self.model = PiDiNet(60, pdcs, dil=24, sa=True,
|
||||
convert=vanilla_cnn).eval()
|
||||
if pretrained_model:
|
||||
with FS.get_from(pretrained_model, wait_finish=True) as local_path:
|
||||
state = torch.load(local_path,
|
||||
map_location='cpu', weights_only=True)['state_dict']
|
||||
if vanilla_cnn:
|
||||
state = convert_pidinet(state, 'carv4')
|
||||
state = {
|
||||
k[len('module.'):] if k.startswith('module.') else k: v
|
||||
for k, v in state.items()
|
||||
}
|
||||
self.model.load_state_dict(state)
|
||||
|
||||
@torch.no_grad()
|
||||
@torch.inference_mode()
|
||||
@torch.autocast('cuda', enabled=False)
|
||||
def forward(self, image, return_grayscale=False):
|
||||
is_batch = False if len(image.shape) == 3 else True
|
||||
if isinstance(image, torch.Tensor):
|
||||
if len(image.shape) == 3:
|
||||
image = rearrange(image, 'h w c -> 1 c h w')
|
||||
elif len(image.shape) == 4:
|
||||
image = rearrange(image, 'b h w c -> b c h w')
|
||||
else:
|
||||
raise "Unsurpport input image's shape"
|
||||
elif isinstance(image, np.ndarray):
|
||||
image = torch.from_numpy(image.copy()).float()
|
||||
if len(image.shape) == 3:
|
||||
image = rearrange(image, 'h w c -> 1 c h w')
|
||||
elif len(image.shape) == 4:
|
||||
image = rearrange(image, 'b h w c -> b c h w')
|
||||
else:
|
||||
raise "Unsurpport input image's shape"
|
||||
else:
|
||||
raise "Unsurpport input image's type"
|
||||
image = image.float().div(255)
|
||||
image = image.to(we.device_id)
|
||||
edge = self.model(image)
|
||||
edge = edge.squeeze(dim=1)
|
||||
edge = 255 - (edge * 255.0).clip(0, 255) # return white background
|
||||
edge = edge.cpu().numpy()
|
||||
edge = edge.astype(np.uint8)
|
||||
if not is_batch:
|
||||
edge = edge.squeeze()
|
||||
if not return_grayscale:
|
||||
edge = edge[..., None].repeat(3, -1)
|
||||
return edge
|
||||
|
||||
@staticmethod
|
||||
def get_config_template():
|
||||
return dict_to_yaml('ANNOTATORS',
|
||||
__class__.__name__,
|
||||
PiDiAnnotator.para_dict,
|
||||
set_name=True)
|
||||
@@ -15,7 +15,7 @@ def build_annotator(cfg, registry, logger=None, *args, **kwargs):
|
||||
raise TypeError(f'Config must be type dict, got {type(cfg)}')
|
||||
if cfg.have('PRETRAINED_MODEL'):
|
||||
pretrain_cfg = cfg.PRETRAINED_MODEL
|
||||
if pretrain_cfg is not None and not isinstance(pretrain_cfg, (str)):
|
||||
if pretrain_cfg is not None and not isinstance(pretrain_cfg, (str, list)):
|
||||
raise TypeError('Pretrain parameter must be a string')
|
||||
else:
|
||||
pretrain_cfg = None
|
||||
|
||||
@@ -0,0 +1,388 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
import random
|
||||
from abc import ABCMeta
|
||||
|
||||
import cv2
|
||||
import numpy as np
|
||||
import torch
|
||||
import torchvision.transforms as T
|
||||
from PIL import Image
|
||||
from pycocotools import mask as mask_utils
|
||||
from scipy import ndimage
|
||||
try:
|
||||
from sklearn.cluster import KMeans
|
||||
except:
|
||||
import warnings
|
||||
warnings.warn("ignore sklearn import, please pip install scikit-learn.")
|
||||
from torchvision.ops.boxes import batched_nms
|
||||
|
||||
from scepter.modules.annotator.base_annotator import BaseAnnotator
|
||||
from scepter.modules.annotator.registry import ANNOTATORS
|
||||
from scepter.modules.utils.config import dict_to_yaml
|
||||
from scepter.modules.utils.distribute import we
|
||||
from scepter.modules.utils.file_system import FS
|
||||
|
||||
|
||||
def find_dominant_color(image, k=1):
|
||||
pixels = image.reshape((-1, 3))
|
||||
mask = (pixels != [0, 0, 0]).all(axis=1)
|
||||
pixels = pixels[mask]
|
||||
try:
|
||||
kmeans = KMeans(n_clusters=k, n_init='auto')
|
||||
kmeans.fit(pixels)
|
||||
dominant_color = kmeans.cluster_centers_.astype(int)[0]
|
||||
except Exception:
|
||||
dominant_color = np.array([255, 255, 255])
|
||||
return dominant_color
|
||||
|
||||
|
||||
def cv2_resize_crop(image, resize_size, crop_size):
|
||||
resize_height, resize_width = resize_size
|
||||
crop_height, crop_width = crop_size
|
||||
|
||||
resized_image = cv2.resize(image, (resize_width, resize_height))
|
||||
|
||||
center_x, center_y = resize_width // 2, resize_height // 2
|
||||
crop_start_x = max(center_x - crop_width // 2, 0)
|
||||
crop_start_y = max(center_y - crop_height // 2, 0)
|
||||
crop_end_x = crop_start_x + crop_width
|
||||
crop_end_y = crop_start_y + crop_height
|
||||
|
||||
crop_end_x = min(crop_end_x, resize_width)
|
||||
crop_end_y = min(crop_end_y, resize_height)
|
||||
|
||||
center_cropped_image = resized_image[crop_start_y:crop_end_y,
|
||||
crop_start_x:crop_end_x]
|
||||
|
||||
return center_cropped_image
|
||||
|
||||
|
||||
@ANNOTATORS.register_class()
|
||||
class ESAMAnnotator(BaseAnnotator, metaclass=ABCMeta):
|
||||
para_dict = {}
|
||||
|
||||
def __init__(self, cfg, logger=None):
|
||||
super().__init__(cfg, logger=logger)
|
||||
try:
|
||||
from efficient_sam.efficient_sam import build_efficient_sam
|
||||
except Exception:
|
||||
raise NotImplementedError(
|
||||
'Please install efficient_sam and segment_anything modules.')
|
||||
|
||||
pretrained_model = cfg.get('PRETRAINED_MODEL', None)
|
||||
if pretrained_model:
|
||||
with FS.get_from(pretrained_model, wait_finish=True) as local_path:
|
||||
self.efficient_sam_module = build_efficient_sam(
|
||||
encoder_patch_embed_dim=384,
|
||||
encoder_num_heads=6,
|
||||
checkpoint=local_path).eval().to(we.device_id)
|
||||
self.GRID_SIZE = cfg.get('GRID_SIZE', 16)
|
||||
self.save_mode = cfg.get('SAVE_MODE', 'P')
|
||||
self.use_dominant_color = cfg.get('USE_DOMINANT_COLOR', False)
|
||||
self.return_mask = cfg.get('RETURN_MASK', False)
|
||||
|
||||
@torch.no_grad()
|
||||
def get_predictions_given_embeddings_and_queries(self, img, points,
|
||||
point_labels, model):
|
||||
from segment_anything.utils.amg import calculate_stability_score
|
||||
predicted_masks, predicted_iou = [], []
|
||||
bs = 128
|
||||
num = int(float(self.GRID_SIZE * self.GRID_SIZE) /
|
||||
bs) if self.GRID_SIZE * self.GRID_SIZE % bs == 0 else int(
|
||||
float(self.GRID_SIZE * self.GRID_SIZE) / bs) + 1
|
||||
for i in range(num):
|
||||
predicted_mask_item, predicted_iou_item = model(
|
||||
img[None, ...], points[:, i * bs:(i + 1) * bs, ...],
|
||||
point_labels[:, i * bs:(i + 1) * bs, :])
|
||||
predicted_masks.append(predicted_mask_item)
|
||||
predicted_iou.append(predicted_iou_item)
|
||||
torch.cuda.empty_cache()
|
||||
# # predicted: torch.Size([1, 1024, 3]) torch.Size([1, 1024, 3, 512, 512])
|
||||
# print('predicted: ', predicted_iou.size(), predicted_masks.size())
|
||||
predicted_masks = torch.cat(predicted_masks, dim=1)
|
||||
predicted_iou = torch.cat(predicted_iou, dim=1)
|
||||
sorted_ids = torch.argsort(predicted_iou, dim=-1, descending=True)
|
||||
predicted_iou_scores = torch.take_along_dim(predicted_iou,
|
||||
sorted_ids,
|
||||
dim=2)
|
||||
predicted_masks = torch.take_along_dim(predicted_masks,
|
||||
sorted_ids[..., None, None],
|
||||
dim=2)
|
||||
predicted_masks = predicted_masks[0]
|
||||
iou = predicted_iou_scores[0, :, 0]
|
||||
index_iou = iou > 0.7
|
||||
iou_ = iou[index_iou]
|
||||
masks = predicted_masks[index_iou]
|
||||
score = calculate_stability_score(masks, 0.0, 1.0)
|
||||
score = score[:, 0]
|
||||
index = score > 0.9
|
||||
masks = masks[index]
|
||||
iou_ = iou_[index]
|
||||
masks = torch.ge(masks, 0.0)
|
||||
return masks, iou_
|
||||
|
||||
def singel_mask_to_rle(self, mask):
|
||||
rle = mask_utils.encode(
|
||||
np.array(mask[:, :, None], order='F', dtype='uint8'))[0]
|
||||
rle['counts'] = rle['counts'].decode('utf-8')
|
||||
return rle
|
||||
|
||||
def process_small_region(self, rles):
|
||||
from segment_anything.utils.amg import rle_to_mask, remove_small_regions, \
|
||||
batched_mask_to_box, mask_to_rle_pytorch
|
||||
new_masks = []
|
||||
scores = []
|
||||
min_area = 100
|
||||
nms_thresh = 0.7
|
||||
for rle in rles:
|
||||
mask = rle_to_mask(rle[0])
|
||||
|
||||
mask, changed = remove_small_regions(mask, min_area, mode='holes')
|
||||
unchanged = not changed
|
||||
mask, changed = remove_small_regions(mask,
|
||||
min_area,
|
||||
mode='islands')
|
||||
unchanged = unchanged and not changed
|
||||
|
||||
new_masks.append(torch.as_tensor(mask).unsqueeze(0))
|
||||
# Give score=0 to changed masks and score=1 to unchanged masks
|
||||
# so NMS will prefer ones that didn't need postprocessing
|
||||
scores.append(float(unchanged))
|
||||
|
||||
# Recalculate boxes and remove any new duplicates
|
||||
masks = torch.cat(new_masks, dim=0).to(we.device_id)
|
||||
boxes = batched_mask_to_box(masks)
|
||||
keep_by_nms = batched_nms(
|
||||
boxes.float(),
|
||||
torch.as_tensor(scores).to(we.device_id),
|
||||
torch.zeros_like(boxes[:, 0]), # categories
|
||||
iou_threshold=nms_thresh,
|
||||
)
|
||||
|
||||
# Only recalculate RLEs for masks that have changed
|
||||
for i_mask in keep_by_nms:
|
||||
if scores[i_mask] == 0.0:
|
||||
mask_torch = masks[i_mask].unsqueeze(0)
|
||||
rles[i_mask] = mask_to_rle_pytorch(mask_torch)
|
||||
masks = [rle_to_mask(rles[i][0]) for i in keep_by_nms]
|
||||
return masks
|
||||
|
||||
def run_everything_ours(self, img_tensor, model):
|
||||
from segment_anything.utils.amg import mask_to_rle_pytorch
|
||||
img_tensor = img_tensor.squeeze(0)
|
||||
_, original_image_h, original_image_w = img_tensor.shape
|
||||
xy = []
|
||||
for i in range(self.GRID_SIZE):
|
||||
curr_x = 0.5 + i / self.GRID_SIZE * original_image_w
|
||||
for j in range(self.GRID_SIZE):
|
||||
curr_y = 0.5 + j / self.GRID_SIZE * original_image_h
|
||||
xy.append([curr_x, curr_y])
|
||||
|
||||
xy = torch.from_numpy(np.array(xy))
|
||||
points = xy
|
||||
num_pts = xy.shape[0]
|
||||
point_labels = torch.ones(num_pts, 1)
|
||||
with torch.no_grad():
|
||||
predicted_masks, predicted_iou = self.get_predictions_given_embeddings_and_queries(
|
||||
img_tensor,
|
||||
points.reshape(1, num_pts, 1, 2).to(we.device_id),
|
||||
point_labels.reshape(1, num_pts, 1).to(we.device_id),
|
||||
model,
|
||||
)
|
||||
# print('predicted_masks: ', predicted_masks[0][0:1].dtype, predicted_masks[0][0:1].device)
|
||||
rle = [mask_to_rle_pytorch(m[0:1]) for m in predicted_masks]
|
||||
# transform to numpy
|
||||
size, counts = [], []
|
||||
for rle_item in rle:
|
||||
size.append(rle_item[0]['size'])
|
||||
counts += rle_item[0]['counts']
|
||||
counts += '#'
|
||||
predicted_masks = self.process_small_region(rle)
|
||||
return predicted_masks
|
||||
|
||||
def forward(self, image, return_mask=None):
|
||||
return_mask = return_mask if return_mask is not None else self.return_mask
|
||||
if isinstance(image, Image.Image):
|
||||
image = np.array(image)
|
||||
elif isinstance(image, torch.Tensor):
|
||||
image = image.detach().cpu().numpy()
|
||||
elif isinstance(image, np.ndarray):
|
||||
image = image.copy()
|
||||
else:
|
||||
raise f'Unsurpport datatype{type(image)}, only surpport np.ndarray, torch.Tensor, Pillow Image.'
|
||||
h, w = image.shape[:2]
|
||||
max_rate = max(float(w) / 1024.0, float(h) / 1024.0)
|
||||
w_ori = int(float(w) / max_rate)
|
||||
h_ori = int(float(h) / max_rate)
|
||||
# image = T.ToTensor()(T.Resize((h_ori, w_ori))(Image.fromarray(image)))
|
||||
# image_pad = T.Pad((0, 0, 1024 - w_ori, 1024 - h_ori))(image)
|
||||
image_pad = T.Pad((0, 0, 1024 - w_ori, 1024 - h_ori))(T.Resize(
|
||||
(h_ori, w_ori))(Image.fromarray(image)))
|
||||
input_image = T.ToTensor()(image_pad)
|
||||
input_image = input_image.unsqueeze(0).to(we.device_id)
|
||||
|
||||
mask_efficient_sam_vits = self.run_everything_ours(
|
||||
input_image, self.efficient_sam_module)
|
||||
annos = []
|
||||
mask_efficient_sam_vits = sorted(list(mask_efficient_sam_vits),
|
||||
key=lambda m: int(m.sum()),
|
||||
reverse=True)
|
||||
mask_efficient_sam_vits = mask_efficient_sam_vits[:256]
|
||||
for mask in mask_efficient_sam_vits:
|
||||
mask_item = mask_utils.encode(
|
||||
np.array(mask[:, :, None], order='F', dtype='uint8'))[0]
|
||||
mask_item['counts'] = mask_item['counts'].decode('utf-8')
|
||||
mask_area = int(mask.sum())
|
||||
annos.append({'mask': mask_item, 'mask_area': mask_area})
|
||||
|
||||
annos = sorted(annos, key=lambda x: x['mask_area'], reverse=True)
|
||||
seg_img = None
|
||||
dominant_palette = []
|
||||
image_pad_np = np.array(image_pad)
|
||||
for idx, anno in enumerate(annos):
|
||||
color = idx
|
||||
if idx > 255:
|
||||
break
|
||||
mask = np.array(mask_utils.decode(anno['mask'])).astype(np.uint8)
|
||||
h, w = mask.shape[:2]
|
||||
if seg_img is None:
|
||||
seg_img = np.ones((h, w, 3)) * 255
|
||||
if self.use_dominant_color:
|
||||
masked_image = cv2.bitwise_and(image_pad_np,
|
||||
image_pad_np,
|
||||
mask=mask)
|
||||
dominant_color = find_dominant_color(masked_image).tolist()
|
||||
dominant_palette.append(dominant_color)
|
||||
seg_img[mask.astype(bool)] = [color, color, color]
|
||||
seg_img = Image.fromarray(seg_img.astype(np.uint8)).convert('L')
|
||||
|
||||
resize_rate = max(float(h_ori) / 1024.0, float(w_ori) / 1024.0)
|
||||
h_new = int(float(h_ori) / resize_rate)
|
||||
w_new = int(float(w_ori) / resize_rate)
|
||||
seg_img = seg_img.crop((0, 0, w_new, h_new))
|
||||
if self.save_mode == 'P':
|
||||
palette = []
|
||||
for i in range(256):
|
||||
if not self.use_dominant_color:
|
||||
palette_item = [random.randint(0, 255) for _ in range(3)]
|
||||
else:
|
||||
palette_item = dominant_palette[i] if i < len(
|
||||
dominant_palette) else [255, 255, 255]
|
||||
palette += palette_item
|
||||
seg_img = seg_img.convert('P')
|
||||
seg_img.putpalette(palette)
|
||||
seg_rgb_img = seg_img.convert('RGB')
|
||||
if return_mask:
|
||||
return {
|
||||
'image': np.array(seg_rgb_img),
|
||||
'mask': np.array(seg_img)
|
||||
}
|
||||
else:
|
||||
return np.array(seg_rgb_img)
|
||||
else:
|
||||
return np.array(seg_img)
|
||||
|
||||
@staticmethod
|
||||
def get_config_template():
|
||||
return dict_to_yaml('ANNOTATORS',
|
||||
__class__.__name__,
|
||||
ESAMAnnotator.para_dict,
|
||||
set_name=True)
|
||||
|
||||
|
||||
@ANNOTATORS.register_class()
|
||||
class SAMAnnotatorDraw(BaseAnnotator, metaclass=ABCMeta):
|
||||
para_dict = {}
|
||||
|
||||
def __init__(self, cfg, logger=None):
|
||||
super().__init__(cfg, logger=logger)
|
||||
from segment_anything import sam_model_registry, SamPredictor
|
||||
from segment_anything.utils.transforms import ResizeLongestSide
|
||||
|
||||
self.transform = ResizeLongestSide(1024)
|
||||
self.task_type = cfg.get('TASK_TYPE', 'input_box')
|
||||
self.sam_model = cfg.get('SAM_MODEL', 'vit_b')
|
||||
pretrained_model = cfg.get('PRETRAINED_MODEL', 'sam_vit_b_01ec64.pth')
|
||||
|
||||
if pretrained_model:
|
||||
with FS.get_from(pretrained_model, wait_finish=True) as local_path:
|
||||
seg_model = sam_model_registry[self.sam_model](
|
||||
checkpoint=local_path).eval().to(we.device_id)
|
||||
self.sam_predictor = SamPredictor(seg_model)
|
||||
|
||||
def forward(self,
|
||||
image,
|
||||
input_box=None,
|
||||
mask=None,
|
||||
task_type=None,
|
||||
multimask_output=False):
|
||||
task_type = task_type if task_type is not None else self.task_type
|
||||
|
||||
if isinstance(image, Image.Image):
|
||||
image = np.array(image)
|
||||
elif isinstance(image, torch.Tensor):
|
||||
image = image.detach().cpu().numpy()
|
||||
elif isinstance(image, np.ndarray):
|
||||
image = image.copy()
|
||||
else:
|
||||
raise f'Unsurpport datatype{type(image)}, only surpport np.ndarray, torch.Tensor, Pillow Image.'
|
||||
|
||||
if mask is not None:
|
||||
if isinstance(mask, Image.Image):
|
||||
mask = np.array(mask)
|
||||
elif isinstance(mask, torch.Tensor):
|
||||
mask = mask.detach().cpu().numpy()
|
||||
elif isinstance(mask, np.ndarray):
|
||||
mask = mask.copy()
|
||||
else:
|
||||
raise f'Unsurpport datatype{type(mask)}, only surpport np.ndarray, torch.Tensor, Pillow Image.'
|
||||
|
||||
if task_type == 'mask_point':
|
||||
scribble = mask.transpose(2, 1, 0)[0]
|
||||
labeled_array, num_features = ndimage.label(scribble >= 255)
|
||||
centers = ndimage.center_of_mass(scribble, labeled_array,
|
||||
range(1, num_features + 1))
|
||||
point_coords = np.array(centers)
|
||||
point_labels = np.array([1] * len(centers))
|
||||
sample = {
|
||||
'point_coords': point_coords,
|
||||
'point_labels': point_labels
|
||||
}
|
||||
|
||||
elif task_type == 'mask_box':
|
||||
scribble = mask.transpose(2, 1, 0)[0]
|
||||
labeled_array, num_features = ndimage.label(scribble >= 255)
|
||||
centers = ndimage.center_of_mass(scribble, labeled_array,
|
||||
range(1, num_features + 1))
|
||||
centers = np.array(centers)
|
||||
# (x1, y1, x2, y2)
|
||||
x_min = centers[:, 0].min()
|
||||
x_max = centers[:, 0].max()
|
||||
y_min = centers[:, 1].min()
|
||||
y_max = centers[:, 1].max()
|
||||
bbox = np.array([x_min, y_min, x_max, y_max])
|
||||
sample = {'box': bbox}
|
||||
|
||||
elif task_type == 'input_box':
|
||||
if isinstance(input_box, list):
|
||||
input_box = np.array(input_box)
|
||||
sample = {'box': input_box}
|
||||
|
||||
self.sam_predictor.set_image(image)
|
||||
masks, scores, logits = self.sam_predictor.predict(
|
||||
**sample, multimask_output=True)
|
||||
index = np.argmax(scores)
|
||||
|
||||
ret_data = {
|
||||
'mask': (masks[index] * 255).astype(np.uint8),
|
||||
'score': scores[index]
|
||||
}
|
||||
return ret_data
|
||||
|
||||
@staticmethod
|
||||
def get_config_template():
|
||||
return dict_to_yaml('ANNOTATORS',
|
||||
__class__.__name__,
|
||||
SAMAnnotatorDraw.para_dict,
|
||||
set_name=True)
|
||||
@@ -0,0 +1,157 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
from abc import ABCMeta
|
||||
|
||||
import numpy as np
|
||||
|
||||
import torch
|
||||
import torch.nn as nn
|
||||
from einops import rearrange
|
||||
from scepter.modules.annotator.base_annotator import BaseAnnotator
|
||||
from scepter.modules.annotator.registry import ANNOTATORS
|
||||
from scepter.modules.utils.config import dict_to_yaml
|
||||
from scepter.modules.utils.distribute import we
|
||||
from scepter.modules.utils.file_system import FS
|
||||
|
||||
|
||||
class SketchNet(nn.Module):
|
||||
def __init__(self, mean, std):
|
||||
assert isinstance(mean, float) and isinstance(std, float)
|
||||
super().__init__()
|
||||
self.mean = mean
|
||||
self.std = std
|
||||
|
||||
# layers
|
||||
self.layers = nn.Sequential(nn.Conv2d(1, 48, 5, 2, 2),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(48, 128, 3, 1, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(128, 128, 3, 1, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(128, 128, 3, 2, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(128, 256, 3, 1, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(256, 256, 3, 1, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(256, 256, 3, 2, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(256, 512, 3, 1, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(512, 1024, 3, 1, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(1024, 1024, 3, 1, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(1024, 1024, 3, 1, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(1024, 1024, 3, 1, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(1024, 512, 3, 1, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(512, 256, 3, 1, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.ConvTranspose2d(256, 256, 4, 2, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(256, 256, 3, 1, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(256, 128, 3, 1, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.ConvTranspose2d(128, 128, 4, 2, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(128, 128, 3, 1, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(128, 48, 3, 1, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.ConvTranspose2d(48, 48, 4, 2, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(48, 24, 3, 1, 1),
|
||||
nn.ReLU(inplace=True),
|
||||
nn.Conv2d(24, 1, 3, 1, 1), nn.Sigmoid())
|
||||
|
||||
def forward(self, x):
|
||||
"""x: [B, 1, H, W] within range [0, 1]. Sketch pixels in dark color.
|
||||
"""
|
||||
x = (x - self.mean) / self.std
|
||||
return self.layers(x)
|
||||
|
||||
|
||||
@ANNOTATORS.register_class()
|
||||
class SketchAnnotator(BaseAnnotator, metaclass=ABCMeta):
|
||||
para_dict = {}
|
||||
|
||||
def __init__(self, cfg, logger=None):
|
||||
super().__init__(cfg, logger=logger)
|
||||
pretrained_model = cfg.get('PRETRAINED_MODEL', None)
|
||||
self.model = SketchNet(mean=0.9664114577640158,
|
||||
std=0.0858381272736797).eval()
|
||||
if pretrained_model:
|
||||
with FS.get_from(pretrained_model, wait_finish=True) as local_path:
|
||||
state = torch.load(local_path, map_location='cpu', weights_only=True)
|
||||
self.model.load_state_dict(state)
|
||||
|
||||
@torch.no_grad()
|
||||
@torch.inference_mode()
|
||||
@torch.autocast('cuda', enabled=False)
|
||||
def forward(self, image):
|
||||
is_batch = False if len(image.shape) == 3 else True
|
||||
if isinstance(image, torch.Tensor):
|
||||
if len(image.shape) == 3:
|
||||
if torch.equal(image[:, :, 0], image[:, :, 1]) and torch.equal(
|
||||
image[:, :, 1], image[:, :, 2]):
|
||||
image = image[:, :, 0]
|
||||
else:
|
||||
raise "Unsurpport input image's shape and each channel is different"
|
||||
elif len(image.shape) == 4:
|
||||
if (torch.equal(image[:, :, :, 0], image[:, :, :, 1])
|
||||
and torch.equal(image[:, :, :, 1], image[:, :, :, 2])):
|
||||
image = image[:, :, :, 0]
|
||||
else:
|
||||
raise "Unsurpport input image's shape and each channel is different"
|
||||
if len(image.shape) == 2:
|
||||
image = rearrange(image, 'h w -> 1 h w')
|
||||
B, H, W = image.shape
|
||||
elif len(image.shape) == 3:
|
||||
B, H, W = image.shape
|
||||
else:
|
||||
raise "Unsurpport input image's shape"
|
||||
elif isinstance(image, np.ndarray):
|
||||
image = image.copy()
|
||||
if len(image.shape) == 3:
|
||||
if np.array_equal(image[:, :, 0],
|
||||
image[:, :, 1]) and np.array_equal(
|
||||
image[:, :, 1], image[:, :, 2]):
|
||||
image = image[:, :, 0]
|
||||
else:
|
||||
raise "Unsurpport input image's shape and each channel is different"
|
||||
elif len(image.shape) == 4:
|
||||
if (np.array_equal(image[:, :, :, 0], image[:, :, :, 1]) and
|
||||
np.array_equal(image[:, :, :, 1], image[:, :, :, 2])):
|
||||
image = image[:, :, :, 0]
|
||||
else:
|
||||
raise "Unsurpport input image's shape and each channel is different"
|
||||
image = torch.from_numpy(image).float()
|
||||
if len(image.shape) == 2:
|
||||
image = rearrange(image, 'h w -> 1 1 h w')
|
||||
elif len(image.shape) == 3:
|
||||
image = rearrange(image, 'b h w -> b 1 h w')
|
||||
else:
|
||||
raise "Unsurpport input image's shape"
|
||||
else:
|
||||
raise "Unsurpport input image's type"
|
||||
image = image.float().div(255)
|
||||
image = image.to(we.device_id)
|
||||
edge = self.model(image)
|
||||
edge = edge.squeeze(dim=1)
|
||||
edge = (edge * 255.0).clip(0, 255)
|
||||
edge = edge.cpu().numpy()
|
||||
edge = edge.astype(np.uint8)
|
||||
if not is_batch:
|
||||
edge = edge.squeeze()
|
||||
return edge[..., None].repeat(3, -1)
|
||||
|
||||
@staticmethod
|
||||
def get_config_template():
|
||||
return dict_to_yaml('ANNOTATORS',
|
||||
__class__.__name__,
|
||||
SketchAnnotator.para_dict,
|
||||
set_name=True)
|
||||
@@ -1,4 +1,21 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
from typing import TYPE_CHECKING
|
||||
from scepter.modules.utils.import_utils import LazyImportModule
|
||||
|
||||
from scepter.modules.data import dataset, sampler
|
||||
|
||||
if TYPE_CHECKING:
|
||||
from scepter.modules.data import dataset, sampler
|
||||
else:
|
||||
_import_structure = {
|
||||
'data': ['dataset', 'sampler']
|
||||
}
|
||||
|
||||
import sys
|
||||
sys.modules[__name__] = LazyImportModule(
|
||||
__name__,
|
||||
globals()['__file__'],
|
||||
_import_structure,
|
||||
module_spec=__spec__,
|
||||
extra_objects={},
|
||||
)
|
||||
|
||||
@@ -1,11 +1,35 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
from typing import TYPE_CHECKING
|
||||
from scepter.modules.utils.import_utils import LazyImportModule
|
||||
|
||||
from scepter.modules.data.dataset.base_dataset import BaseDataset
|
||||
from scepter.modules.data.dataset.dataset import (Image2ImageDataset,
|
||||
ImageClassifyPublicDataset,
|
||||
ImageTextPairDataset,
|
||||
Text2ImageDataset)
|
||||
from scepter.modules.data.dataset.ms_dataset import (
|
||||
ImageTextPairFolderDataset, ImageTextPairMSDataset)
|
||||
from scepter.modules.data.dataset.registry import DATASETS
|
||||
|
||||
if TYPE_CHECKING:
|
||||
from scepter.modules.data.dataset.base_dataset import BaseDataset
|
||||
from scepter.modules.data.dataset.dataset import (Image2ImageDataset,
|
||||
ImageClassifyPublicDataset,
|
||||
ImageTextPairDataset,
|
||||
Text2ImageDataset)
|
||||
from scepter.modules.data.dataset.ms_dataset import (
|
||||
ImageTextPairFolderDataset, ImageTextPairMSDataset)
|
||||
from scepter.modules.data.dataset.registry import DATASETS
|
||||
from scepter.modules.data.dataset.video_gen_dataset import VideoGenDataset
|
||||
else:
|
||||
_import_structure = {
|
||||
'base_dataset': ['BaseDataset'],
|
||||
'dataset': ['Image2ImageDataset', 'ImageClassifyPublicDataset',
|
||||
'ImageTextPairDataset', 'Text2ImageDataset'],
|
||||
'ms_dataset': ['ImageTextPairFolderDataset',
|
||||
'ImageTextPairMSDataset'],
|
||||
'registry': ['DATASETS'],
|
||||
'video_gen_dataset': ['VideoGenDataset']
|
||||
}
|
||||
|
||||
import sys
|
||||
sys.modules[__name__] = LazyImportModule(
|
||||
__name__,
|
||||
globals()['__file__'],
|
||||
_import_structure,
|
||||
module_spec=__spec__,
|
||||
extra_objects={},
|
||||
)
|
||||
|
||||
@@ -82,6 +82,8 @@ class BaseDataset(Dataset, metaclass=ABCMeta):
|
||||
overwrite=False)
|
||||
self.worker_id = worker_id
|
||||
self.logger = self.worker_logger
|
||||
self.local_we["seed"] += (worker_id + self.local_we['rank'] * 1234)
|
||||
self.seed = self.local_we["seed"]
|
||||
we.set_env(self.local_we)
|
||||
|
||||
@abstractmethod
|
||||
|
||||
@@ -4,6 +4,7 @@
|
||||
import numbers
|
||||
import os
|
||||
import sys
|
||||
import copy
|
||||
from collections.abc import Iterable
|
||||
|
||||
import numpy as np
|
||||
@@ -242,6 +243,8 @@ class Text2ImageDataset(BaseDataset):
|
||||
prompt_prefix = cfg.get('PROMPT_PREFIX', '')
|
||||
path_prefix = cfg.get('PATH_PREFIX', '')
|
||||
use_num = cfg.get('USE_NUM', -1)
|
||||
meta_cfg = cfg.get('META_CFG', None)
|
||||
meta_cfg = meta_cfg.get_lowercase_dict() if meta_cfg is not None else None
|
||||
|
||||
image_size = cfg.get('IMAGE_SIZE', 1024)
|
||||
if isinstance(image_size, numbers.Number):
|
||||
@@ -264,7 +267,12 @@ class Text2ImageDataset(BaseDataset):
|
||||
|
||||
self.items = list()
|
||||
for i, row in enumerate(rows):
|
||||
item = {'index': i, 'meta': {'image_size': image_size}}
|
||||
if meta_cfg is not None:
|
||||
meta_cfg_copy = copy.deepcopy(meta_cfg)
|
||||
meta_cfg_copy['image_size'] = image_size
|
||||
item = {'index': i, 'meta': meta_cfg_copy}
|
||||
else:
|
||||
item = {'index': i, 'meta': {'image_size': image_size}}
|
||||
for key, value in zip(fields, row):
|
||||
if key in ['prompt', 'caption', 'text']:
|
||||
item['ori_prompt'] = value
|
||||
|
||||
@@ -1,16 +1,28 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
|
||||
import io
|
||||
import math
|
||||
import numbers
|
||||
import os
|
||||
import sys
|
||||
from collections import defaultdict
|
||||
|
||||
import numpy as np
|
||||
import torch
|
||||
import torchvision.transforms as T
|
||||
from PIL import Image
|
||||
from torchvision.transforms.functional import InterpolationMode
|
||||
|
||||
from scepter.modules.data.dataset.base_dataset import BaseDataset
|
||||
from scepter.modules.data.dataset.registry import DATASETS
|
||||
from scepter.modules.transform.io import pillow_convert
|
||||
from scepter.modules.utils.config import dict_to_yaml
|
||||
from scepter.modules.utils.distribute import we
|
||||
from scepter.modules.utils.file_system import FS
|
||||
|
||||
Image.MAX_IMAGE_PIXELS = None
|
||||
|
||||
|
||||
@DATASETS.register_class()
|
||||
class ImageTextPairMSDataset(BaseDataset):
|
||||
@@ -102,7 +114,7 @@ class ImageTextPairMSDataset(BaseDataset):
|
||||
self.output_size = [self.output_size, self.output_size]
|
||||
# Use modelscope dataset
|
||||
if not ms_dataset_name:
|
||||
raise (
|
||||
raise ValueError(
|
||||
'Your must set MS_DATASET_NAME as modelscope dataset or your local dataset orignized '
|
||||
'as modelscope dataset.')
|
||||
if FS.exists(ms_dataset_name):
|
||||
@@ -125,7 +137,7 @@ class ImageTextPairMSDataset(BaseDataset):
|
||||
split=ms_dataset_split,
|
||||
download_mode=DownloadMode.FORCE_REDOWNLOAD)
|
||||
except Exception as sec_e:
|
||||
raise f'Load Modelscope dataset failed {sec_e}.'
|
||||
raise ValueError(f'Load Modelscope dataset failed {sec_e}.')
|
||||
if ms_remap_keys:
|
||||
self.data = self.data.remap_columns(ms_remap_keys.get_dict())
|
||||
|
||||
@@ -245,7 +257,7 @@ class ImageTextPairFolderDataset(BaseDataset):
|
||||
self.output_size = [self.output_size, self.output_size]
|
||||
# Use modelscope dataset
|
||||
if not data_folder or not FS.exists(data_folder):
|
||||
raise ('Your must set datafolder for local dataset.')
|
||||
raise ValueError('Your must set datafolder for local dataset.')
|
||||
data_folder = FS.get_dir_to_local_dir(data_folder)
|
||||
all_lines = open(os.path.join(data_folder, 'train.csv'),
|
||||
'r').read().split('\n')
|
||||
@@ -311,3 +323,254 @@ class ImageTextPairFolderDataset(BaseDataset):
|
||||
__class__.__name__,
|
||||
ImageTextPairMSDataset.para_dict,
|
||||
set_name=True)
|
||||
|
||||
|
||||
@DATASETS.register_class()
|
||||
class ImageTextPairMSDatasetForACE(BaseDataset):
|
||||
para_dict = {
|
||||
'MS_DATASET_NAME': {
|
||||
'value': '',
|
||||
'description': 'Modelscope dataset name.'
|
||||
},
|
||||
'MS_DATASET_NAMESPACE': {
|
||||
'value': '',
|
||||
'description': 'Modelscope dataset namespace.'
|
||||
},
|
||||
'MS_DATASET_SUBNAME': {
|
||||
'value': '',
|
||||
'description': 'Modelscope dataset subname.'
|
||||
},
|
||||
'MS_DATASET_SPLIT': {
|
||||
'value': '',
|
||||
'description':
|
||||
'Modelscope dataset split set name, default is train.'
|
||||
},
|
||||
'MS_REMAP_KEYS': {
|
||||
'value':
|
||||
None,
|
||||
'description':
|
||||
'Modelscope dataset header of list file, the default is Target:FILE; '
|
||||
'If your file is not this header, please set this field, which is a map dict.'
|
||||
"For example, { 'Image:FILE': 'Target:FILE' } will replace the filed Image:FILE to Target:FILE"
|
||||
},
|
||||
'MS_REMAP_PATH': {
|
||||
'value':
|
||||
None,
|
||||
'description':
|
||||
'When modelscope dataset name is not None, that means you use the dataset from modelscope,'
|
||||
' default is None. But if you want to use the datalist from modelscope and the file from '
|
||||
'local device, you can use this field to set the root path of your images. '
|
||||
},
|
||||
'TRIGGER_WORDS': {
|
||||
'value':
|
||||
'',
|
||||
'description':
|
||||
'The words used to describe the common features of your data, especially when you customize a '
|
||||
'tuner. Use these words you can get what you want.'
|
||||
},
|
||||
'REPLACE_STYLE': {
|
||||
'value':
|
||||
False,
|
||||
'description':
|
||||
'Whether use the MS_DATASET_SUBNAME to replace the word in your description, default is False.'
|
||||
},
|
||||
'HIGHLIGHT_KEYWORDS': {
|
||||
'value':
|
||||
'',
|
||||
'description':
|
||||
'The keywords you want to highlight in prompt, which will be replace by <HIGHLIGHT_KEYWORDS>.'
|
||||
},
|
||||
'KEYWORDS_SIGN': {
|
||||
'value':
|
||||
'',
|
||||
'description':
|
||||
'The keywords sign you want to add, which is like <{HIGHLIGHT_KEYWORDS}{KEYWORDS_SIGN}>'
|
||||
},
|
||||
'ALIGN_SIZE': {
|
||||
'value': False,
|
||||
'description':
|
||||
'Whether ensure the size align between the source image and target image.'
|
||||
},
|
||||
'OUTPUT_SIZE': {
|
||||
'value':
|
||||
None,
|
||||
'description':
|
||||
'If you use the FlexibleResize transforms, this filed will output the image_size as [h, w],'
|
||||
'which will be used to set the output size of images used to train the model.'
|
||||
},
|
||||
}
|
||||
|
||||
def __init__(self, cfg, logger=None):
|
||||
super().__init__(cfg=cfg, logger=logger)
|
||||
from modelscope import MsDataset
|
||||
from modelscope.utils.constant import DownloadMode
|
||||
ms_dataset_name = cfg.get('MS_DATASET_NAME', None)
|
||||
ms_dataset_namespace = cfg.get('MS_DATASET_NAMESPACE', None)
|
||||
ms_dataset_subname = cfg.get('MS_DATASET_SUBNAME', None)
|
||||
ms_dataset_split = cfg.get('MS_DATASET_SPLIT', 'train')
|
||||
ms_remap_keys = cfg.get('MS_REMAP_KEYS', None)
|
||||
ms_remap_path = cfg.get('MS_REMAP_PATH', None)
|
||||
|
||||
self.max_seq_len = cfg.get('MAX_SEQ_LEN', 1024)
|
||||
self.max_aspect_ratio = cfg.get('MAX_ASPECT_RATIO', 4)
|
||||
self.d = cfg.get('DOWNSAMPLE_RATIO', 16)
|
||||
self.replace_style = cfg.get('REPLACE_STYLE', False)
|
||||
self.trigger_words = cfg.get('TRIGGER_WORDS', '')
|
||||
self.replace_keywords = cfg.get('HIGHLIGHT_KEYWORDS', '')
|
||||
self.keywords_sign = cfg.get('KEYWORDS_SIGN', '')
|
||||
self.add_indicator = cfg.get('ADD_INDICATOR', False)
|
||||
|
||||
self.align_size = cfg.get('ALIGN_SIZE', False)
|
||||
# Use modelscope dataset
|
||||
if not ms_dataset_name:
|
||||
raise ValueError(
|
||||
'Your must set MS_DATASET_NAME as modelscope dataset or your local dataset orignized '
|
||||
'as modelscope dataset.')
|
||||
if FS.exists(ms_dataset_name):
|
||||
ms_dataset_name = FS.get_dir_to_local_dir(ms_dataset_name)
|
||||
self.ms_dataset_name = ms_dataset_name
|
||||
# ms_remap_path = ms_dataset_name
|
||||
try:
|
||||
self.data = MsDataset.load(str(ms_dataset_name),
|
||||
namespace=ms_dataset_namespace,
|
||||
subset_name=ms_dataset_subname,
|
||||
split=ms_dataset_split)
|
||||
except Exception:
|
||||
self.logger.info(
|
||||
"Load Modelscope dataset failed, retry with download_mode='force_redownload'."
|
||||
)
|
||||
try:
|
||||
self.data = MsDataset.load(
|
||||
str(ms_dataset_name),
|
||||
namespace=ms_dataset_namespace,
|
||||
subset_name=ms_dataset_subname,
|
||||
split=ms_dataset_split,
|
||||
download_mode=DownloadMode.FORCE_REDOWNLOAD)
|
||||
except Exception as sec_e:
|
||||
raise ValueError(f'Load Modelscope dataset failed {sec_e}.')
|
||||
if ms_remap_keys:
|
||||
self.data = self.data.remap_columns(ms_remap_keys.get_dict())
|
||||
|
||||
if ms_remap_path:
|
||||
|
||||
def map_func(example):
|
||||
return {
|
||||
k: os.path.join(ms_remap_path, v)
|
||||
if k.endswith(':FILE') else v
|
||||
for k, v in example.items()
|
||||
}
|
||||
|
||||
self.data = self.data.ds_instance.map(map_func)
|
||||
|
||||
self.transforms = T.Compose([
|
||||
T.ToTensor(),
|
||||
T.Normalize(mean=[0.5, 0.5, 0.5], std=[0.5, 0.5, 0.5])
|
||||
])
|
||||
|
||||
def __len__(self):
|
||||
if self.mode == 'train':
|
||||
return sys.maxsize
|
||||
else:
|
||||
return len(self.data)
|
||||
|
||||
def _get(self, index: int):
|
||||
current_data = self.data[index % len(self.data)]
|
||||
|
||||
tar_image_path = current_data.get('Target:FILE', '')
|
||||
src_image_path = current_data.get('Source:FILE', '')
|
||||
|
||||
style = current_data.get('Style', '')
|
||||
prompt = current_data.get('Prompt', current_data.get('prompt', ''))
|
||||
if self.replace_style and not style == '':
|
||||
prompt = prompt.replace(style, f'<{self.keywords_sign}>')
|
||||
|
||||
elif not self.replace_keywords.strip() == '':
|
||||
prompt = prompt.replace(
|
||||
self.replace_keywords,
|
||||
'<' + self.replace_keywords + f'{self.keywords_sign}>')
|
||||
|
||||
if not self.trigger_words == '':
|
||||
prompt = self.trigger_words.strip() + ' ' + prompt
|
||||
|
||||
src_image = self.load_image(self.ms_dataset_name,
|
||||
src_image_path,
|
||||
cvt_type='RGB')
|
||||
tar_image = self.load_image(self.ms_dataset_name,
|
||||
tar_image_path,
|
||||
cvt_type='RGB')
|
||||
src_image = self.image_preprocess(src_image)
|
||||
tar_image = self.image_preprocess(tar_image, size = src_image.shape[:2] if self.align_size else None)
|
||||
|
||||
tar_image = self.transforms(tar_image)
|
||||
src_image = self.transforms(src_image)
|
||||
src_mask = torch.ones_like(src_image[[0]])
|
||||
tar_mask = torch.ones_like(tar_image[[0]])
|
||||
if self.add_indicator:
|
||||
if '{image}' not in prompt:
|
||||
prompt = '{image}, ' + prompt
|
||||
return {
|
||||
'src_image_list': [src_image],
|
||||
'src_mask_list': [src_mask],
|
||||
'image': tar_image,
|
||||
'image_mask': tar_mask,
|
||||
'prompt': [prompt],
|
||||
'edit_id': [0]
|
||||
}
|
||||
|
||||
def load_image(self, prefix, img_path, cvt_type=None):
|
||||
if img_path is None or img_path == '':
|
||||
return None
|
||||
img_path = os.path.join(prefix, img_path)
|
||||
with FS.get_object(img_path) as image_bytes:
|
||||
image = Image.open(io.BytesIO(image_bytes))
|
||||
if cvt_type is not None:
|
||||
image = pillow_convert(image, cvt_type)
|
||||
return image
|
||||
|
||||
def image_preprocess(self,
|
||||
img,
|
||||
size=None,
|
||||
interpolation=InterpolationMode.BILINEAR):
|
||||
H, W = img.height, img.width
|
||||
if H / W > self.max_aspect_ratio:
|
||||
img = T.CenterCrop((self.max_aspect_ratio * W, W))(img)
|
||||
elif W / H > self.max_aspect_ratio:
|
||||
img = T.CenterCrop((H, self.max_aspect_ratio * H))(img)
|
||||
|
||||
if size is None:
|
||||
# resize image for max_seq_len, while keep the aspect ratio
|
||||
H, W = img.height, img.width
|
||||
scale = min(
|
||||
1.0,
|
||||
math.sqrt(self.max_seq_len / ((H / self.d) * (W / self.d))))
|
||||
rH = int(
|
||||
H * scale) // self.d * self.d # ensure divisible by self.d
|
||||
rW = int(W * scale) // self.d * self.d
|
||||
else:
|
||||
rH, rW = size
|
||||
img = T.Resize((rH, rW), interpolation=interpolation,
|
||||
antialias=True)(img)
|
||||
return np.array(img, dtype=np.uint8)
|
||||
|
||||
@staticmethod
|
||||
def get_config_template():
|
||||
return dict_to_yaml('DATASet',
|
||||
__class__.__name__,
|
||||
ImageTextPairMSDatasetForACE.para_dict,
|
||||
set_name=True)
|
||||
|
||||
@staticmethod
|
||||
def collate_fn(batch):
|
||||
collect = defaultdict(list)
|
||||
for sample in batch:
|
||||
for k, v in sample.items():
|
||||
collect[k].append(v)
|
||||
|
||||
new_batch = dict()
|
||||
for k, v in collect.items():
|
||||
if all([i is None for i in v]):
|
||||
new_batch[k] = None
|
||||
else:
|
||||
new_batch[k] = v
|
||||
|
||||
return new_batch
|
||||
|
||||
@@ -258,6 +258,8 @@ class DataObject(object):
|
||||
if sampler_name == 'MixtureOfSamplers':
|
||||
subsampler_configs = self.data_sampler_config.get(
|
||||
'SUB_SAMPLERS', [])
|
||||
keep_order = self.data_sampler_config.get(
|
||||
'KEEP_ORDER', False)
|
||||
subsamplers = list()
|
||||
subsampler_probs = list()
|
||||
for ssconfig in subsampler_configs:
|
||||
@@ -277,7 +279,7 @@ class DataObject(object):
|
||||
subsampler_probs.append(prob)
|
||||
self.batch_sampler = MixtureOfSamplers(subsamplers,
|
||||
subsampler_probs, rank,
|
||||
seed)
|
||||
seed, keep_order = keep_order)
|
||||
elif sampler_name == 'MultiLevelBatchSampler':
|
||||
self.batch_sampler = self._instantiate_multi_level_batch_sampler(
|
||||
self.data_sampler_config, self.batch_size, rank, seed)
|
||||
@@ -335,8 +337,12 @@ def build_dataset_config(cfg, registry, logger=None, *args, **kwargs):
|
||||
f'registry must be type Registry, got {type(registry)}')
|
||||
|
||||
cfg = deep_copy(cfg)
|
||||
|
||||
req_type = cfg.get('NAME')
|
||||
|
||||
from scepter.modules.utils.import_utils import LazyImportModule
|
||||
sig = (registry.name.upper(), req_type)
|
||||
LazyImportModule.import_module(sig)
|
||||
|
||||
if isinstance(req_type, str):
|
||||
req_type_entry = registry.get(req_type)
|
||||
if req_type_entry is None:
|
||||
|
||||
@@ -0,0 +1,202 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
import io
|
||||
import os
|
||||
import random
|
||||
import sys
|
||||
import warnings
|
||||
|
||||
import numpy as np
|
||||
import torch
|
||||
from tqdm import tqdm
|
||||
|
||||
from scepter.modules.data.dataset import DATASETS, BaseDataset
|
||||
from scepter.modules.utils.distribute import we
|
||||
from scepter.modules.utils.file_system import FS
|
||||
|
||||
try:
|
||||
import decord
|
||||
decord.bridge.set_bridge('torch')
|
||||
except ImportError:
|
||||
warnings.warn(
|
||||
'The `decord` package is required for loading the video dataset. Install with `pip install decord`'
|
||||
)
|
||||
|
||||
|
||||
@DATASETS.register_class()
|
||||
class VideoGenDataset(BaseDataset):
|
||||
def __init__(self, cfg, logger=None):
|
||||
super().__init__(cfg, logger=logger)
|
||||
self.prompt_prefix = cfg.get('PROMPT_PREFIX', '')
|
||||
self.path_prefix = cfg.get('PATH_PREFIX', '')
|
||||
self.p_zero = cfg.get('P_ZERO', 0.0)
|
||||
self.max_num_frames = cfg.get('NUM_FRAMES', 49)
|
||||
self.fps = cfg.get('FPS', 8)
|
||||
self.height = cfg.get('HEIGHT', 480)
|
||||
self.width = cfg.get('WIDTH', 720)
|
||||
self.skip_frames_start = cfg.get('SKIP_FRAMES_START', 0)
|
||||
self.skip_frames_end = cfg.get('SKIP_FRAMES_END', 0)
|
||||
self.data_type = cfg.get('DATA_TYPE', 't2v')
|
||||
|
||||
def worker_init_fn(self, worker_id, num_workers=1):
|
||||
super().worker_init_fn(worker_id, num_workers=num_workers)
|
||||
randseed = np.random.randint(0, 2**32 - num_workers - 1)
|
||||
workerseed = randseed + worker_id
|
||||
random.seed(workerseed)
|
||||
np.random.seed(workerseed)
|
||||
|
||||
def _preprocess_video_data(self, video_path):
|
||||
|
||||
with FS.get_object(video_path) as video_data:
|
||||
video_reader = decord.VideoReader(io.BytesIO(video_data),
|
||||
width=self.width,
|
||||
height=self.height)
|
||||
video_num_frames = len(video_reader)
|
||||
|
||||
start_frame = min(self.skip_frames_start, video_num_frames)
|
||||
end_frame = max(0, video_num_frames - self.skip_frames_end)
|
||||
if end_frame <= start_frame:
|
||||
frames = video_reader.get_batch([start_frame])
|
||||
elif end_frame - start_frame <= self.max_num_frames:
|
||||
frames = video_reader.get_batch(list(range(start_frame,
|
||||
end_frame)))
|
||||
else:
|
||||
indices = list(
|
||||
range(start_frame, end_frame,
|
||||
(end_frame - start_frame) // self.max_num_frames))
|
||||
frames = video_reader.get_batch(indices)
|
||||
|
||||
# Ensure that we don't go over the limit
|
||||
frames = frames[:self.max_num_frames]
|
||||
selected_num_frames = frames.shape[0]
|
||||
|
||||
# Choose first (4k + 1) frames as this is how many is required by the VAE
|
||||
remainder = (3 + (selected_num_frames % 4)) % 4
|
||||
if remainder != 0:
|
||||
frames = frames[:-remainder]
|
||||
selected_num_frames = frames.shape[0]
|
||||
|
||||
assert (selected_num_frames - 1) % 4 == 0
|
||||
|
||||
# Training transforms
|
||||
frames = frames.float().div_(127.5).sub_(1.)
|
||||
frames = frames.permute(3, 0, 1, 2).contiguous() # [C, F, H, W]
|
||||
return frames
|
||||
|
||||
def _parse_index(self, index):
|
||||
meta = dict()
|
||||
for key, value in zip(index[-1], index[:-1]):
|
||||
if key in ['oss_key', 'path', 'video_path', 'target_video_path']:
|
||||
meta['video_path'] = value
|
||||
elif key in ['source_video_path', 'src_video_path']:
|
||||
meta['src_video_path'] = value
|
||||
elif key in ['prompt', 'caption', 'text']:
|
||||
meta['prompt'] = value
|
||||
elif key in ['width', 'height']:
|
||||
meta[key] = int(value)
|
||||
else:
|
||||
meta[key] = value
|
||||
return meta
|
||||
|
||||
def _get(self, index):
|
||||
meta = self._parse_index(index)
|
||||
|
||||
video_path = os.path.join(self.path_prefix, meta.get('video_path', ''))
|
||||
video = self._preprocess_video_data(video_path)
|
||||
|
||||
prompt = self.prompt_prefix + meta.get('prompt', '')
|
||||
if self.mode == 'train' and np.random.uniform() < self.p_zero:
|
||||
prompt = ''
|
||||
|
||||
item = {
|
||||
'video': video,
|
||||
'prompt': prompt,
|
||||
'meta': meta,
|
||||
}
|
||||
if 'i2v' in self.data_type:
|
||||
item['image'] = item['video'][:, :1, :, :]
|
||||
if 'v2v' in self.data_type:
|
||||
src_video_path = os.path.join(self.path_prefix,
|
||||
meta.get('src_video_path', ''))
|
||||
src_video = self._preprocess_video_data(src_video_path)
|
||||
item['src_video'] = src_video
|
||||
return item
|
||||
|
||||
def __len__(self):
|
||||
return sys.maxsize
|
||||
|
||||
@staticmethod
|
||||
def collate_fn(batch):
|
||||
collect = {}
|
||||
for sample in batch:
|
||||
for k, v in sample.items():
|
||||
if k not in collect:
|
||||
collect[k] = []
|
||||
collect[k].append(v)
|
||||
return collect
|
||||
|
||||
|
||||
@DATASETS.register_class()
|
||||
class VideoGenDatasetOTF(VideoGenDataset):
|
||||
def __init__(self, cfg, logger=None):
|
||||
super().__init__(cfg, logger)
|
||||
self.data_file = cfg.DATA_FILE
|
||||
self.delimiter = cfg.get('DELIMITER', '#;#')
|
||||
self.fields = cfg.get('FIELDS', ['video_path', 'prompt'])
|
||||
self.use_num = cfg.get('USE_NUM', -1)
|
||||
|
||||
from scepter.modules.model.registry import MODELS
|
||||
model_cfg = cfg.get('MODEL', None)
|
||||
if model_cfg is not None:
|
||||
self.model = MODELS.build(
|
||||
cfg.MODEL,
|
||||
logger=logger).eval().requires_grad_(False).to(we.device_id)
|
||||
self.items = self.parse_data(self.data_file, self.delimiter,
|
||||
self.fields)
|
||||
if self.use_num and self.use_num > 0:
|
||||
self.items = self.items[:self.use_num]
|
||||
self.data = self.encode(self.items)
|
||||
self.real_number = len(self.data)
|
||||
if model_cfg is not None:
|
||||
self.model.to('cpu')
|
||||
del self.model
|
||||
torch.cuda.empty_cache()
|
||||
|
||||
def parse_data(self, data_file, delimiter, fields):
|
||||
items = list()
|
||||
with FS.get_object(data_file) as local_data:
|
||||
rows = [
|
||||
i.split(delimiter,
|
||||
len(fields) - 1)
|
||||
for i in local_data.decode('utf-8').strip().split('\n')
|
||||
]
|
||||
for i, row in enumerate(rows):
|
||||
item = {}
|
||||
for key, value in zip(self.fields, row):
|
||||
if key in ['oss_key', 'path', 'video_path']:
|
||||
item['video_path'] = value
|
||||
elif key in ['prompt', 'caption', 'text']:
|
||||
item['prompt'] = value
|
||||
elif key in ['width', 'height']:
|
||||
item[key] = int(value)
|
||||
else:
|
||||
item[key] = value
|
||||
items.append(item)
|
||||
return items
|
||||
|
||||
def encode(self, items):
|
||||
self.logger.info('Start to encode video data [{}]!'.format(len(items)))
|
||||
for item in tqdm(items):
|
||||
video_path = os.path.join(self.path_prefix,
|
||||
item.get('video_path', ''))
|
||||
video = self._preprocess_video_data(video_path)
|
||||
latent = self.model.encode_first_stage(
|
||||
video.unsqueeze(0).to(we.device_id)).squeeze(0)
|
||||
item['video_latent'] = latent.detach().cpu()
|
||||
item['video'] = video
|
||||
if self.data_type == 'i2v':
|
||||
item['image'] = item['video'][:, :1, :, :]
|
||||
return items
|
||||
|
||||
def _get(self, index):
|
||||
return self.data[index % self.real_number]
|
||||
@@ -1,9 +1,31 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
from typing import TYPE_CHECKING
|
||||
from scepter.modules.utils.import_utils import LazyImportModule
|
||||
|
||||
from scepter.modules.data.sampler.base_sampler import BaseSampler
|
||||
from scepter.modules.data.sampler.registry import SAMPLERS
|
||||
from scepter.modules.data.sampler.sampler import (
|
||||
EvalDistributedSampler, LoopSampler, MixtureOfSamplers,
|
||||
MultiFoldDistributedSampler, MultiLevelBatchSampler,
|
||||
MultiLevelBatchSamplerMultiSource, ResolutionBatchSampler)
|
||||
|
||||
if TYPE_CHECKING:
|
||||
from scepter.modules.data.sampler.base_sampler import BaseSampler
|
||||
from scepter.modules.data.sampler.registry import SAMPLERS
|
||||
from scepter.modules.data.sampler.sampler import (
|
||||
EvalDistributedSampler, LoopSampler, MixtureOfSamplers,
|
||||
MultiFoldDistributedSampler, MultiLevelBatchSampler,
|
||||
MultiLevelBatchSamplerMultiSource, ResolutionBatchSampler)
|
||||
else:
|
||||
_import_structure = {
|
||||
'base_sampler': ['BaseSampler'],
|
||||
'registry': ['SAMPLERS'],
|
||||
'sampler': ['EvalDistributedSampler', 'LoopSampler',
|
||||
'MixtureOfSamplers', 'MultiFoldDistributedSampler',
|
||||
'MultiLevelBatchSampler', 'MultiLevelBatchSamplerMultiSource',
|
||||
'ResolutionBatchSampler']
|
||||
}
|
||||
|
||||
import sys
|
||||
sys.modules[__name__] = LazyImportModule(
|
||||
__name__,
|
||||
globals()['__file__'],
|
||||
_import_structure,
|
||||
module_spec=__spec__,
|
||||
extra_objects={},
|
||||
)
|
||||
|
||||
@@ -35,8 +35,12 @@ def build_sampler_config(cfg, registry, logger=None, **kwargs):
|
||||
f'registry must be type Registry, got {type(registry)}')
|
||||
|
||||
cfg = deep_copy(cfg)
|
||||
|
||||
req_type = cfg.get('NAME')
|
||||
|
||||
from scepter.modules.utils.import_utils import LazyImportModule
|
||||
sig = (registry.name.upper(), req_type)
|
||||
LazyImportModule.import_module(sig)
|
||||
|
||||
if isinstance(req_type, str):
|
||||
req_type_entry = registry.get(req_type)
|
||||
if req_type_entry is None:
|
||||
|
||||
@@ -523,12 +523,15 @@ class MultiLevelBatchSampler(BaseSampler):
|
||||
class MixtureOfSamplers(BaseSampler):
|
||||
para_dict = {'SUB_SAMPLERS': []}
|
||||
|
||||
def __init__(self, samplers, probabilities, rank=0, seed=8888):
|
||||
def __init__(self, samplers, probabilities, rank=0, seed=8888, keep_order = False):
|
||||
self.samplers = samplers
|
||||
self.iterators = [iter(u) for u in samplers]
|
||||
self.probabilities = probabilities
|
||||
self.seed = seed
|
||||
self.rng = np.random.default_rng(seed + rank)
|
||||
if keep_order:
|
||||
self.rng = np.random.default_rng(seed)
|
||||
else:
|
||||
self.rng = np.random.default_rng(seed + rank)
|
||||
|
||||
def __iter__(self):
|
||||
while True:
|
||||
|
||||
@@ -1,4 +1,21 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
from typing import TYPE_CHECKING
|
||||
from scepter.modules.utils.import_utils import LazyImportModule
|
||||
|
||||
from scepter.modules.data.utils.data_bucket import BucketManager
|
||||
|
||||
if TYPE_CHECKING:
|
||||
from scepter.modules.data.utils.data_bucket import BucketManager
|
||||
else:
|
||||
_import_structure = {
|
||||
'data_bucket': ['BucketManager']
|
||||
}
|
||||
|
||||
import sys
|
||||
sys.modules[__name__] = LazyImportModule(
|
||||
__name__,
|
||||
globals()['__file__'],
|
||||
_import_structure,
|
||||
module_spec=__spec__,
|
||||
extra_objects={},
|
||||
)
|
||||
|
||||
@@ -1,3 +1,39 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
from scepter.modules.inference.diffusion_inference import DiffusionInference
|
||||
from typing import TYPE_CHECKING
|
||||
from scepter.modules.utils.import_utils import LazyImportModule
|
||||
|
||||
|
||||
if TYPE_CHECKING:
|
||||
from scepter.modules.inference.diffusion_inference import DiffusionInference
|
||||
from scepter.modules.inference.ace_inference import ACEInference
|
||||
from scepter.modules.inference.cogvideox_inference import CogVideoXInference
|
||||
from scepter.modules.inference.control_inference import ControlInference
|
||||
from scepter.modules.inference.flux_inference import FluxInference
|
||||
from scepter.modules.inference.largen_inference import LargenInference
|
||||
from scepter.modules.inference.pixart_inference import PixArtInference
|
||||
from scepter.modules.inference.sd3_inference import SD3Inference
|
||||
from scepter.modules.inference.stylebooth_inference import StyleboothInference
|
||||
from scepter.modules.inference.tuner_inference import TunerInference
|
||||
else:
|
||||
_import_structure = {
|
||||
'diffusion_inference': ['DiffusionInference'],
|
||||
'ace_inference': ['ACEInference'],
|
||||
'cogvideox_inference': ['CogVideoXInference'],
|
||||
'control_inference': ['ControlInference'],
|
||||
'flux_inference': ['FluxInference'],
|
||||
'largen_inference': ['LargenInference'],
|
||||
'pixart_inference': ['PixArtInference'],
|
||||
'sd3_inference': ['SD3Inference'],
|
||||
'stylebooth_inference': ['StyleboothInference'],
|
||||
'tuner_inference': ['TunerInference']
|
||||
}
|
||||
|
||||
import sys
|
||||
sys.modules[__name__] = LazyImportModule(
|
||||
__name__,
|
||||
globals()['__file__'],
|
||||
_import_structure,
|
||||
module_spec=__spec__,
|
||||
extra_objects={},
|
||||
)
|
||||
|
||||
@@ -0,0 +1,551 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
import copy
|
||||
import math
|
||||
import random
|
||||
|
||||
import numpy as np
|
||||
import torch
|
||||
import torch.nn as nn
|
||||
import torch.nn.functional as F
|
||||
import torchvision.transforms.functional as TF
|
||||
from PIL import Image
|
||||
import torchvision.transforms as T
|
||||
from scepter.modules.model.registry import DIFFUSIONS
|
||||
from scepter.modules.model.utils.basic_utils import check_list_of_list
|
||||
from scepter.modules.model.utils.basic_utils import \
|
||||
pack_imagelist_into_tensor_v2 as pack_imagelist_into_tensor
|
||||
from scepter.modules.model.utils.basic_utils import (
|
||||
to_device, unpack_tensor_into_imagelist)
|
||||
from scepter.modules.utils.distribute import we
|
||||
from scepter.modules.utils.logger import get_logger
|
||||
|
||||
from .diffusion_inference import DiffusionInference, get_model
|
||||
|
||||
|
||||
def process_edit_image(images,
|
||||
masks,
|
||||
tasks,
|
||||
max_seq_len=1024,
|
||||
max_aspect_ratio=4,
|
||||
d=16,
|
||||
**kwargs):
|
||||
|
||||
if not isinstance(images, list):
|
||||
images = [images]
|
||||
if not isinstance(masks, list):
|
||||
masks = [masks]
|
||||
if not isinstance(tasks, list):
|
||||
tasks = [tasks]
|
||||
|
||||
img_tensors = []
|
||||
mask_tensors = []
|
||||
for img, mask, task in zip(images, masks, tasks):
|
||||
if mask is None or mask == '':
|
||||
mask = Image.new('L', img.size, 0)
|
||||
W, H = img.size
|
||||
if H / W > max_aspect_ratio:
|
||||
img = TF.center_crop(img, [int(max_aspect_ratio * W), W])
|
||||
mask = TF.center_crop(mask, [int(max_aspect_ratio * W), W])
|
||||
elif W / H > max_aspect_ratio:
|
||||
img = TF.center_crop(img, [H, int(max_aspect_ratio * H)])
|
||||
mask = TF.center_crop(mask, [H, int(max_aspect_ratio * H)])
|
||||
|
||||
H, W = img.height, img.width
|
||||
scale = min(1.0, math.sqrt(max_seq_len / ((H / d) * (W / d))))
|
||||
rH = int(H * scale) // d * d # ensure divisible by self.d
|
||||
rW = int(W * scale) // d * d
|
||||
|
||||
img = TF.resize(img, (rH, rW),
|
||||
interpolation=TF.InterpolationMode.BICUBIC)
|
||||
mask = TF.resize(mask, (rH, rW),
|
||||
interpolation=TF.InterpolationMode.NEAREST_EXACT)
|
||||
|
||||
mask = np.asarray(mask)
|
||||
mask = np.where(mask > 128, 1, 0)
|
||||
mask = mask.astype(
|
||||
np.float32) if np.any(mask) else np.ones_like(mask).astype(
|
||||
np.float32)
|
||||
|
||||
img_tensor = TF.to_tensor(img).to(we.device_id)
|
||||
img_tensor = TF.normalize(img_tensor,
|
||||
mean=[0.5, 0.5, 0.5],
|
||||
std=[0.5, 0.5, 0.5])
|
||||
mask_tensor = TF.to_tensor(mask).to(we.device_id)
|
||||
if task in ['inpainting', 'Try On', 'Inpainting']:
|
||||
mask_indicator = mask_tensor.repeat(3, 1, 1)
|
||||
img_tensor[mask_indicator == 1] = -1.0
|
||||
img_tensors.append(img_tensor)
|
||||
mask_tensors.append(mask_tensor)
|
||||
return img_tensors, mask_tensors
|
||||
|
||||
|
||||
class TextEmbedding(nn.Module):
|
||||
def __init__(self, embedding_shape):
|
||||
super().__init__()
|
||||
self.pos = nn.Parameter(data=torch.zeros(embedding_shape))
|
||||
|
||||
class RefinerInference(DiffusionInference):
|
||||
def init_from_cfg(self, cfg):
|
||||
self.use_dynamic_model = cfg.get('USE_DYNAMIC_MODEL', True)
|
||||
super().init_from_cfg(cfg)
|
||||
self.diffusion = DIFFUSIONS.build(cfg.MODEL.DIFFUSION, logger=self.logger) \
|
||||
if cfg.MODEL.have('DIFFUSION') else None
|
||||
self.max_seq_length = cfg.MODEL.get("MAX_SEQ_LENGTH", 4096)
|
||||
assert self.diffusion is not None
|
||||
if not self.use_dynamic_model:
|
||||
self.dynamic_load(self.first_stage_model, 'first_stage_model')
|
||||
self.dynamic_load(self.cond_stage_model, 'cond_stage_model')
|
||||
self.dynamic_load(self.diffusion_model, 'diffusion_model')
|
||||
@torch.no_grad()
|
||||
def encode_first_stage(self, x, **kwargs):
|
||||
_, dtype = self.get_function_info(self.first_stage_model, 'encode')
|
||||
with torch.autocast('cuda',
|
||||
enabled=dtype in ('float16', 'bfloat16'),
|
||||
dtype=getattr(torch, dtype)):
|
||||
def run_one_image(u):
|
||||
zu = get_model(self.first_stage_model).encode(u)
|
||||
if isinstance(zu, (tuple, list)):
|
||||
zu = zu[0]
|
||||
return zu
|
||||
z = [run_one_image(u.unsqueeze(0) if u.dim == 3 else u) for u in x]
|
||||
return z
|
||||
def upscale_resize(self, image, interpolation=T.InterpolationMode.BILINEAR):
|
||||
c, H, W = image.shape
|
||||
scale = max(1.0, math.sqrt(self.max_seq_length / ((H / 16) * (W / 16))))
|
||||
rH = int(H * scale) // 16 * 16 # ensure divisible by self.d
|
||||
rW = int(W * scale) // 16 * 16
|
||||
image = T.Resize((rH, rW), interpolation=interpolation, antialias=True)(image)
|
||||
return image
|
||||
@torch.no_grad()
|
||||
def decode_first_stage(self, z):
|
||||
_, dtype = self.get_function_info(self.first_stage_model, 'decode')
|
||||
with torch.autocast('cuda',
|
||||
enabled=dtype in ('float16', 'bfloat16'),
|
||||
dtype=getattr(torch, dtype)):
|
||||
return [get_model(self.first_stage_model).decode(zu) for zu in z]
|
||||
|
||||
def noise_sample(self, num_samples, h, w, seed, device = None, dtype = torch.bfloat16):
|
||||
noise = torch.randn(
|
||||
num_samples,
|
||||
16,
|
||||
# allow for packing
|
||||
2 * math.ceil(h / 16),
|
||||
2 * math.ceil(w / 16),
|
||||
device=device,
|
||||
dtype=dtype,
|
||||
generator=torch.Generator(device=device).manual_seed(seed),
|
||||
)
|
||||
return noise
|
||||
def refine(self,
|
||||
x_samples=None,
|
||||
prompt=None,
|
||||
reverse_scale=-1.,
|
||||
seed = 2024,
|
||||
**kwargs
|
||||
):
|
||||
print(prompt)
|
||||
value_input = copy.deepcopy(self.input)
|
||||
x_samples = [self.upscale_resize(x) for x in x_samples]
|
||||
|
||||
noise = []
|
||||
for i, x in enumerate(x_samples):
|
||||
noise_ = self.noise_sample(1, x.shape[1],
|
||||
x.shape[2], seed,
|
||||
device = x.device)
|
||||
noise.append(noise_)
|
||||
noise, x_shapes = pack_imagelist_into_tensor(noise)
|
||||
if reverse_scale > 0:
|
||||
self.dynamic_load(self.first_stage_model, 'first_stage_model')
|
||||
x_samples = [x.unsqueeze(0) for x in x_samples]
|
||||
x_start = self.encode_first_stage(x_samples, **kwargs)
|
||||
self.dynamic_unload(self.first_stage_model,
|
||||
'first_stage_model',
|
||||
skip_loaded=not self.use_dynamic_model)
|
||||
x_start, _ = pack_imagelist_into_tensor(x_start)
|
||||
else:
|
||||
x_start = None
|
||||
# cond stage
|
||||
self.dynamic_load(self.cond_stage_model, 'cond_stage_model')
|
||||
function_name, dtype = self.get_function_info(self.cond_stage_model)
|
||||
with torch.autocast('cuda',
|
||||
enabled=dtype == 'float16',
|
||||
dtype=getattr(torch, dtype)):
|
||||
ctx = getattr(get_model(self.cond_stage_model),
|
||||
function_name)(prompt)
|
||||
ctx["x_shapes"] = x_shapes
|
||||
self.dynamic_unload(self.cond_stage_model,
|
||||
'cond_stage_model',
|
||||
skip_loaded=not self.use_dynamic_model)
|
||||
|
||||
|
||||
self.dynamic_load(self.diffusion_model, 'diffusion_model')
|
||||
# UNet use input n_prompt
|
||||
function_name, dtype = self.get_function_info(
|
||||
self.diffusion_model)
|
||||
with torch.autocast('cuda',
|
||||
enabled=dtype in ('float16', 'bfloat16'),
|
||||
dtype=getattr(torch, dtype)):
|
||||
solver_sample = value_input.get('sample', 'flow_euler')
|
||||
sample_steps = value_input.get('sample_steps', 20)
|
||||
guide_scale = value_input.get('guide_scale', 3.5)
|
||||
if guide_scale is not None:
|
||||
guide_scale = torch.full((noise.shape[0],), guide_scale, device=noise.device,
|
||||
dtype=noise.dtype)
|
||||
else:
|
||||
guide_scale = None
|
||||
latent = self.diffusion.sample(
|
||||
noise=noise,
|
||||
sampler=solver_sample,
|
||||
model=get_model(self.diffusion_model),
|
||||
model_kwargs={"cond": ctx, "guidance": guide_scale},
|
||||
steps=sample_steps,
|
||||
show_progress=True,
|
||||
guide_scale=guide_scale,
|
||||
return_intermediate=None,
|
||||
reverse_scale=reverse_scale,
|
||||
x=x_start,
|
||||
**kwargs).float()
|
||||
latent = unpack_tensor_into_imagelist(latent, x_shapes)
|
||||
self.dynamic_unload(self.diffusion_model,
|
||||
'diffusion_model',
|
||||
skip_loaded=not self.use_dynamic_model)
|
||||
self.dynamic_load(self.first_stage_model, 'first_stage_model')
|
||||
x_samples = self.decode_first_stage(latent)
|
||||
self.dynamic_unload(self.first_stage_model,
|
||||
'first_stage_model',
|
||||
skip_loaded=not self.use_dynamic_model)
|
||||
return x_samples
|
||||
|
||||
|
||||
class ACEInference(DiffusionInference):
|
||||
def __init__(self, logger=None):
|
||||
if logger is None:
|
||||
logger = get_logger(name='scepter')
|
||||
self.logger = logger
|
||||
self.loaded_model = {}
|
||||
self.loaded_model_name = [
|
||||
'diffusion_model', 'first_stage_model', 'cond_stage_model'
|
||||
]
|
||||
|
||||
def init_from_cfg(self, cfg):
|
||||
self.name = cfg.NAME
|
||||
self.is_default = cfg.get('IS_DEFAULT', False)
|
||||
self.use_dynamic_model = cfg.get('USE_DYNAMIC_MODEL', True)
|
||||
module_paras = self.load_default(cfg.get('DEFAULT_PARAS', None))
|
||||
assert cfg.have('MODEL')
|
||||
|
||||
self.diffusion_model = self.infer_model(
|
||||
cfg.MODEL.DIFFUSION_MODEL, module_paras.get(
|
||||
'DIFFUSION_MODEL',
|
||||
None)) if cfg.MODEL.have('DIFFUSION_MODEL') else None
|
||||
self.first_stage_model = self.infer_model(
|
||||
cfg.MODEL.FIRST_STAGE_MODEL,
|
||||
module_paras.get(
|
||||
'FIRST_STAGE_MODEL',
|
||||
None)) if cfg.MODEL.have('FIRST_STAGE_MODEL') else None
|
||||
self.cond_stage_model = self.infer_model(
|
||||
cfg.MODEL.COND_STAGE_MODEL,
|
||||
module_paras.get(
|
||||
'COND_STAGE_MODEL',
|
||||
None)) if cfg.MODEL.have('COND_STAGE_MODEL') else None
|
||||
|
||||
self.refiner_model_cfg = cfg.get('REFINER_MODEL', None)
|
||||
# self.refiner_scale = cfg.get('REFINER_SCALE', 0.)
|
||||
# self.refiner_prompt = cfg.get('REFINER_PROMPT', "")
|
||||
self.ace_prompt = cfg.get("ACE_PROMPT", [])
|
||||
if self.refiner_model_cfg:
|
||||
self.refiner_model_cfg.USE_DYNAMIC_MODEL = self.use_dynamic_model
|
||||
self.refiner_module = RefinerInference(self.logger)
|
||||
self.refiner_module.init_from_cfg(self.refiner_model_cfg)
|
||||
else:
|
||||
self.refiner_module = None
|
||||
|
||||
self.diffusion = DIFFUSIONS.build(cfg.MODEL.DIFFUSION,
|
||||
logger=self.logger)
|
||||
|
||||
|
||||
self.interpolate_func = lambda x: (F.interpolate(
|
||||
x.unsqueeze(0),
|
||||
scale_factor=1 / self.size_factor,
|
||||
mode='nearest-exact') if x is not None else None)
|
||||
self.text_indentifers = cfg.MODEL.get('TEXT_IDENTIFIER', [])
|
||||
self.use_text_pos_embeddings = cfg.MODEL.get('USE_TEXT_POS_EMBEDDINGS',
|
||||
False)
|
||||
if self.use_text_pos_embeddings:
|
||||
self.text_position_embeddings = TextEmbedding(
|
||||
(10, 4096)).eval().requires_grad_(False).to(we.device_id)
|
||||
else:
|
||||
self.text_position_embeddings = None
|
||||
|
||||
self.max_seq_len = cfg.MODEL.DIFFUSION_MODEL.MAX_SEQ_LEN
|
||||
self.scale_factor = cfg.get('SCALE_FACTOR', 0.18215)
|
||||
self.size_factor = cfg.get('SIZE_FACTOR', 8)
|
||||
self.decoder_bias = cfg.get('DECODER_BIAS', 0)
|
||||
self.default_n_prompt = cfg.get('DEFAULT_N_PROMPT', '')
|
||||
if not self.use_dynamic_model:
|
||||
self.dynamic_load(self.first_stage_model, 'first_stage_model')
|
||||
self.dynamic_load(self.cond_stage_model, 'cond_stage_model')
|
||||
self.dynamic_load(self.diffusion_model, 'diffusion_model')
|
||||
|
||||
@torch.no_grad()
|
||||
def encode_first_stage(self, x, **kwargs):
|
||||
_, dtype = self.get_function_info(self.first_stage_model, 'encode')
|
||||
with torch.autocast('cuda',
|
||||
enabled=(dtype != 'float32'),
|
||||
dtype=getattr(torch, dtype)):
|
||||
z = [
|
||||
self.scale_factor * get_model(self.first_stage_model)._encode(
|
||||
i.unsqueeze(0).to(getattr(torch, dtype))) for i in x
|
||||
]
|
||||
return z
|
||||
|
||||
@torch.no_grad()
|
||||
def decode_first_stage(self, z):
|
||||
_, dtype = self.get_function_info(self.first_stage_model, 'decode')
|
||||
with torch.autocast('cuda',
|
||||
enabled=(dtype != 'float32'),
|
||||
dtype=getattr(torch, dtype)):
|
||||
x = [
|
||||
get_model(self.first_stage_model)._decode(
|
||||
1. / self.scale_factor * i.to(getattr(torch, dtype)))
|
||||
for i in z
|
||||
]
|
||||
return x
|
||||
|
||||
|
||||
|
||||
@torch.no_grad()
|
||||
def __call__(self,
|
||||
image=None,
|
||||
mask=None,
|
||||
prompt='',
|
||||
task=None,
|
||||
negative_prompt='',
|
||||
output_height=512,
|
||||
output_width=512,
|
||||
sampler='ddim',
|
||||
sample_steps=20,
|
||||
guide_scale=4.5,
|
||||
guide_rescale=0.5,
|
||||
seed=-1,
|
||||
history_io=None,
|
||||
tar_index=0,
|
||||
**kwargs):
|
||||
input_image, input_mask = image, mask
|
||||
g = torch.Generator(device=we.device_id)
|
||||
seed = seed if seed >= 0 else random.randint(0, 2**32 - 1)
|
||||
g.manual_seed(int(seed))
|
||||
if input_image is not None:
|
||||
# assert isinstance(input_image, list) and isinstance(input_mask, list)
|
||||
if task is None:
|
||||
task = [''] * len(input_image)
|
||||
if not isinstance(prompt, list):
|
||||
prompt = [prompt] * len(input_image)
|
||||
if history_io is not None and len(history_io) > 0:
|
||||
his_image, his_maks, his_prompt, his_task = history_io[
|
||||
'image'], history_io['mask'], history_io[
|
||||
'prompt'], history_io['task']
|
||||
assert len(his_image) == len(his_maks) == len(
|
||||
his_prompt) == len(his_task)
|
||||
input_image = his_image + input_image
|
||||
input_mask = his_maks + input_mask
|
||||
task = his_task + task
|
||||
prompt = his_prompt + [prompt[-1]]
|
||||
prompt = [
|
||||
pp.replace('{image}', f'{{image{i}}}') if i > 0 else pp
|
||||
for i, pp in enumerate(prompt)
|
||||
]
|
||||
|
||||
edit_image, edit_image_mask = process_edit_image(
|
||||
input_image, input_mask, task, max_seq_len=self.max_seq_len)
|
||||
|
||||
image, image_mask = edit_image[tar_index], edit_image_mask[
|
||||
tar_index]
|
||||
edit_image, edit_image_mask = [edit_image], [edit_image_mask]
|
||||
|
||||
else:
|
||||
edit_image = edit_image_mask = [[]]
|
||||
image = torch.zeros(
|
||||
size=[3, int(output_height),
|
||||
int(output_width)])
|
||||
image_mask = torch.ones(
|
||||
size=[1, int(output_height),
|
||||
int(output_width)])
|
||||
if not isinstance(prompt, list):
|
||||
prompt = [prompt]
|
||||
|
||||
image, image_mask, prompt = [image], [image_mask], [prompt]
|
||||
assert check_list_of_list(prompt) and check_list_of_list(
|
||||
edit_image) and check_list_of_list(edit_image_mask)
|
||||
# Assign Negative Prompt
|
||||
if isinstance(negative_prompt, list):
|
||||
negative_prompt = negative_prompt[0]
|
||||
assert isinstance(negative_prompt, str)
|
||||
|
||||
n_prompt = copy.deepcopy(prompt)
|
||||
for nn_p_id, nn_p in enumerate(n_prompt):
|
||||
assert isinstance(nn_p, list)
|
||||
n_prompt[nn_p_id][-1] = negative_prompt
|
||||
|
||||
is_txt_image = sum([len(e_i) for e_i in edit_image]) < 1
|
||||
image = to_device(image)
|
||||
|
||||
refiner_scale = kwargs.pop("refiner_scale", 0.0)
|
||||
refiner_prompt = kwargs.pop("refiner_prompt", "")
|
||||
use_ace = kwargs.pop("use_ace", True)
|
||||
# <= 0 use ace as the txt2img generator.
|
||||
if use_ace and (not is_txt_image or refiner_scale <= 0):
|
||||
ctx, null_ctx = {}, {}
|
||||
# Get Noise Shape
|
||||
self.dynamic_load(self.first_stage_model, 'first_stage_model')
|
||||
x = self.encode_first_stage(image)
|
||||
self.dynamic_unload(self.first_stage_model,
|
||||
'first_stage_model',
|
||||
skip_loaded=not self.use_dynamic_model)
|
||||
noise = [
|
||||
torch.empty(*i.shape, device=we.device_id).normal_(generator=g)
|
||||
for i in x
|
||||
]
|
||||
noise, x_shapes = pack_imagelist_into_tensor(noise)
|
||||
ctx['x_shapes'] = null_ctx['x_shapes'] = x_shapes
|
||||
|
||||
image_mask = to_device(image_mask, strict=False)
|
||||
cond_mask = [self.interpolate_func(i) for i in image_mask
|
||||
] if image_mask is not None else [None] * len(image)
|
||||
ctx['x_mask'] = null_ctx['x_mask'] = cond_mask
|
||||
|
||||
# Encode Prompt
|
||||
self.dynamic_load(self.cond_stage_model, 'cond_stage_model')
|
||||
function_name, dtype = self.get_function_info(self.cond_stage_model)
|
||||
cont, cont_mask = getattr(get_model(self.cond_stage_model),
|
||||
function_name)(prompt)
|
||||
cont, cont_mask = self.cond_stage_embeddings(prompt, edit_image, cont,
|
||||
cont_mask)
|
||||
null_cont, null_cont_mask = getattr(get_model(self.cond_stage_model),
|
||||
function_name)(n_prompt)
|
||||
null_cont, null_cont_mask = self.cond_stage_embeddings(
|
||||
prompt, edit_image, null_cont, null_cont_mask)
|
||||
self.dynamic_unload(self.cond_stage_model,
|
||||
'cond_stage_model',
|
||||
skip_loaded=not self.use_dynamic_model)
|
||||
ctx['crossattn'] = cont
|
||||
null_ctx['crossattn'] = null_cont
|
||||
|
||||
# Encode Edit Images
|
||||
self.dynamic_load(self.first_stage_model, 'first_stage_model')
|
||||
edit_image = [to_device(i, strict=False) for i in edit_image]
|
||||
edit_image_mask = [to_device(i, strict=False) for i in edit_image_mask]
|
||||
e_img, e_mask = [], []
|
||||
for u, m in zip(edit_image, edit_image_mask):
|
||||
if u is None:
|
||||
continue
|
||||
if m is None:
|
||||
m = [None] * len(u)
|
||||
e_img.append(self.encode_first_stage(u, **kwargs))
|
||||
e_mask.append([self.interpolate_func(i) for i in m])
|
||||
self.dynamic_unload(self.first_stage_model,
|
||||
'first_stage_model',
|
||||
skip_loaded=not self.use_dynamic_model)
|
||||
null_ctx['edit'] = ctx['edit'] = e_img
|
||||
null_ctx['edit_mask'] = ctx['edit_mask'] = e_mask
|
||||
|
||||
# Diffusion Process
|
||||
self.dynamic_load(self.diffusion_model, 'diffusion_model')
|
||||
function_name, dtype = self.get_function_info(self.diffusion_model)
|
||||
with torch.autocast('cuda',
|
||||
enabled=dtype in ('float16', 'bfloat16'),
|
||||
dtype=getattr(torch, dtype)):
|
||||
latent = self.diffusion.sample(
|
||||
noise=noise,
|
||||
sampler=sampler,
|
||||
model=get_model(self.diffusion_model),
|
||||
model_kwargs=[{
|
||||
'cond':
|
||||
ctx,
|
||||
'mask':
|
||||
cont_mask,
|
||||
'text_position_embeddings':
|
||||
self.text_position_embeddings.pos if hasattr(
|
||||
self.text_position_embeddings, 'pos') else None
|
||||
}, {
|
||||
'cond':
|
||||
null_ctx,
|
||||
'mask':
|
||||
null_cont_mask,
|
||||
'text_position_embeddings':
|
||||
self.text_position_embeddings.pos if hasattr(
|
||||
self.text_position_embeddings, 'pos') else None
|
||||
}] if guide_scale is not None and guide_scale > 1 else {
|
||||
'cond':
|
||||
null_ctx,
|
||||
'mask':
|
||||
cont_mask,
|
||||
'text_position_embeddings':
|
||||
self.text_position_embeddings.pos if hasattr(
|
||||
self.text_position_embeddings, 'pos') else None
|
||||
},
|
||||
steps=sample_steps,
|
||||
show_progress=True,
|
||||
seed=seed,
|
||||
guide_scale=guide_scale,
|
||||
guide_rescale=guide_rescale,
|
||||
return_intermediate=None,
|
||||
**kwargs)
|
||||
self.dynamic_unload(self.diffusion_model,
|
||||
'diffusion_model',
|
||||
skip_loaded=not self.use_dynamic_model)
|
||||
|
||||
# Decode to Pixel Space
|
||||
self.dynamic_load(self.first_stage_model, 'first_stage_model')
|
||||
samples = unpack_tensor_into_imagelist(latent, x_shapes)
|
||||
x_samples = self.decode_first_stage(samples)
|
||||
self.dynamic_unload(self.first_stage_model,
|
||||
'first_stage_model',
|
||||
skip_loaded=not self.use_dynamic_model)
|
||||
x_samples = [x.squeeze(0) for x in x_samples]
|
||||
else:
|
||||
x_samples = image
|
||||
if self.refiner_module and refiner_scale > 0:
|
||||
if is_txt_image:
|
||||
random.shuffle(self.ace_prompt)
|
||||
input_refine_prompt = [self.ace_prompt[0] + refiner_prompt if p[0] == "" else p[0] for p in prompt]
|
||||
input_refine_scale = -1.
|
||||
else:
|
||||
input_refine_prompt = [p[0].replace("{image}", "") + " " + refiner_prompt for p in prompt]
|
||||
input_refine_scale = refiner_scale
|
||||
print(input_refine_prompt)
|
||||
|
||||
x_samples = self.refiner_module.refine(x_samples,
|
||||
reverse_scale = input_refine_scale,
|
||||
prompt= input_refine_prompt,
|
||||
seed=seed,
|
||||
use_dynamic_model=self.use_dynamic_model)
|
||||
|
||||
imgs = [
|
||||
torch.clamp((x_i.float() + 1.0) / 2.0 + self.decoder_bias / 255,
|
||||
min=0.0,
|
||||
max=1.0).squeeze(0).permute(1, 2, 0).cpu().numpy()
|
||||
for x_i in x_samples
|
||||
]
|
||||
imgs = [Image.fromarray((img * 255).astype(np.uint8)) for img in imgs]
|
||||
return imgs
|
||||
|
||||
def cond_stage_embeddings(self, prompt, edit_image, cont, cont_mask):
|
||||
if self.use_text_pos_embeddings and not torch.sum(
|
||||
self.text_position_embeddings.pos) > 0:
|
||||
identifier_cont, _ = getattr(get_model(self.cond_stage_model),
|
||||
'encode')(self.text_indentifers,
|
||||
return_mask=True)
|
||||
self.text_position_embeddings.load_state_dict(
|
||||
{'pos': identifier_cont[:, 0, :]})
|
||||
|
||||
cont_, cont_mask_ = [], []
|
||||
for pp, edit, c, cm in zip(prompt, edit_image, cont, cont_mask):
|
||||
if isinstance(pp, list):
|
||||
cont_.append([c[-1], *c] if len(edit) > 0 else [c[-1]])
|
||||
cont_mask_.append([cm[-1], *cm] if len(edit) > 0 else [cm[-1]])
|
||||
else:
|
||||
raise NotImplementedError
|
||||
|
||||
return cont_, cont_mask_
|
||||
@@ -0,0 +1,183 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
|
||||
import copy
|
||||
import numpy as np
|
||||
from typing import Tuple
|
||||
import random
|
||||
|
||||
import torch
|
||||
|
||||
from scepter.modules.utils.file_system import FS
|
||||
from scepter.modules.utils.distribute import we
|
||||
from scepter.modules.model.backbone.cogvideox.utils import get_3d_rotary_pos_embed, get_resize_crop_region_for_grid
|
||||
from .diffusion_inference import DiffusionInference, get_model
|
||||
from .tuner_inference import TunerInference
|
||||
|
||||
class CogVideoXInference(DiffusionInference):
|
||||
def __init__(self, logger=None):
|
||||
self.logger = logger
|
||||
self.is_redefine_paras = False
|
||||
self.loaded_model = {}
|
||||
self.loaded_model_name = [
|
||||
'diffusion_model', 'first_stage_model', 'cond_stage_model'
|
||||
]
|
||||
self.tuner_infer = TunerInference(self.logger)
|
||||
|
||||
@torch.no_grad()
|
||||
def decode_first_stage(self, latents):
|
||||
_, dtype = self.get_function_info(self.first_stage_model, 'decode')
|
||||
with torch.autocast('cuda',
|
||||
enabled=dtype in ('bfloat16'),
|
||||
dtype=getattr(torch, dtype)):
|
||||
latents = latents.permute(0, 2, 1, 3, 4)
|
||||
latents = 1 / self.first_stage_model['paras']['scaling_factor_image'] * latents
|
||||
frames = get_model(self.first_stage_model).decode(latents)
|
||||
return frames
|
||||
|
||||
def _prepare_rotary_positional_embeddings(
|
||||
self,
|
||||
height: int,
|
||||
width: int,
|
||||
num_frames: int,
|
||||
device: torch.device,
|
||||
) -> Tuple[torch.Tensor, torch.Tensor]:
|
||||
|
||||
grid_height = height // (self.diffusion_model['paras']['scale_factor_spatial'] * self.diffusion_model['paras']['patch_size'])
|
||||
grid_width = width // (self.diffusion_model['paras']['scale_factor_spatial'] * self.diffusion_model['paras']['patch_size'])
|
||||
base_size_width = self.diffusion_model['paras']['sample_width'] // (self.diffusion_model['paras']['scale_factor_spatial'] * self.diffusion_model['paras']['patch_size'])
|
||||
base_size_height = self.diffusion_model['paras']['sample_height'] // (self.diffusion_model['paras']['scale_factor_spatial'] * self.diffusion_model['paras']['patch_size'])
|
||||
|
||||
grid_crops_coords = get_resize_crop_region_for_grid(
|
||||
(grid_height, grid_width), base_size_width, base_size_height
|
||||
)
|
||||
freqs_cos, freqs_sin = get_3d_rotary_pos_embed(
|
||||
embed_dim=self.diffusion_model['paras']['attention_head_dim'],
|
||||
crops_coords=grid_crops_coords,
|
||||
grid_size=(grid_height, grid_width),
|
||||
temporal_size=num_frames,
|
||||
)
|
||||
|
||||
freqs_cos = freqs_cos.to(device=device)
|
||||
freqs_sin = freqs_sin.to(device=device)
|
||||
return freqs_cos, freqs_sin
|
||||
|
||||
@torch.no_grad()
|
||||
def __call__(self,
|
||||
input,
|
||||
num_samples=1,
|
||||
cat_uc=True,
|
||||
tuner_model=None,
|
||||
**kwargs):
|
||||
value_input = copy.deepcopy(self.input)
|
||||
value_input.update(input)
|
||||
print(value_input)
|
||||
height, width = value_input['target_size_as_tuple']
|
||||
value_output = copy.deepcopy(self.output)
|
||||
|
||||
# register tuner
|
||||
if tuner_model is not None and tuner_model != '' and len(
|
||||
tuner_model) > 0:
|
||||
if not isinstance(tuner_model, list):
|
||||
tuner_model = [tuner_model]
|
||||
self.dynamic_load(self.diffusion_model, 'diffusion_model')
|
||||
self.tuner_infer.register_tuner(tuner_model, self.diffusion_model,
|
||||
cond_stage_model=None)
|
||||
self.dynamic_unload(self.diffusion_model,
|
||||
'diffusion_model',
|
||||
skip_loaded=True)
|
||||
|
||||
# cond stage
|
||||
self.dynamic_load(self.cond_stage_model, 'cond_stage_model')
|
||||
function_name, dtype = self.get_function_info(self.cond_stage_model)
|
||||
with torch.autocast(device_type='cuda', enabled=True, dtype=torch.bfloat16):
|
||||
cont = getattr(get_model(self.cond_stage_model),
|
||||
function_name)(value_input['prompt'], return_mask=False, use_mask=False)
|
||||
null_cont = getattr(get_model(self.cond_stage_model),
|
||||
function_name)(value_input['negative_prompt'] * num_samples, return_mask=False, use_mask=False)
|
||||
self.dynamic_unload(self.cond_stage_model,
|
||||
'cond_stage_model',
|
||||
skip_loaded=True)
|
||||
|
||||
# get noise
|
||||
seed = kwargs.pop('seed', -1)
|
||||
seed = seed if seed >= 0 else random.randint(0, 2**32 - 1)
|
||||
generator = torch.Generator().manual_seed(seed)
|
||||
if 'seed' in value_output:
|
||||
value_output['seed'] = seed
|
||||
for sample_id in range(num_samples):
|
||||
if self.diffusion_model is not None:
|
||||
noise_shape = (1,
|
||||
(value_input['num_frames'] - 1) // self.diffusion_model['paras']['scale_factor_temporal'] + 1,
|
||||
self.diffusion_model['paras']['latent_channels'],
|
||||
height // self.diffusion_model['paras']['scale_factor_spatial'],
|
||||
width // self.diffusion_model['paras']['scale_factor_spatial']
|
||||
)
|
||||
noise = torch.randn(noise_shape, generator=generator, dtype=getattr(torch, dtype), device='cpu').to(we.device_id)
|
||||
|
||||
self.dynamic_load(self.diffusion_model, 'diffusion_model')
|
||||
|
||||
image_rotary_emb = (
|
||||
self._prepare_rotary_positional_embeddings(height, width, noise.size(1), we.device_id)
|
||||
if self.diffusion_model['paras']['use_rotary_positional_embeddings']
|
||||
else None
|
||||
)
|
||||
function_name, dtype = self.get_function_info(
|
||||
self.diffusion_model)
|
||||
|
||||
with torch.autocast('cuda',
|
||||
enabled=dtype in ('float16', 'bfloat16'),
|
||||
dtype=getattr(torch, dtype)):
|
||||
solver_sample = value_input.get('sample', 'ddim')
|
||||
sample_steps = value_input.get('sample_steps', 50)
|
||||
guide_scale = value_input.get('guide_scale', 7.5)
|
||||
guide_rescale = value_input.get('guide_rescale', 0.5)
|
||||
|
||||
latent = self.diffusion.sample(noise=noise,
|
||||
sampler=solver_sample,
|
||||
model=get_model(self.diffusion_model),
|
||||
model_kwargs=[{
|
||||
'cond': cont,
|
||||
'image_latent': None,
|
||||
'image_rotary_emb': image_rotary_emb,
|
||||
}, {
|
||||
'cond': null_cont,
|
||||
'image_latent': None,
|
||||
'image_rotary_emb': image_rotary_emb,
|
||||
}],
|
||||
steps=sample_steps,
|
||||
show_progress=True,
|
||||
guide_scale=guide_scale,
|
||||
guide_rescale=guide_rescale,
|
||||
return_intermediate=None,
|
||||
**kwargs).float()
|
||||
self.dynamic_unload(self.diffusion_model,
|
||||
'diffusion_model',
|
||||
skip_loaded=True)
|
||||
self.dynamic_load(self.first_stage_model, 'first_stage_model')
|
||||
x_samples = self.decode_first_stage(latent).float() # [B, C, F, H, W]
|
||||
self.dynamic_unload(self.first_stage_model,
|
||||
'first_stage_model',
|
||||
skip_loaded=True)
|
||||
|
||||
x_frames = torch.clamp(x_samples / 2 + 0.5, min=0.0, max=1.0)
|
||||
if 'videos' in value_output:
|
||||
if value_output['videos'] is None or (
|
||||
isinstance(value_output['videos'], list)
|
||||
and len(value_output['videos']) < 1):
|
||||
value_output['videos'] = []
|
||||
value_output['videos'].append(x_frames)
|
||||
|
||||
for k, v in value_output.items():
|
||||
if isinstance(v, list):
|
||||
value_output[k] = torch.cat(v, dim=0)
|
||||
if isinstance(v, torch.Tensor):
|
||||
value_output[k] = v.cpu()
|
||||
|
||||
# unregister tuner
|
||||
if tuner_model is not None and tuner_model != '' and len(
|
||||
tuner_model) > 0:
|
||||
self.tuner_infer.unregister_tuner(tuner_model,
|
||||
self.diffusion_model,
|
||||
cond_stage_model=None)
|
||||
return value_output
|
||||
@@ -13,12 +13,6 @@ from scepter.modules.utils.config import Config
|
||||
from scepter.modules.utils.distribute import we
|
||||
from scepter.modules.utils.file_system import FS
|
||||
|
||||
try:
|
||||
from swift import SwiftModel
|
||||
except Exception:
|
||||
warnings.warn('Import swift failed, please check it.')
|
||||
|
||||
|
||||
class ControlInference():
|
||||
def __init__(self, logger=None):
|
||||
self.logger = logger
|
||||
@@ -26,6 +20,11 @@ class ControlInference():
|
||||
|
||||
# @classmethod
|
||||
def unregister_controllers(self, control_model_ins, diffusion_model):
|
||||
try:
|
||||
from swift import SwiftModel
|
||||
except Exception:
|
||||
warnings.warn('Import swift failed, please check it.')
|
||||
|
||||
self.logger.info('Unloading control model')
|
||||
if isinstance(diffusion_model['model'], SwiftModel):
|
||||
if (hasattr(diffusion_model['model'].base_model, 'control_blocks')
|
||||
@@ -42,6 +41,11 @@ class ControlInference():
|
||||
|
||||
# @classmethod
|
||||
def register_controllers(self, control_model_ins, diffusion_model):
|
||||
try:
|
||||
from swift import SwiftModel
|
||||
except Exception:
|
||||
warnings.warn('Import swift failed, please check it.')
|
||||
|
||||
self.logger.info('Loading control model')
|
||||
if control_model_ins is None or control_model_ins == '':
|
||||
self.unregister_controllers(control_model_ins, diffusion_model)
|
||||
|
||||
@@ -11,9 +11,10 @@ from PIL.Image import Image
|
||||
from scepter.modules.model.network.diffusion.diffusion import GaussianDiffusion
|
||||
from scepter.modules.model.network.diffusion.schedules import noise_schedule
|
||||
from scepter.modules.model.registry import (BACKBONES, EMBEDDERS, MODELS,
|
||||
TOKENIZERS)
|
||||
TOKENIZERS, DIFFUSIONS)
|
||||
from scepter.modules.utils.distribute import we
|
||||
from scepter.modules.utils.file_system import FS
|
||||
from scepter.modules.utils.config import Config
|
||||
from scepter.studio.utils.env import get_available_memory
|
||||
|
||||
from .control_inference import ControlInference
|
||||
@@ -49,7 +50,10 @@ class DiffusionInference():
|
||||
assert cfg.have('MODEL')
|
||||
if self.is_redefine_paras:
|
||||
cfg.MODEL = self.redefine_paras(cfg.MODEL)
|
||||
self.diffusion = self.load_schedule(cfg.MODEL.SCHEDULE)
|
||||
if 'DIFFUSION' in cfg.MODEL:
|
||||
self.diffusion = DIFFUSIONS.build(cfg.MODEL.DIFFUSION, logger=self.logger)
|
||||
else:
|
||||
self.diffusion = self.load_schedule(cfg.MODEL.SCHEDULE)
|
||||
self.diffusion_model = self.infer_model(
|
||||
cfg.MODEL.DIFFUSION_MODEL, module_paras.get(
|
||||
'DIFFUSION_MODEL',
|
||||
@@ -84,14 +88,16 @@ class DiffusionInference():
|
||||
|
||||
def redefine_paras(self, cfg):
|
||||
if cfg.get('PRETRAINED_MODEL', None):
|
||||
assert FS.isfile(cfg.PRETRAINED_MODEL)
|
||||
with FS.get_from(cfg.PRETRAINED_MODEL,
|
||||
wait_finish=True) as local_path:
|
||||
if local_path.endswith('safetensors'):
|
||||
from safetensors.torch import load_file as load_safetensors
|
||||
sd = load_safetensors(local_path)
|
||||
else:
|
||||
sd = torch.load(local_path, map_location='cpu')
|
||||
if 'weights_only' in torch.load.__code__.co_varnames:
|
||||
sd = torch.load(local_path, map_location='cpu', weights_only=True)
|
||||
else:
|
||||
sd = torch.load(local_path, map_location='cpu', weights_only=True)
|
||||
first_stage_model_path = os.path.join(
|
||||
os.path.dirname(local_path), 'first_stage_model.pth')
|
||||
cond_stage_model_path = os.path.join(
|
||||
@@ -197,7 +203,7 @@ class DiffusionInference():
|
||||
from safetensors.torch import load_file as load_safetensors
|
||||
sd = load_safetensors(path)
|
||||
else:
|
||||
sd = torch.load(path, map_location='cpu')
|
||||
sd = torch.load(path, map_location='cpu', weights_only=True)
|
||||
|
||||
new_sd = OrderedDict()
|
||||
for k, v in sd.items():
|
||||
@@ -224,16 +230,22 @@ class DiffusionInference():
|
||||
|
||||
def load(self, module):
|
||||
if module['device'] == 'offline':
|
||||
if module['cfg'].NAME in MODELS.class_map:
|
||||
from scepter.modules.utils.import_utils import LazyImportModule
|
||||
if (LazyImportModule.get_module_type(('MODELS', module['cfg'].NAME)) or
|
||||
module['cfg'].NAME in MODELS.class_map):
|
||||
model = MODELS.build(module['cfg'], logger=self.logger).eval()
|
||||
elif module['cfg'].NAME in BACKBONES.class_map:
|
||||
elif (LazyImportModule.get_module_type(('BACKBONES', module['cfg'].NAME)) or
|
||||
module['cfg'].NAME in BACKBONES.class_map):
|
||||
model = BACKBONES.build(module['cfg'],
|
||||
logger=self.logger).eval()
|
||||
elif module['cfg'].NAME in EMBEDDERS.class_map:
|
||||
elif (LazyImportModule.get_module_type(('EMBEDDERS', module['cfg'].NAME)) or
|
||||
module['cfg'].NAME in EMBEDDERS.class_map):
|
||||
model = EMBEDDERS.build(module['cfg'],
|
||||
logger=self.logger).eval()
|
||||
else:
|
||||
raise NotImplementedError
|
||||
if 'DTYPE' in module['cfg'] and module['cfg']['DTYPE'] is not None:
|
||||
model = model.to(getattr(torch, module['cfg'].DTYPE))
|
||||
if module['cfg'].get('RELOAD_MODEL', None):
|
||||
self.init_from_ckpt(module['cfg'].RELOAD_MODEL, model)
|
||||
module['model'] = model
|
||||
@@ -262,8 +274,9 @@ class DiffusionInference():
|
||||
module['device'] = 'cpu'
|
||||
else:
|
||||
module['device'] = 'offline'
|
||||
torch.cuda.empty_cache()
|
||||
torch.cuda.ipc_collect()
|
||||
if torch.cuda.is_available():
|
||||
torch.cuda.empty_cache()
|
||||
torch.cuda.ipc_collect()
|
||||
return module
|
||||
|
||||
def dynamic_load(self, module=None, name=''):
|
||||
@@ -311,7 +324,8 @@ class DiffusionInference():
|
||||
module_paras = {}
|
||||
if cfg is not None:
|
||||
self.paras = cfg.PARAS
|
||||
self.input = {k.lower(): v for k, v in cfg.INPUT.items()}
|
||||
self.input_cfg = {k.lower(): v for k, v in cfg.INPUT.items()}
|
||||
self.input = {k.lower(): dict(v).get('DEFAULT', None) if isinstance(v, (dict, OrderedDict, Config)) else v for k, v in cfg.INPUT.items()}
|
||||
self.output = {k.lower(): v for k, v in cfg.OUTPUT.items()}
|
||||
module_paras = cfg.MODULES_PARAS
|
||||
return module_paras
|
||||
|
||||
@@ -0,0 +1,216 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
import copy
|
||||
import math
|
||||
import random
|
||||
import torch
|
||||
from scepter.modules.utils.distribute import we
|
||||
from .control_inference import ControlInference
|
||||
from .diffusion_inference import DiffusionInference, get_model
|
||||
from .tuner_inference import TunerInference
|
||||
from scepter.modules.model.registry import DIFFUSIONS, TOKENIZERS
|
||||
|
||||
|
||||
class FluxInference(DiffusionInference):
|
||||
def __init__(self, logger=None):
|
||||
self.logger = logger
|
||||
self.is_redefine_paras = False
|
||||
self.loaded_model = {}
|
||||
self.loaded_model_name = [
|
||||
'diffusion_model', 'first_stage_model', 'cond_stage_model'
|
||||
]
|
||||
self.tuner_infer = TunerInference(self.logger)
|
||||
self.control_infer = ControlInference(self.logger)
|
||||
|
||||
def init_from_cfg(self, cfg):
|
||||
self.name = cfg.NAME
|
||||
self.is_default = cfg.get('IS_DEFAULT', False)
|
||||
module_paras = self.load_default(cfg.get('DEFAULT_PARAS', None))
|
||||
assert cfg.have('MODEL')
|
||||
if self.is_redefine_paras:
|
||||
cfg.MODEL = self.redefine_paras(cfg.MODEL)
|
||||
self.diffusion_model = self.infer_model(
|
||||
cfg.MODEL.DIFFUSION_MODEL, module_paras.get(
|
||||
'DIFFUSION_MODEL',
|
||||
None)) if cfg.MODEL.have('DIFFUSION_MODEL') else None
|
||||
self.first_stage_model = self.infer_model(
|
||||
cfg.MODEL.FIRST_STAGE_MODEL,
|
||||
module_paras.get(
|
||||
'FIRST_STAGE_MODEL',
|
||||
None)) if cfg.MODEL.have('FIRST_STAGE_MODEL') else None
|
||||
self.cond_stage_model = self.infer_model(
|
||||
cfg.MODEL.COND_STAGE_MODEL,
|
||||
module_paras.get(
|
||||
'COND_STAGE_MODEL',
|
||||
None)) if cfg.MODEL.have('COND_STAGE_MODEL') else None
|
||||
self.refiner_cond_model = self.infer_model(
|
||||
cfg.MODEL.REFINER_COND_MODEL,
|
||||
module_paras.get(
|
||||
'REFINER_COND_MODEL',
|
||||
None)) if cfg.MODEL.have('REFINER_COND_MODEL') else None
|
||||
self.refiner_diffusion_model = self.infer_model(
|
||||
cfg.MODEL.REFINER_MODEL, module_paras.get(
|
||||
'REFINER_MODEL',
|
||||
None)) if cfg.MODEL.have('REFINER_MODEL') else None
|
||||
self.tokenizer = TOKENIZERS.build(
|
||||
cfg.MODEL.TOKENIZER,
|
||||
logger=self.logger) if cfg.MODEL.have('TOKENIZER') else None
|
||||
|
||||
if self.tokenizer is not None:
|
||||
self.cond_stage_model['cfg'].KWARGS = {
|
||||
'vocab_size': self.tokenizer.vocab_size
|
||||
}
|
||||
self.diffusion = DIFFUSIONS.build(cfg.MODEL.DIFFUSION, logger=self.logger) \
|
||||
if cfg.MODEL.have('DIFFUSION') else None
|
||||
assert self.diffusion is not None
|
||||
|
||||
@torch.no_grad()
|
||||
def encode_first_stage(self, x, **kwargs):
|
||||
_, dtype = self.get_function_info(self.first_stage_model, 'encode')
|
||||
with torch.autocast('cuda',
|
||||
enabled= dtype in ('float16', 'bfloat16'),
|
||||
dtype=getattr(torch, dtype)):
|
||||
z = get_model(self.first_stage_model).encode(x)
|
||||
if isinstance(z, (tuple, list)):
|
||||
z = z[0]
|
||||
return z
|
||||
|
||||
@torch.no_grad()
|
||||
def decode_first_stage(self, z):
|
||||
_, dtype = self.get_function_info(self.first_stage_model, 'decode')
|
||||
with torch.autocast('cuda',
|
||||
enabled=dtype in ('float16', 'bfloat16'),
|
||||
dtype=getattr(torch, dtype)):
|
||||
return get_model(self.first_stage_model).decode(z)
|
||||
|
||||
@torch.no_grad()
|
||||
def __call__(self,
|
||||
input,
|
||||
num_samples=1,
|
||||
cat_uc=True,
|
||||
tuner_model=None,
|
||||
control_model=None,
|
||||
**kwargs):
|
||||
|
||||
value_input = copy.deepcopy(self.input)
|
||||
value_input.update(input)
|
||||
print(value_input)
|
||||
height, width = value_input['target_size_as_tuple']
|
||||
value_output = copy.deepcopy(self.output)
|
||||
# register tuner
|
||||
if tuner_model is not None and tuner_model != '' and len(
|
||||
tuner_model) > 0:
|
||||
if not isinstance(tuner_model, list):
|
||||
tuner_model = [tuner_model]
|
||||
self.dynamic_load(self.diffusion_model, 'diffusion_model')
|
||||
self.dynamic_load(self.cond_stage_model, 'cond_stage_model')
|
||||
self.tuner_infer.register_tuner(tuner_model, self.diffusion_model,
|
||||
self.cond_stage_model)
|
||||
self.dynamic_unload(self.diffusion_model,
|
||||
'diffusion_model',
|
||||
skip_loaded=True)
|
||||
self.dynamic_unload(self.cond_stage_model,
|
||||
'cond_stage_model',
|
||||
skip_loaded=True)
|
||||
|
||||
# cond stage
|
||||
self.dynamic_load(self.cond_stage_model, 'cond_stage_model')
|
||||
function_name, dtype = self.get_function_info(self.cond_stage_model)
|
||||
with torch.autocast('cuda',
|
||||
enabled=dtype == 'float16',
|
||||
dtype=getattr(torch, dtype)):
|
||||
ctx = getattr(get_model(self.cond_stage_model),
|
||||
function_name)(value_input['prompt'])
|
||||
self.dynamic_unload(self.cond_stage_model,
|
||||
'cond_stage_model',
|
||||
skip_loaded=True)
|
||||
|
||||
# get noise
|
||||
seed = kwargs.pop('seed', -1)
|
||||
g = torch.Generator(device=we.device_id)
|
||||
seed = seed if seed >= 0 else random.randint(0, 2**32 - 1)
|
||||
g.manual_seed(seed)
|
||||
if 'seed' in value_output:
|
||||
value_output['seed'] = seed
|
||||
for sample_id in range(num_samples):
|
||||
if self.diffusion_model is not None:
|
||||
noise = torch.randn(
|
||||
num_samples,
|
||||
16,
|
||||
# allow for packing
|
||||
2 * math.ceil(height / 16),
|
||||
2 * math.ceil(width / 16),
|
||||
device=we.device_id,
|
||||
dtype=getattr(torch, dtype),
|
||||
generator=torch.Generator(device=we.device_id).manual_seed(seed),
|
||||
)
|
||||
self.dynamic_load(self.diffusion_model, 'diffusion_model')
|
||||
# UNet use input n_prompt
|
||||
function_name, dtype = self.get_function_info(
|
||||
self.diffusion_model)
|
||||
with torch.autocast('cuda',
|
||||
enabled= dtype in ('float16', 'bfloat16'),
|
||||
dtype=getattr(torch, dtype)):
|
||||
solver_sample = value_input.get('sample', 'flow_euler')
|
||||
sample_steps = value_input.get('sample_steps', 20)
|
||||
guide_scale = value_input.get('guide_scale', 3.5)
|
||||
if guide_scale is not None:
|
||||
guide_scale = torch.full((noise.shape[0],), guide_scale, device=noise.device,
|
||||
dtype=noise.dtype)
|
||||
else:
|
||||
guide_scale = None
|
||||
|
||||
latent = self.diffusion.sample(
|
||||
noise=noise,
|
||||
sampler=solver_sample,
|
||||
model=get_model(self.diffusion_model),
|
||||
model_kwargs={"cond": ctx, "guidance": guide_scale},
|
||||
steps=sample_steps,
|
||||
show_progress=True,
|
||||
guide_scale=guide_scale,
|
||||
return_intermediate=None,
|
||||
**kwargs)
|
||||
|
||||
self.dynamic_unload(self.diffusion_model,
|
||||
'diffusion_model',
|
||||
skip_loaded=True)
|
||||
|
||||
if 'latent' in value_output:
|
||||
if value_output['latent'] is None or (
|
||||
isinstance(value_output['latent'], list)
|
||||
and len(value_output['latent']) < 1):
|
||||
value_output['latent'] = []
|
||||
value_output['latent'].append(latent)
|
||||
|
||||
self.dynamic_load(self.first_stage_model, 'first_stage_model')
|
||||
x_samples = self.decode_first_stage(latent).float()
|
||||
self.dynamic_unload(self.first_stage_model,
|
||||
'first_stage_model',
|
||||
skip_loaded=True)
|
||||
images = torch.clamp((x_samples + 1.0) / 2.0, min=0.0, max=1.0)
|
||||
if 'images' in value_output:
|
||||
if value_output['images'] is None or (
|
||||
isinstance(value_output['images'], list)
|
||||
and len(value_output['images']) < 1):
|
||||
value_output['images'] = []
|
||||
value_output['images'].append(images)
|
||||
|
||||
for k, v in value_output.items():
|
||||
if isinstance(v, list):
|
||||
value_output[k] = torch.cat(v, dim=0)
|
||||
if isinstance(v, torch.Tensor):
|
||||
value_output[k] = v.cpu()
|
||||
|
||||
# unregister tuner
|
||||
if tuner_model is not None and tuner_model != '' and len(
|
||||
tuner_model) > 0:
|
||||
self.tuner_infer.unregister_tuner(tuner_model,
|
||||
self.diffusion_model,
|
||||
self.cond_stage_model)
|
||||
|
||||
# unregister control
|
||||
if control_model is not None and control_model != '':
|
||||
self.control_infer.unregister_controllers(control_model,
|
||||
self.diffusion_model)
|
||||
|
||||
return value_output
|
||||
@@ -40,8 +40,10 @@ class LargenInference(DiffusionInference):
|
||||
from safetensors.torch import load_file as load_safetensors
|
||||
sd = load_safetensors(local_path)
|
||||
else:
|
||||
sd = torch.load(local_path, map_location='cpu')
|
||||
|
||||
if 'weights_only' in torch.load.__code__.co_varnames:
|
||||
sd = torch.load(local_path, map_location='cpu', weights_only=True)
|
||||
else:
|
||||
sd = torch.load(local_path, map_location='cpu', weights_only=True)
|
||||
if 'model' in sd:
|
||||
sd = sd['model']
|
||||
|
||||
|
||||
@@ -1,20 +1,12 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
import copy
|
||||
import os.path
|
||||
import random
|
||||
from collections import OrderedDict
|
||||
|
||||
import torch
|
||||
import torch.nn.functional as F
|
||||
from PIL.Image import Image
|
||||
|
||||
from scepter.modules.model.network.diffusion.diffusion import GaussianDiffusion
|
||||
from scepter.modules.model.network.diffusion.schedules import noise_schedule
|
||||
from scepter.modules.model.registry import (BACKBONES, EMBEDDERS, MODELS,
|
||||
TOKENIZERS)
|
||||
from scepter.modules.utils.distribute import we
|
||||
from scepter.modules.utils.file_system import FS
|
||||
from scepter.studio.utils.env import get_available_memory
|
||||
|
||||
from .control_inference import ControlInference
|
||||
from .diffusion_inference import DiffusionInference, get_model
|
||||
@@ -84,9 +76,11 @@ class PixArtInference(DiffusionInference):
|
||||
function_name)(value_input['prompt'],
|
||||
return_mask=True)
|
||||
context['crossattn'] = cont.float()
|
||||
self.dynamic_load(self.diffusion_model, 'diffusion_model')
|
||||
null_context['crossattn'] = get_model(
|
||||
self.diffusion_model).y_embedder.y_embedding[None].repeat(
|
||||
num_samples, 1, 1)
|
||||
self.dynamic_unload(self.diffusion_model, 'diffusion_model')
|
||||
self.dynamic_unload(self.cond_stage_model,
|
||||
'cond_stage_model',
|
||||
skip_loaded=True)
|
||||
|
||||
@@ -3,10 +3,8 @@
|
||||
import copy
|
||||
import random
|
||||
|
||||
import gradio as gr
|
||||
import torch
|
||||
import torch.nn.functional as F
|
||||
import torchvision.transforms.functional as TF
|
||||
|
||||
from scepter.modules.model.network.diffusion.diffusion import \
|
||||
GaussianDiffusionRF
|
||||
from scepter.modules.utils.distribute import we
|
||||
|
||||
@@ -13,10 +13,6 @@ try:
|
||||
from peft.utils import CONFIG_NAME, SAFETENSORS_WEIGHTS_NAME, WEIGHTS_NAME
|
||||
except Exception as e:
|
||||
warnings.warn(f'Import peft error, please deal with this problem: {e}')
|
||||
try:
|
||||
from swift import Swift, SwiftModel
|
||||
except Exception as e:
|
||||
warnings.warn(f'Import swift error, please deal with this problem: {e}')
|
||||
|
||||
|
||||
class TunerInference():
|
||||
@@ -27,12 +23,17 @@ class TunerInference():
|
||||
# @classmethod
|
||||
def unregister_tuner(self, tuner_model_list, diffusion_model,
|
||||
cond_stage_model):
|
||||
try:
|
||||
from swift import SwiftModel
|
||||
except Exception as e:
|
||||
warnings.warn(f'Import swift error, please deal with this problem: {e}')
|
||||
|
||||
self.logger.info('Unloading tuner model')
|
||||
if isinstance(diffusion_model['model'], SwiftModel):
|
||||
if diffusion_model is not None and isinstance(diffusion_model['model'], SwiftModel):
|
||||
for adapter_name in diffusion_model['model'].adapters:
|
||||
diffusion_model['model'].deactivate_adapter(adapter_name,
|
||||
offload='cpu')
|
||||
if isinstance(cond_stage_model['model'], SwiftModel):
|
||||
if cond_stage_model is not None and isinstance(cond_stage_model['model'], SwiftModel):
|
||||
for adapter_name in cond_stage_model['model'].adapters:
|
||||
cond_stage_model['model'].deactivate_adapter(adapter_name,
|
||||
offload='cpu')
|
||||
@@ -41,6 +42,11 @@ class TunerInference():
|
||||
# @classmethod
|
||||
def register_tuner(self, tuner_model_list, diffusion_model,
|
||||
cond_stage_model):
|
||||
try:
|
||||
from swift import Swift
|
||||
except Exception as e:
|
||||
warnings.warn(f'Import swift error, please deal with this problem: {e}')
|
||||
|
||||
self.logger.info('Loading tuner model')
|
||||
if len(tuner_model_list) < 1:
|
||||
self.unregister_tuner(tuner_model_list, diffusion_model,
|
||||
@@ -137,7 +143,10 @@ class TunerInference():
|
||||
state_dict = {}
|
||||
is_bin_file = True
|
||||
if os.path.isfile(bin_file):
|
||||
state_dict = torch.load(bin_file)
|
||||
if 'weights_only' in torch.load.__code__.co_varnames:
|
||||
state_dict = torch.load(bin_file, weights_only=True, map_location="cpu")
|
||||
else:
|
||||
state_dict = torch.load(bin_file, map_location="cpu")
|
||||
elif os.path.isfile(safe_file):
|
||||
is_bin_file = False
|
||||
from safetensors.torch import \
|
||||
|
||||
@@ -1,5 +1,23 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
from typing import TYPE_CHECKING
|
||||
from scepter.modules.utils.import_utils import LazyImportModule
|
||||
|
||||
from scepter.modules.model import (backbone, embedder, head, loss, metric,
|
||||
neck, network, tokenizer, tuner)
|
||||
|
||||
if TYPE_CHECKING:
|
||||
from scepter.modules.model import (backbone, embedder, head, loss, metric,
|
||||
neck, network, tokenizer, tuner, diffusion)
|
||||
else:
|
||||
_import_structure = {
|
||||
'model': ['backbone', 'embedder', 'head', 'loss', 'metric',
|
||||
'neck', 'network', 'tokenizer', 'tuner', 'diffusion']
|
||||
}
|
||||
|
||||
import sys
|
||||
sys.modules[__name__] = LazyImportModule(
|
||||
__name__,
|
||||
globals()['__file__'],
|
||||
_import_structure,
|
||||
module_spec=__spec__,
|
||||
extra_objects={},
|
||||
)
|
||||
|
||||
@@ -1,4 +1,23 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
from scepter.modules.model.backbone import (autoencoder, image, mmdit, pixart,
|
||||
unet, utils, video)
|
||||
from typing import TYPE_CHECKING
|
||||
from scepter.modules.utils.import_utils import LazyImportModule
|
||||
|
||||
|
||||
if TYPE_CHECKING:
|
||||
from scepter.modules.model.backbone import (ace, autoencoder, flux, image, cogvideox,
|
||||
mmdit, pixart, unet, utils, video)
|
||||
else:
|
||||
_import_structure = {
|
||||
'backbone': ['ace', 'autoencoder', 'flux', 'image', 'cogvideox',
|
||||
'mmdit', 'pixart', 'unet', 'utils', 'video']
|
||||
}
|
||||
|
||||
import sys
|
||||
sys.modules[__name__] = LazyImportModule(
|
||||
__name__,
|
||||
globals()['__file__'],
|
||||
_import_structure,
|
||||
module_spec=__spec__,
|
||||
extra_objects={},
|
||||
)
|
||||
|
||||
@@ -0,0 +1,3 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
from .ace import ACE
|
||||
@@ -0,0 +1,372 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
import re
|
||||
from collections import OrderedDict
|
||||
from functools import partial
|
||||
|
||||
import torch
|
||||
import torch.nn as nn
|
||||
from einops import rearrange
|
||||
from torch.nn.utils.rnn import pad_sequence
|
||||
from torch.utils.checkpoint import checkpoint_sequential
|
||||
|
||||
from scepter.modules.model.backbone.transformer.layers import (Mlp,
|
||||
T2IFinalLayer,
|
||||
TimestepEmbedder
|
||||
)
|
||||
from scepter.modules.model.backbone.transformer.patchify import PatchEmbed
|
||||
from scepter.modules.model.backbone.transformer.pos_embed import rope_params
|
||||
from scepter.modules.model.base_model import BaseModel
|
||||
from scepter.modules.model.registry import BACKBONES
|
||||
from scepter.modules.utils.config import dict_to_yaml
|
||||
from scepter.modules.utils.file_system import FS
|
||||
|
||||
from .layers import ACEBlock
|
||||
|
||||
|
||||
@BACKBONES.register_class()
|
||||
class ACE(BaseModel):
|
||||
|
||||
para_dict = {
|
||||
'PATCH_SIZE': {
|
||||
'value': 2,
|
||||
'description': ''
|
||||
},
|
||||
'IN_CHANNELS': {
|
||||
'value': 4,
|
||||
'description': ''
|
||||
},
|
||||
'HIDDEN_SIZE': {
|
||||
'value': 1152,
|
||||
'description': ''
|
||||
},
|
||||
'DEPTH': {
|
||||
'value': 28,
|
||||
'description': ''
|
||||
},
|
||||
'NUM_HEADS': {
|
||||
'value': 16,
|
||||
'description': ''
|
||||
},
|
||||
'MLP_RATIO': {
|
||||
'value': 4.0,
|
||||
'description': ''
|
||||
},
|
||||
'PRED_SIGMA': {
|
||||
'value': True,
|
||||
'description': ''
|
||||
},
|
||||
'DROP_PATH': {
|
||||
'value': 0.,
|
||||
'description': ''
|
||||
},
|
||||
'WINDOW_SIZE': {
|
||||
'value': 0,
|
||||
'description': ''
|
||||
},
|
||||
'WINDOW_BLOCK_INDEXES': {
|
||||
'value': None,
|
||||
'description': ''
|
||||
},
|
||||
'Y_CHANNELS': {
|
||||
'value': 4096,
|
||||
'description': ''
|
||||
},
|
||||
'ATTENTION_BACKEND': {
|
||||
'value': None,
|
||||
'description': ''
|
||||
},
|
||||
'QK_NORM': {
|
||||
'value': True,
|
||||
'description': 'Whether to use RMSNorm for query and key.',
|
||||
},
|
||||
}
|
||||
para_dict.update(BaseModel.para_dict)
|
||||
|
||||
def __init__(self, cfg, logger):
|
||||
super().__init__(cfg, logger=logger)
|
||||
self.window_block_indexes = cfg.get('WINDOW_BLOCK_INDEXES', None)
|
||||
if self.window_block_indexes is None:
|
||||
self.window_block_indexes = []
|
||||
self.pred_sigma = cfg.get('PRED_SIGMA', True)
|
||||
self.in_channels = cfg.get('IN_CHANNELS', 4)
|
||||
self.out_channels = self.in_channels * 2 if self.pred_sigma else self.in_channels
|
||||
self.patch_size = cfg.get('PATCH_SIZE', 2)
|
||||
self.num_heads = cfg.get('NUM_HEADS', 16)
|
||||
self.hidden_size = cfg.get('HIDDEN_SIZE', 1152)
|
||||
self.y_channels = cfg.get('Y_CHANNELS', 4096)
|
||||
self.drop_path = cfg.get('DROP_PATH', 0.)
|
||||
self.depth = cfg.get('DEPTH', 28)
|
||||
self.mlp_ratio = cfg.get('MLP_RATIO', 4.0)
|
||||
self.use_grad_checkpoint = cfg.get('USE_GRAD_CHECKPOINT', False)
|
||||
self.attention_backend = cfg.get('ATTENTION_BACKEND', None)
|
||||
self.max_seq_len = cfg.get('MAX_SEQ_LEN', 1024)
|
||||
self.qk_norm = cfg.get('QK_NORM', False)
|
||||
self.ignore_keys = cfg.get('IGNORE_KEYS', [])
|
||||
assert (self.hidden_size % self.num_heads
|
||||
) == 0 and (self.hidden_size // self.num_heads) % 2 == 0
|
||||
d = self.hidden_size // self.num_heads
|
||||
self.freqs = torch.cat(
|
||||
[
|
||||
rope_params(self.max_seq_len, d - 4 * (d // 6)), # T (~1/3)
|
||||
rope_params(self.max_seq_len, 2 * (d // 6)), # H (~1/3)
|
||||
rope_params(self.max_seq_len, 2 * (d // 6)) # W (~1/3)
|
||||
],
|
||||
dim=1)
|
||||
|
||||
# init embedder
|
||||
self.x_embedder = PatchEmbed(self.patch_size,
|
||||
self.in_channels + 1,
|
||||
self.hidden_size,
|
||||
bias=True,
|
||||
flatten=False)
|
||||
self.t_embedder = TimestepEmbedder(self.hidden_size)
|
||||
self.y_embedder = Mlp(in_features=self.y_channels,
|
||||
hidden_features=self.hidden_size,
|
||||
out_features=self.hidden_size,
|
||||
act_layer=lambda: nn.GELU(approximate='tanh'),
|
||||
drop=0)
|
||||
self.t_block = nn.Sequential(
|
||||
nn.SiLU(),
|
||||
nn.Linear(self.hidden_size, 6 * self.hidden_size, bias=True))
|
||||
# init blocks
|
||||
drop_path = [
|
||||
x.item() for x in torch.linspace(0, self.drop_path, self.depth)
|
||||
]
|
||||
self.blocks = nn.ModuleList([
|
||||
ACEBlock(self.hidden_size,
|
||||
self.num_heads,
|
||||
mlp_ratio=self.mlp_ratio,
|
||||
drop_path=drop_path[i],
|
||||
window_size=self.window_size
|
||||
if i in self.window_block_indexes else 0,
|
||||
backend=self.attention_backend,
|
||||
use_condition=True,
|
||||
qk_norm=self.qk_norm) for i in range(self.depth)
|
||||
])
|
||||
self.final_layer = T2IFinalLayer(self.hidden_size, self.patch_size,
|
||||
self.out_channels)
|
||||
self.initialize_weights()
|
||||
|
||||
def load_pretrained_model(self, pretrained_model):
|
||||
if pretrained_model:
|
||||
with FS.get_from(pretrained_model, wait_finish=True) as local_path:
|
||||
model = torch.load(local_path, map_location='cpu', weights_only=True)
|
||||
if 'state_dict' in model:
|
||||
model = model['state_dict']
|
||||
new_ckpt = OrderedDict()
|
||||
for k, v in model.items():
|
||||
if self.ignore_keys is not None:
|
||||
if (isinstance(self.ignore_keys, str) and re.match(self.ignore_keys, k)) or \
|
||||
(isinstance(self.ignore_keys, list) and k in self.ignore_keys):
|
||||
continue
|
||||
k = k.replace('.cross_attn.q_linear.', '.cross_attn.q.')
|
||||
k = k.replace('.cross_attn.proj.',
|
||||
'.cross_attn.o.').replace(
|
||||
'.attn.proj.', '.attn.o.')
|
||||
if '.cross_attn.kv_linear.' in k:
|
||||
k_p, v_p = torch.split(v, v.shape[0] // 2)
|
||||
new_ckpt[k.replace('.cross_attn.kv_linear.',
|
||||
'.cross_attn.k.')] = k_p
|
||||
new_ckpt[k.replace('.cross_attn.kv_linear.',
|
||||
'.cross_attn.v.')] = v_p
|
||||
elif '.attn.qkv.' in k:
|
||||
q_p, k_p, v_p = torch.split(v, v.shape[0] // 3)
|
||||
new_ckpt[k.replace('.attn.qkv.', '.attn.q.')] = q_p
|
||||
new_ckpt[k.replace('.attn.qkv.', '.attn.k.')] = k_p
|
||||
new_ckpt[k.replace('.attn.qkv.', '.attn.v.')] = v_p
|
||||
elif 'y_embedder.y_proj.' in k:
|
||||
new_ckpt[k.replace('y_embedder.y_proj.',
|
||||
'y_embedder.')] = v
|
||||
elif k in ('x_embedder.proj.weight'):
|
||||
model_p = self.state_dict()[k]
|
||||
if v.shape != model_p.shape:
|
||||
model_p.zero_()
|
||||
model_p[:, :4, :, :].copy_(v)
|
||||
new_ckpt[k] = torch.nn.parameter.Parameter(model_p)
|
||||
else:
|
||||
new_ckpt[k] = v
|
||||
elif k in ('x_embedder.proj.bias'):
|
||||
new_ckpt[k] = v
|
||||
else:
|
||||
new_ckpt[k] = v
|
||||
missing, unexpected = self.load_state_dict(new_ckpt,
|
||||
strict=False)
|
||||
print(
|
||||
f'Restored from {pretrained_model} with {len(missing)} missing and {len(unexpected)} unexpected keys'
|
||||
)
|
||||
if len(missing) > 0:
|
||||
print(f'Missing Keys:\n {missing}')
|
||||
if len(unexpected) > 0:
|
||||
print(f'\nUnexpected Keys:\n {unexpected}')
|
||||
|
||||
def forward(self,
|
||||
x,
|
||||
t=None,
|
||||
cond=dict(),
|
||||
mask=None,
|
||||
text_position_embeddings=None,
|
||||
gc_seg=-1,
|
||||
**kwargs):
|
||||
if self.freqs.device != x.device:
|
||||
self.freqs = self.freqs.to(x.device)
|
||||
if isinstance(cond, dict):
|
||||
context = cond.get('crossattn', None)
|
||||
else:
|
||||
context = cond
|
||||
if text_position_embeddings is not None:
|
||||
# default use the text_position_embeddings in state_dict
|
||||
# if state_dict doesn't including this key, use the arg: text_position_embeddings
|
||||
proj_position_embeddings = self.y_embedder(
|
||||
text_position_embeddings)
|
||||
else:
|
||||
proj_position_embeddings = None
|
||||
|
||||
ctx_batch, txt_lens = [], []
|
||||
if mask is not None and isinstance(mask, list):
|
||||
for ctx, ctx_mask in zip(context, mask):
|
||||
for frame_id, one_ctx in enumerate(zip(ctx, ctx_mask)):
|
||||
u, m = one_ctx
|
||||
t_len = m.flatten().sum() # l
|
||||
u = u[:t_len]
|
||||
u = self.y_embedder(u)
|
||||
if frame_id == 0:
|
||||
u = u + proj_position_embeddings[
|
||||
len(ctx) -
|
||||
1] if proj_position_embeddings is not None else u
|
||||
else:
|
||||
u = u + proj_position_embeddings[
|
||||
frame_id -
|
||||
1] if proj_position_embeddings is not None else u
|
||||
ctx_batch.append(u)
|
||||
txt_lens.append(t_len)
|
||||
else:
|
||||
raise TypeError
|
||||
y = torch.cat(ctx_batch, dim=0)
|
||||
txt_lens = torch.LongTensor(txt_lens).to(x.device, non_blocking=True)
|
||||
|
||||
batch_frames = []
|
||||
for u, shape, m in zip(x, cond['x_shapes'], cond['x_mask']):
|
||||
u = u[:, :shape[0] * shape[1]].view(-1, shape[0], shape[1])
|
||||
m = torch.ones_like(u[[0], :, :]) if m is None else m.squeeze(0)
|
||||
batch_frames.append([torch.cat([u, m], dim=0).unsqueeze(0)])
|
||||
if 'edit' in cond:
|
||||
for i, (edit, edit_mask) in enumerate(
|
||||
zip(cond['edit'], cond['edit_mask'])):
|
||||
if edit is None:
|
||||
continue
|
||||
for u, m in zip(edit, edit_mask):
|
||||
u = u.squeeze(0)
|
||||
m = torch.ones_like(
|
||||
u[[0], :, :]) if m is None else m.squeeze(0)
|
||||
batch_frames[i].append(
|
||||
torch.cat([u, m], dim=0).unsqueeze(0))
|
||||
|
||||
patch_batch, shape_batch, self_x_len, cross_x_len = [], [], [], []
|
||||
for frames in batch_frames:
|
||||
patches, patch_shapes = [], []
|
||||
self_x_len.append(0)
|
||||
for frame_id, u in enumerate(frames):
|
||||
u = self.x_embedder(u)
|
||||
h, w = u.size(2), u.size(3)
|
||||
u = rearrange(u, '1 c h w -> (h w) c')
|
||||
if frame_id == 0:
|
||||
u = u + proj_position_embeddings[
|
||||
len(frames) -
|
||||
1] if proj_position_embeddings is not None else u
|
||||
else:
|
||||
u = u + proj_position_embeddings[
|
||||
frame_id -
|
||||
1] if proj_position_embeddings is not None else u
|
||||
patches.append(u)
|
||||
patch_shapes.append([h, w])
|
||||
cross_x_len.append(h * w) # b*s, 1
|
||||
self_x_len[-1] += h * w # b, 1
|
||||
# u = torch.cat(patches, dim=0)
|
||||
patch_batch.extend(patches)
|
||||
shape_batch.append(
|
||||
torch.LongTensor(patch_shapes).to(x.device, non_blocking=True))
|
||||
# repeat t to align with x
|
||||
t = torch.cat([t[i].repeat(l) for i, l in enumerate(self_x_len)])
|
||||
self_x_len, cross_x_len = (torch.LongTensor(self_x_len).to(
|
||||
x.device, non_blocking=True), torch.LongTensor(cross_x_len).to(
|
||||
x.device, non_blocking=True))
|
||||
# x = pad_sequence(tuple(patch_batch), batch_first=True) # b, s*max(cl), c
|
||||
x = torch.cat(patch_batch, dim=0)
|
||||
x_shapes = pad_sequence(tuple(shape_batch),
|
||||
batch_first=True) # b, max(len(frames)), 2
|
||||
t = self.t_embedder(t) # (N, D)
|
||||
t0 = self.t_block(t)
|
||||
# y = self.y_embedder(context)
|
||||
|
||||
kwargs = dict(y=y,
|
||||
t=t0,
|
||||
x_shapes=x_shapes,
|
||||
self_x_len=self_x_len,
|
||||
cross_x_len=cross_x_len,
|
||||
freqs=self.freqs,
|
||||
txt_lens=txt_lens)
|
||||
if self.use_grad_checkpoint and gc_seg >= 0:
|
||||
x = checkpoint_sequential(
|
||||
functions=[partial(block, **kwargs) for block in self.blocks],
|
||||
segments=gc_seg if gc_seg > 0 else len(self.blocks),
|
||||
input=x,
|
||||
use_reentrant=False)
|
||||
else:
|
||||
for block in self.blocks:
|
||||
x = block(x, **kwargs)
|
||||
x = self.final_layer(x, t) # b*s*n, d
|
||||
outs, cur_length = [], 0
|
||||
p = self.patch_size
|
||||
for seq_length, shape in zip(self_x_len, shape_batch):
|
||||
x_i = x[cur_length:cur_length + seq_length]
|
||||
h, w = shape[0].tolist()
|
||||
u = x_i[:h * w].view(h, w, p, p, -1)
|
||||
u = rearrange(u, 'h w p q c -> (h p w q) c'
|
||||
) # dump into sequence for following tensor ops
|
||||
cur_length = cur_length + seq_length
|
||||
outs.append(u)
|
||||
x = pad_sequence(tuple(outs), batch_first=True).permute(0, 2, 1)
|
||||
if self.pred_sigma:
|
||||
return x.chunk(2, dim=1)[0]
|
||||
else:
|
||||
return x
|
||||
|
||||
def initialize_weights(self):
|
||||
# Initialize transformer layers:
|
||||
def _basic_init(module):
|
||||
if isinstance(module, nn.Linear):
|
||||
torch.nn.init.xavier_uniform_(module.weight)
|
||||
if module.bias is not None:
|
||||
nn.init.constant_(module.bias, 0)
|
||||
|
||||
self.apply(_basic_init)
|
||||
# Initialize patch_embed like nn.Linear (instead of nn.Conv2d):
|
||||
w = self.x_embedder.proj.weight.data
|
||||
nn.init.xavier_uniform_(w.view([w.shape[0], -1]))
|
||||
# Initialize timestep embedding MLP:
|
||||
nn.init.normal_(self.t_embedder.mlp[0].weight, std=0.02)
|
||||
nn.init.normal_(self.t_embedder.mlp[2].weight, std=0.02)
|
||||
nn.init.normal_(self.t_block[1].weight, std=0.02)
|
||||
# Initialize caption embedding MLP:
|
||||
if hasattr(self, 'y_embedder'):
|
||||
nn.init.normal_(self.y_embedder.fc1.weight, std=0.02)
|
||||
nn.init.normal_(self.y_embedder.fc2.weight, std=0.02)
|
||||
# Zero-out adaLN modulation layers
|
||||
for block in self.blocks:
|
||||
nn.init.constant_(block.cross_attn.o.weight, 0)
|
||||
nn.init.constant_(block.cross_attn.o.bias, 0)
|
||||
# Zero-out output layers:
|
||||
nn.init.constant_(self.final_layer.linear.weight, 0)
|
||||
nn.init.constant_(self.final_layer.linear.bias, 0)
|
||||
|
||||
@property
|
||||
def dtype(self):
|
||||
return next(self.parameters()).dtype
|
||||
|
||||
@staticmethod
|
||||
def get_config_template():
|
||||
return dict_to_yaml('BACKBONE',
|
||||
__class__.__name__,
|
||||
ACE.para_dict,
|
||||
set_name=True)
|
||||
@@ -0,0 +1,205 @@
|
||||
# -*- coding: utf-8 -*-
|
||||
# Copyright (c) Alibaba, Inc. and its affiliates.
|
||||
import math
|
||||
import warnings
|
||||
|
||||
import torch
|
||||
import torch.nn as nn
|
||||
|
||||
from scepter.modules.model.backbone.transformer.attention import RMSNorm
|
||||
from scepter.modules.model.backbone.transformer.layers import (DropPath, Mlp,
|
||||
modulate)
|
||||
from scepter.modules.model.backbone.transformer.pos_embed import \
|
||||
rope_apply_multires as rope_apply
|
||||
|
||||
try:
|
||||
from flash_attn import (flash_attn_varlen_func)
|
||||
FLASHATTN_IS_AVAILABLE = True
|
||||
except ImportError as e:
|
||||
FLASHATTN_IS_AVAILABLE = False
|
||||
flash_attn_varlen_func = None
|
||||
warnings.warn(f'{e}')
|
||||
|
||||
|
||||
class ACEBlock(nn.Module):
|
||||
def __init__(self,
|
||||
hidden_size,
|
||||
num_heads,
|
||||
mlp_ratio=4.0,
|
||||
drop_path=0.,
|
||||
window_size=0,
|
||||
backend=None,
|
||||
use_condition=True,
|
||||
qk_norm=False,
|
||||
**block_kwargs):
|
||||
super().__init__()
|
||||
self.hidden_size = hidden_size
|
||||
self.use_condition = use_condition
|
||||
self.norm1 = nn.LayerNorm(hidden_size,
|
||||
elementwise_affine=False,
|
||||
eps=1e-6)
|
||||
self.attn = MultiHeadAttention(hidden_size,
|
||||
num_heads=num_heads,
|
||||
qkv_bias=True,
|
||||
backend=backend,
|
||||
qk_norm=qk_norm,
|
||||
**block_kwargs)
|
||||
if self.use_condition:
|
||||
self.cross_attn = MultiHeadAttention(hidden_size,
|
||||
context_dim=hidden_size,
|
||||
num_heads=num_heads,
|
||||
qkv_bias=True,
|
||||
backend=backend,
|
||||
qk_norm=qk_norm,
|
||||
**block_kwargs)
|
||||
self.norm2 = nn.LayerNorm(hidden_size,
|
||||
elementwise_affine=False,
|
||||
eps=1e-6)
|
||||
# to be compatible with lower version pytorch
|
||||
approx_gelu = lambda: nn.GELU(approximate='tanh')
|
||||
self.mlp = Mlp(in_features=hidden_size,
|
||||
hidden_features=int(hidden_size * mlp_ratio),
|
||||
act_layer=approx_gelu,
|
||||
drop=0)
|
||||
self.drop_path = DropPath(
|
||||
drop_path) if drop_path > 0. else nn.Identity()
|
||||
self.window_size = window_size
|
||||
self.scale_shift_table = nn.Parameter(
|
||||
torch.randn(6, hidden_size) / hidden_size**0.5)
|
||||
|
||||
def forward(self, x, y, t, **kwargs):
|
||||
B = x.size(0)
|
||||
shift_msa, scale_msa, gate_msa, shift_mlp, scale_mlp, gate_mlp = (
|
||||
self.scale_shift_table[None] + t.reshape(B, 6, -1)).chunk(6, dim=1)
|
||||
shift_msa, scale_msa, gate_msa, shift_mlp, scale_mlp, gate_mlp = (
|
||||
shift_msa.squeeze(1), scale_msa.squeeze(1), gate_msa.squeeze(1),
|
||||
shift_mlp.squeeze(1), scale_mlp.squeeze(1), gate_mlp.squeeze(1))
|
||||
x = x + self.drop_path(gate_msa * self.attn(
|
||||
modulate(self.norm1(x), shift_msa, scale_msa, unsqueeze=False), **
|
||||
kwargs))
|
||||
if self.use_condition:
|
||||
x = x + self.cross_attn(x, context=y, **kwargs)
|
||||
|
||||
x = x + self.drop_path(gate_mlp * self.mlp(
|
||||
modulate(self.norm2(x), shift_mlp, scale_mlp, unsqueeze=False)))
|
||||
return x
|
||||
|
||||
|
||||
class MultiHeadAttention(nn.Module):
|
||||
def __init__(self,
|
||||
dim,
|
||||
context_dim=None,
|
||||
num_heads=None,
|
||||
head_dim=None,
|
||||
attn_drop=0.0,
|
||||
qkv_bias=False,
|
||||
dropout=0.0,
|
||||
backend=None,
|
||||
qk_norm=False,
|
||||
eps=1e-6,
|
||||
**block_kwargs):
|
||||
super().__init__()
|
||||
# consider head_dim first, then num_heads
|
||||
num_heads = dim // head_dim if head_dim else num_heads
|
||||
head_dim = dim // num_heads
|
||||
assert num_heads * head_dim == dim
|
||||
context_dim = context_dim or dim
|
||||
self.dim = dim
|
||||
self.context_dim = context_dim
|
||||
self.num_heads = num_heads
|
||||
self.head_dim = head_dim
|
||||
self.scale = math.pow(head_dim, -0.25)
|
||||
# layers
|
||||
self.q = nn.Linear(dim, dim, bias=qkv_bias)
|
||||
self.k = nn.Linear(context_dim, dim, bias=qkv_bias)
|
||||
self.v = nn.Linear(context_dim, dim, bias=qkv_bias)
|
||||
self.o = nn.Linear(dim, dim)
|
||||
self.norm_q = RMSNorm(dim, eps=eps) if qk_norm else nn.Identity()
|
||||
self.norm_k = RMSNorm(dim, eps=eps) if qk_norm else nn.Identity()
|
||||
|
||||
self.dropout = nn.Dropout(dropout)
|
||||
self.attention_op = None
|
||||
self.attn_drop = nn.Dropout(attn_drop)
|
||||
self.backend = backend
|
||||
assert self.backend in ('flash_attn', 'xformer_attn', 'pytorch_attn',
|
||||
None)
|
||||
if FLASHATTN_IS_AVAILABLE and self.backend in ('flash_attn', None):
|
||||
self.backend = 'flash_attn'
|
||||
self.softmax_scale = block_kwargs.get('softmax_scale', None)
|
||||
self.causal = block_kwargs.get('causal', False)
|
||||
self.window_size = block_kwargs.get('window_size', (-1, -1))
|
||||
self.deterministic = block_kwargs.get('deterministic', False)
|
||||
else:
|
||||
raise NotImplementedError
|
||||
|
||||
def flash_attn(self, x, context=None, **kwargs):
|
||||
'''
|
||||
The implementation will be very slow when mask is not None,
|
||||
because we need rearange the x/context features according to mask.
|
||||
Args:
|
||||
x:
|
||||
context:
|
||||
mask:
|
||||
**kwargs:
|
||||
Returns: x
|
||||
'''
|
||||
dtype = kwargs.get('dtype', torch.float16)
|
||||
|
||||
def half(x):
|
||||
return x if x.dtype in [torch.float16, torch.bfloat16
|
||||
] else x.to(dtype)
|
||||
|
||||
x_shapes = kwargs['x_shapes']
|
||||
freqs = kwargs['freqs']
|
||||
self_x_len = kwargs['self_x_len']
|
||||
cross_x_len = kwargs['cross_x_len']
|
||||
txt_lens = kwargs['txt_lens']
|
||||
n, d = self.num_heads, self.head_dim
|
||||
|
||||
if context is None:
|
||||
# self-attn
|
||||
q = self.norm_q(self.q(x)).view(-1, n, d)
|
||||
k = self.norm_q(self.k(x)).view(-1, n, d)
|
||||
v = self.v(x).view(-1, n, d)
|
||||
q = rope_apply(q, self_x_len, x_shapes, freqs, pad=False)
|
||||
k = rope_apply(k, self_x_len, x_shapes, freqs, pad=False)
|
||||
q_lens = k_lens = self_x_len
|
||||
else:
|
||||
# cross-attn
|
||||
q = self.norm_q(self.q(x)).view(-1, n, d)
|
||||
k = self.norm_q(self.k(context)).view(-1, n, d)
|
||||
v = self.v(context).view(-1, n, d)
|
||||
q_lens = cross_x_len
|
||||
k_lens = txt_lens
|
||||
|
||||
cu_seqlens_q = torch.cat([q_lens.new_zeros([1]),
|
||||
q_lens]).cumsum(0, dtype=torch.int32)
|
||||
cu_seqlens_k = torch.cat([k_lens.new_zeros([1]),
|
||||
k_lens]).cumsum(0, dtype=torch.int32)
|
||||
max_seqlen_q = q_lens.max()
|
||||
max_seqlen_k = k_lens.max()
|
||||
|
||||
out_dtype = q.dtype
|
||||
q, k, v = half(q), half(k), half(v)
|
||||
x = flash_attn_varlen_func(q,
|
||||
k,
|
||||
v,
|
||||
cu_seqlens_q=cu_seqlens_q,
|
||||
cu_seqlens_k=cu_seqlens_k,
|
||||
max_seqlen_q=max_seqlen_q,
|
||||
max_seqlen_k=max_seqlen_k,
|
||||
dropout_p=self.attn_drop.p,
|
||||
softmax_scale=self.softmax_scale,
|
||||
causal=self.causal,
|
||||
window_size=self.window_size,
|
||||
deterministic=self.deterministic)
|
||||
|
||||
x = x.type(out_dtype)
|
||||
x = x.reshape(-1, n * d)
|
||||
x = self.o(x)
|
||||
x = self.dropout(x)
|
||||
return x
|
||||
|
||||
def forward(self, x, context=None, **kwargs):
|
||||
x = getattr(self, self.backend)(x, context=context, **kwargs)
|
||||
return x
|
||||